本页为社区译文;如有疑义,请以英文原文为准。

Frida 17.23.0 发布

这个版本允许宿主向 pattern 传入预处理器宏,修复了我在把 pattern 接入即将推出的 Luma 时遇到的一批 pattern 语言边界问题,并且感谢 @pandasauce,缩小了在 arm64 Linux 和 Android 上执行 hook 时的竞态窗口。Windows 方面也有修复:@tshivaneshk 修复了导入枚举,此外还为 Windows 9x 修复了一批 Barebone 问题。

宏定义

pattern 经常需要知道自己的数据来自哪里。磁盘上的文件格式会内联存放有效载荷,但当同一格式映射到内存后,头部后面跟随的可能变成一个指针。ImHex pattern 使用预处理器处理这类情况,现在我们的 pattern 也可以了:PatternCompiler 接受一个 defines 字典,其行为相当于在入口点顶部添加 #define。假设有一个 image.hexpat:

#pragma abi native

struct Header {
    u32 magic;
    u32 size;
};

struct Image {
    Header header;
#ifdef MAPPED
    u64 base;
#else
    u8 payload[header.size];
#endif
};

分别在定义和不定义 MAPPED 的情况下编译,同一份源码会产生两种不同的布局:

import frida

compiler = frida.PatternCompiler()

for defines in (None, {"MAPPED": 1}):
    options = {"platform": "darwin", "arch": "arm64"}
    if defines is not None:
        options["defines"] = defines
    module = compiler.compile("image.hexpat", **options)
    image = module.lookup("Image")
    fields = [(f.name, f.type_ref.display) for f in image.fields]
    print(f"defines={defines}: {fields}, size={image.size}")
defines=None: [('header', 'Header'), ('payload', 'u8[...]')], size=-1
defines={'MAPPED': 1}: [('header', 'Header'), ('base', 'u64')], size=16

宏定义会随模块一起传递,因此解码和 call_function() 看到的预处理器状态与编译时完全相同。语言服务器会在 workspace/didChangeConfiguration 时从 settings.patterns.defines 获取宏定义,使编辑器的诊断结果可以与宿主编译 pattern 的方式保持同步。正因如此,Luma 才能告诉 pattern 它正在解码文件还是已映射的镜像,而 pattern 无需了解任何 Luma 相关细节。

除此之外,我们用即将推出的 Luma 对真实世界的 pattern 进行了一周测试,暴露出实现中围绕模板、ref 参数、枚举名称和 array_index() 的一些边界情况。本版本已全部修复,详细内容见下方变更日志。

arm64 Linux 上的 Interceptor

Georgi Boiko(@pandasauce)追踪到了 Android 上的崩溃问题。它源于 arm64 重定向与线程之间的相互作用:这些线程恰好暂停在正在被 hook 的函数内部。在 arm64 上,默认 hook 会使用 ADRP+BR 或 LDR+BR+字面量序列重写函数开头的 16 字节;暂停在第一条指令之后任意位置的线程,恢复后可能进入只完成了一半修补的函数序言。

现在,对于至少有八个可重定位字节的默认 hook,Interceptor 会尝试在 Linux 和 Android 上于 B 指令可达范围内为 trampoline 寻找一个 slice,使重定向只需一条 B 指令。暂停的线程随后会从未经改动的原始字节恢复,而补丁本身只需一次对齐写入。恢复重定向也只需一次写入。为了更频繁地提供这样的邻近 slice,当完整的七页批次无法放入目标附近的空闲空间时,代码分配器现在会用单页重试邻近分配。

Arm 架构参考手册仍指出:当另一个核心可能正在执行某条任意指令时,用分支替换它的行为不可预测。因此,这项改动只是缩小了竞态窗口,并未彻底消除它,但实践中效果非常明显。还有一个需要注意的取舍:原本会使用 16 字节重定向的 hook,现在会更快耗尽目标附近的空间;而对于只有一条指令长的函数,由于其他方案都放不下,这些空间是执行 hook 的唯一选择。非常感谢 Georgi!

Windows

@tshivaneshk 注意到,Windows 上的 Module.enumerateImports() 会把每个导入的槽位都报告为 IAT 基址,并在导入模块中查找每个地址,而不是从 IAT 读取。现在它会在遍历查找表的同时遍历 IAT,报告每个条目及其绑定值;我们的测试也会检查报告的地址。感谢!

此外,Process.id 现在会在 QuickJS 中保持无符号。Windows 9x 会分配大于 2^31 的进程 ID,此前这些值在 JavaScript 运行时中会变成负数。

Barebone

说到 Windows 9x,我们使用 Barebone 后端与 Explorer 等程序进行的几次会话,暴露出注入用户进程的 agent 中存在五个错误:从模块加载破坏已退出线程的记录,到分离超时并导致客户机蓝屏。现已全部修复,详情见变更日志。

EOF

尽情使用吧!

变更日志

  • patterns:允许宿主通过 PatternCompileOptions.defines 定义预处理器宏,并将其传递到解码和调用过程;语言服务器则通过 settings.patterns.defines 接收。(上文已介绍。)
  • patterns:模板嵌套实例化达到 64 层后,报告无限模板递归。
  • patterns:将 pattern 传给 ref 参数,使格式化位域或结构体的函数能够找到其成员。
  • patterns:按名称查找模板局部变量和字段作为后备方案,用于多个外层类型共享的模板。
  • patterns:支持在元素内部调用 array_index()。
  • patterns:通过成员访问时保留枚举名称,并允许 formatted_value() 格式化标量和位域。
  • interceptor:当 B 指令范围内存在可用 slice 时,在 arm64 Linux 和 Android 上使用 4 字节重定向。感谢 @pandasauce!
  • codeallocator:在 Linux 和 Android 上用单页重试邻近批次分配。感谢 @pandasauce!
  • windows:修复导入槽位和地址。感谢 @tshivaneshk!
  • gumjs:在 QuickJS 中保持 Process.id 为无符号值。
  • barebone:修复注入用户进程的 agent 中五个 Windows 9x 问题:模块加载破坏已退出线程的记录;主线程停驻在后续注入可能复用的内存中;启动栈泄漏;工作线程从未被唤醒导致分离超时;换出内存上的故障未交还 Windows 处理。
  • swift:为 PatternCompiler.compile() 添加 defines。
  • subprojects:回退 termux-elf-cleaner 升级,因为其新代码需要 C++20,而宿主工具构建并未使用 C++20。

Frida 17.22.2 发布

这是一次快速跟进发布,用于修复 17.22.1 中的一项回归,以及期间合入的另外几个问题。

我们在 17.22.1 中为 glibc 添加的栈丢弃逻辑,假定每个正在退出的线程都是由我们设置的。GLib 仅仅接管的线程——例如外部 pthread 调用 GLib 时——退出时仍会执行 finalize,但从未经过 realize,因此栈丢弃逻辑会解引用 NULL,并让进程随之崩溃。一个 frida-node 使用方在完成附加、加载脚本并退出后会死于 SIGSEGV;长时间运行的测试中,只要其中一个此类线程在运行途中退出,也会发生同样的问题。@hsorbo 修复了这个问题:没有可供处理的基础数据时跳过栈丢弃,并添加了一个测试,用于接管外部线程并让其退出。

Håvard 还修复了 QuickJS 分支中一个长期存在的问题。当循环收集器释放对象时,会释放所有以该对象为键的 WeakMap 条目值。这些值是扫描后仍存活的对象;如果这种释放使其中某个对象的引用计数降为零,它会因为运行时正忙于移除循环而被忽略,此后也不会再得到处理。它会以零引用计数一直留到运行时销毁,此时其终结器可能访问已经不存在的状态。现在,这类对象会收集到延迟列表中,并在循环移除结束后释放,与其他引用计数降为零的对象相同。

最后,@mbv06 注意到新版 ART 会把启动镜像的 methods 节复制到自己的 memfd 映射,因此 Android 启动支持现在还会在 boot-image-methods.art 中查找 setArgV0() JNI 槽位。

尽情使用吧!

变更日志

  • glibc:对接管的线程跳过栈丢弃,修复 17.22.1 引入的线程退出崩溃。感谢 @hsorbo!
  • quickjs:释放移除循环期间被释放的存活对象,使循环收集过程中通过 WeakMap 条目释放的值能够运行终结器,而不会一直残留到运行时销毁。感谢 @hsorbo!
  • android:在 boot-image-methods.art 中扫描 setArgV0() JNI 槽位,因为新版 ART 会单独映射启动镜像的 methods 节。感谢 @mbv06!

Frida 17.22.1 发布

这是一个错误修复版本,其中大多数修复由 @hsorbo 完成,另有一位新贡献者让 C++ 绑定变得更完整。

内存扫描找到自身

Håvard 注意到,Linux 上的指针扫描可能会在一个已不再被任何线程使用的栈中找到它正在寻找的那些值。扫描工作线程会把搜索值溢出到自己的栈上;当线程池被释放、额外工作线程退出后,glibc 会保留这些栈以供复用,而退出栈帧之上的所有内容仍保持映射且可读。延迟清理逻辑取消隐藏这些区域后,下一次扫描就会愉快地找到自己留下的残余。任何曾在线程调度器的线程池上运行的内容也同样如此。

修复方法是在 Gum 线程退出时立即丢弃它溢出到栈上的内容。这项操作由 frida-glib 在线程自身执行的 finalize 回调完成,发生在线程库缓存该栈之前。其他 libc 会直接取消映射已退出线程的栈,因此只有 glibc 需要承担这次额外系统调用的开销。

其他修复

Håvard 还修复了另外两个 Linux 相关问题。当最后一个监听器的分离仍待处理时再次对函数插桩——GumJS 在脚本级事务中正是这样做的——可能会把过时的重定向解析到一个 trampoline,而后者随后会随旧上下文一同释放。现在该函数会被视为仍处于插桩状态;如果新旧插桩均为默认类型,就复用其上下文,否则立即将其停用。此外,对由 dlopen() 作为依赖项引入的模块调用 dlsym() 时不再崩溃;此前 glibc 尚未为我们用作句柄的 link map 计算局部作用域。

最后同样重要的是,@mnalmahmud 通过新的 ProbeListener 接口,让 C++ 绑定可以把探针附加到任意指令,因此不再需要降级使用 C API。

尽情使用吧!

变更日志

  • glibc:线程退出时丢弃已终止 Gum 线程的栈,使内存扫描不再找到扫描工作线程或脚本调度器线程池留下的残余。感谢 @hsorbo 追踪到这个问题!
  • interceptor:修复等待分离期间重新附加的问题;该问题可能把过时的重定向解析到随后被释放的 trampoline。感谢 @hsorbo!
  • linux:通过使用 RTLD_NOLOAD 按需创建句柄,修复在 dlopen() 以依赖项形式发现的模块上调用 dlsym() 时的崩溃。感谢 @hsorbo!
  • gumpp:添加探针监听器支持,把 gum_make_probe_listener() 公开为 ProbeListener 接口,并允许 Interceptor::attach() 和 detach() 接受它。感谢 @mnalmahmud!
  • frida-compile:按需创建输出文件目录,frida-tools 和 npm 软件包均适用。感谢 @fourcels!

Frida 17.22.0 发布

昨天的两个版本让 pattern 成为 Agent 和工具中的一等公民。本次发布着重于共享:frida-compile 现在可以构建库,因此 npm 包能够把 pattern 与 TypeScript 一同发布,任何人都可导入使用。还要感谢 @hsorbo,Swift ApiResolver 现已能在 Linux 上运行,Windows 支持也紧随其后。

库

假设你编写了一些 pattern 及其辅助函数,并希望发布给其他 Agent 使用。此前必须先运行一次 frida-compile 获取 pattern 类型定义,再用 tsc 生成包,同时还要仔细配置 tsconfig.json,使其与 Frida.Compiler 解析导入的方式一致。对同一份源码运行两个编译器实在多余。

使用 frida-compile –library 后,Frida.Compiler 会完成全部工作。下面是一个在游戏中查找玩家的包中的 lib/index.ts:

import { Player } from "./patterns/player.hexpat";

export function findPlayers(range: RangeDetails, health: number): Player[] {
    const pattern = Player.pattern({ health });
    return Memory.scanSync(range.base, range.size, pattern)
        .map(({ address }) => Player.at(address));
}

export function describe(player: Player): string {
    const { x, y, z } = player.position;
    return `health=${player.health} lives=${player.lives} at (${x}, ${y}, ${z})`;
}

旁边是 lib/patterns/player.hexpat:

#pragma abi native

struct Player {
    u32 health;
    u32 lives;
    Vec3 position;
};

struct Vec3 {
    float x;
    float y;
    float z;
};

源码就只有这些。package.json 不需要 typescript、@types/frida-gum 或 tsconfig.json,只需 npm 上的 frida-compile:

{
  "name": "frida-module-example",
  "version": "1.1.0",
  "main": "./dist/index.js",
  "types": "./dist/index.d.ts",
  "files": ["/dist"],
  "type": "module",
  "scripts": {
    "prepare": "frida-compile --library lib/index.ts -o dist"
  },
  "devDependencies": {
    "frida-compile": "^19.1.0"
  }
}

执行构建后得到:

$ frida-compile --library lib/index.ts -o dist
$ find dist -type f | sort
dist/index.d.ts
dist/index.js
dist/index.js.map
dist/patterns/player.hexpat
dist/patterns/player.hexpat.d.ts

每个源文件对应一个模块和一个声明文件,pattern 会一并复制,其生成的类型定义也放在旁边。声明内容正如你所期待:

import { Player } from "./patterns/player.hexpat";
export declare function findPlayers(range: RangeDetails, health: number): Player[];
export declare function describe(player: Player): string;

请注意,pattern 以源码形式发布,而不是 Frida.Compiler 转换后的 JavaScript。这是有意为之:生成的代码依赖使用方构建所提供的运行时,并可跨包去重;其他 pattern 以及 Luma 等工具也能导入它;而且 pattern 语言比我们生成的代码稳定得多。使用方的 Frida.Compiler 会在构建过程中用几毫秒完成编译,并缓存结果。

接下来看看使用方。执行 npm install frida-module-example 后,Agent 既可使用辅助函数,也可直接使用 pattern:

import { findPlayers, describe } from "frida-module-example";
import { Player } from "frida-module-example/dist/patterns/player.hexpat";

const arena = Memory.alloc(Player.size * 2);
const alice = Player.at(arena);
alice.health = 100;
alice.lives = 3;
alice.position.z = 1.5;

for (const player of findPlayers({ base: arena, size: Player.size * 2 } as RangeDetails, 100))
  console.log(describe(player));
$ frida -q -p 0 -l agent.ts
health=100 lives=3 at (0, 0, 1.5)

再补充一些细节:

  • -w 会在编辑时持续更新库;同时迭代包和应用时,它与 npm link 配合得很好。
  • source map 会生成在各模块旁边,并内联源码,因此无需发布 lib/,使用方也能获得真实的堆栈跟踪。传入 -S 可不生成它们。
  • 错误报告方式与 Agent 构建相同,路径相对于项目;只要存在错误,就不会写入任何内容:
lib/broken.ts:1:14 - error TS2322: Type 'string' is not assignable to type 'number'.
compilation failed
  • 输出会在公共目录下镜像源码树,因此 lib/index.ts 会生成到 dist/index.js。如果 tsconfig.json 设置了 rootDir,则会遵循该设置。
  • 此功能对应 frida-core 中的 Compiler.build_library() 和 Compiler.watch_library(),因此所有语言绑定都可使用;frida-compile 则同时在 frida-tools 和 npm 包中公开它。

Swift

Swift ApiResolver 昨天刚获得查找类型、协议及其遵循关系的能力,但此前只能在 Apple 平台工作。它会查找 libswiftCore.dylib,从 libsystem_malloc 借用 free(),并按 Mach-O 名称匹配元数据节,因此 Linux 上的每次查询都会以“unsupported Swift runtime”失败。

Håvard 修复了所有这些问题:解析器现在按平台确定 Swift 核心库和元数据节名称;没有 libsystem_malloc 时,从 C 运行时获取 free();还为每个实例分别保存名称还原器,因为 Linux 上的 dlclose() 会取消映射 libswiftCore,缓存的指针可能比它存活更久。他还让 Swift 测试真正运行在 Linux CI 上——此前它们一直被静默跳过——并将跳过正确报告为跳过,而不是通过。非常感谢 Håvard!

有了这些基础,Windows 支持只是很小的一步:使用 swiftCore.dll、.sw5* 节,并通过 UCRT 释放还原后的名称。Windows 有个值得注意的特点:swiftrt.obj 会在每个元数据节两端放置清零的起止标记,解析器现在会跳过它们。因此,只要加载了 Swift 运行时,new ApiResolver(‘swift’) 及其 functions:、types:、protocols: 和 conformances: 查询在各平台都能以相同方式工作。

结语

尽情体验吧!

变更日志

  • compiler:通过 Compiler.build_library() 和 Compiler.watch_library() 新增库构建,并以 frida-compile –library 公开。(上文已介绍。)
  • swift-api-resolver:新增 Linux 支持,按平台确定 Swift 核心库和元数据节名称,并为每个解析器实例保存名称还原器。感谢 @hsorbo!
  • swift-api-resolver:新增 Windows 支持,包括跳过 swiftrt.obj 生成的清零节标记。
  • swift-api-resolver:在测试中查找 Swift 工具链,使其在 GitHub 的 Ubuntu runner 上真正运行,而不是静默跳过。感谢 @hsorbo!
  • gumjs:解析指令操作数时处理所有 arm64 向量排列。v0.b[0] 等单通道和窄排列此前会进入不可达的默认分支;编译时移除断言后会导致进程崩溃。感谢 @hsorbo!
  • windows:修复节名称和大小。恰好八个字符的名称没有 NUL 终止符;大小现在使用加载器所见的虚拟大小,而不是按文件对齐的原始大小。
  • swift:为库构建重新生成绑定。

Frida 17.21.0 发布

一天发布两个版本?软件开发很难,API 设计更难。但这次值得:@hsorbo 让 Swift ApiResolver 学会查找类型、协议和协议遵循关系;新的 PatternCompiler API 也重塑为基于文件工作,使 pattern 在主机端也能相互导入。

Swift

Frida 的 ApiResolver(‘swift’) 已推出一段时间,可用 glob 按还原后的名称查找 Swift 函数。它在幕后遍历编译器写入每个 Swift 二进制文件的 Swift 元数据,类型和协议信息也存放在那里。Håvard 从 2023 年起持续改进这个解析器;在 17.20.0 中,他改用运行 Swift 代码时始终存在的 libswiftCore 来还原名称,而不是通常不存在的 libswiftDemangle,使其可在更多进程中工作。

在此基础上,本版本新增三类查询。首先,types: 和 protocols: 按完整名称匹配名义类型和协议,并返回上下文描述符的地址:

const resolver = new ApiResolver('swift');

for (const { name, address } of resolver.enumerateMatches('types:*!Swift.Int'))
  console.log(name, address);

for (const { name, address } of resolver.enumerateMatches('protocols:*!Swift.Hashable'))
  console.log(name, address);
/usr/lib/swift/libswiftCore.dylib!Swift.Int 0x19bf8009c
/usr/lib/swift/libswiftCore.dylib!Swift.Hashable 0x19bf7c490

与其他解析器一样,! 前面的部分匹配模块,因此 types:*libswiftCore*!Swift.Dictionary* 可将范围缩小到特定库,并查找嵌套类型:

/usr/lib/swift/libswiftCore.dylib!Swift.Dictionary 0x19bf7abe8
/usr/lib/swift/libswiftCore.dylib!Swift.Dictionary.Keys 0x19bf7ac54
/usr/lib/swift/libswiftCore.dylib!Swift.Dictionary.Values 0x19bf7ac90
/usr/lib/swift/libswiftCore.dylib!Swift.Dictionary.Keys.Iterator 0x19bf7accc
/usr/lib/swift/libswiftCore.dylib!Swift.Dictionary.Values.Iterator 0x19bf7ad08

其次,conformances: 按类型名和协议名匹配协议遵循关系,并返回遵循关系描述符的地址。这是我最兴奋的功能,因为它能回答“这个类型实现了哪些协议?”之类的问题:

for (const { name, address } of resolver.enumerateMatches('conformances:Swift.Int!Swift.*'))
  console.log(name, address);
Swift.Int!Swift.Encodable 0x19bf5f6c4
Swift.Int!Swift.Decodable 0x19bf5f6d4
Swift.Int!Swift.CodingKeyRepresentable 0x19bf5f984
Swift.Int!Swift.CustomReflectable 0x19bf612ec
Swift.Int!Swift._CustomPlaygroundQuickLookable 0x19bf612fc
...

反过来也能回答“哪些类型实现了这个协议?”,这在大型应用中尤其有趣:

const encodable = resolver.enumerateMatches('conformances:*!Swift.Encodable');
console.log(encodable.length, 'types conform to Encodable');
for (const { name, address } of encodable.slice(0, 3))
  console.log(name, address);
3735 types conform to Encodable
UIIntelligenceSupport.IntelligenceElement.Axis!Swift.Encodable 0x2a5e0a1c8
UIIntelligenceSupport.IntelligenceElement.Image!Swift.Encodable 0x2a5e0a9d0
UIIntelligenceSupport.IntelligenceElement.CustomAppEntity!Swift.Encodable 0x2a5e0b0e8

从遵循关系描述符可以找到 witness table,从上下文描述符则可找到类型的元数据、字段和方法。因此,它们是任何希望在运行时理解 Swift 程序类型的工具的基础构件,从美化输出某个值,到 Hook 实现特定协议的每个类型。未来会有更多功能构建在其上。

他还修复了 /i 后缀;Swift 解析器此前虽然接受它,却没有真正生效。非常感谢 Håvard 完成这些出色工作!

PatternCompiler

今天早些时候的版本引入了 PatternCompiler API,可在主机上编译 pattern,并据此解码内存。它原本接收源码字符串,看似方便,却无法知道源码位于何处,因此 pattern 除 std 库外不能导入任何内容。现在已经修复,API 与 Compiler.build() 对齐:传入路径,还可选择传入项目根目录;省略后者时会根据入口点推断。假设有 proj/player.hexpat,它从 proj/common.pat 导入 Vec3:

#pragma abi native

import common;

struct Player {
    u32 health;
    Vec3 position;
};

导入解析方式与 Frida.Compiler 构建 Agent 时完全相同:先相对于导入文件解析,再从 node_modules 中解析。现在每种类型都会说明其声明文件,每条诊断也一样;路径相对于项目根目录,与构建诊断的报告方式相同:

import frida

module = frida.PatternCompiler().compile("proj/player.hexpat")
for d in module.diagnostics:
    print(f"{d.file}:{d.line + 1}:{d.character + 1}: {d.message}")
for t in module.types:
    print(f"{t.file}: {t.kind} {t.name}, {t.size} bytes")

如果 common.pat 缺少分号,会报告:

proj/common.pat:5:1: expected ;

修复后则输出:

proj/common.pat: struct Vec3, 12 bytes
proj/player.hexpat: struct Player, 16 bytes

语言服务器也进行了相同改造,因此 .hexpat 导入另一标签页中尚未保存的缓冲区时也能解析,而且问题仍归属其所在文件。Swift 绑定已相应重新生成,其他绑定会自动获得这些变化。

这是对今天早上刚发布 API 的破坏性变更,希望尚无人基于它构建内容。如果已经使用,迁移方法是把 pattern 写入文件并传入其路径。

结语

尽情体验吧!

变更日志

  • swift-api-resolver:新增 types: 和 protocols: 查询,按完整名称匹配 __swift5_types、__swift5_types2 和 __swift5_protos 中的描述符。感谢 @hsorbo!
  • swift-api-resolver:新增 conformances: 查询,按类型名和协议名匹配 __swift5_proto 记录,并让 /i 真正生效。感谢 @hsorbo!
  • compiler:从文件编译 pattern;导入和 include 的解析方式与 Agent 构建相同;每种类型和诊断的文件名都相对于项目根目录。(上文已介绍。)
  • compiler:修复项目根目录为相对路径时的崩溃;此前 TypeScript 编译器虚拟文件系统内部的错误会导致整个进程退出。
  • swift:重新生成 PatternCompiler 绑定。

Frida 17.20.0 发布

从 Frida 诞生以来,处理结构体一直是它的薄弱环节之一。假设你在游戏中找到了一个 Player 结构体,并想读取它的 lives 字段,最终往往会写出这样的代码:

const lives = player.add(4).readU32();

那个神秘的 4 是你手工算出的偏移量,readU32() 也是你手工确定的类型;除了这一行, 这些信息没有记录在任何地方。把这种情况乘以你关心的每个结构体中的每个字段,最后得到的 脚本既脆弱又难读,结构布局也几乎无法与别人共享。如果结构体在 32 位和 64 位环境中的 布局不同,你还得维护两套偏移量。

这些年来我一直在思考这个问题。我真正想要的是一种类型安全的方法,让 TypeScript 编译器知道有哪些字段以及它们各自的类型,从而在编译时发现拼写错误,并让编辑器自动补全 字段名。这显然需要一个代码生成步骤,而我始终觉得让用户承担这一步的成本太高。

后来 Frida.Compiler 出现了。它并非从一开始就存在,但如今已经为 frida-compile、REPL 以及 Luma 等工具提供支持,代码生成步骤可以完全隐藏起来。这正是本次发布的主题。

模式

我们没有再发明一种结构体描述语言,而是采用了 ImHex 的模式语言。 这是一种用于描述二进制数据的类 C 语言,最初为 ImHex 的十六进制编辑器而创建,支持 结构体、联合体、枚举、位域、指针、条件、动态长度数组以及标准库。ImHex-Patterns 仓库收录了大量常见文件格式的模式,此后这门语言也被其他工具采用:x64dbg 通过 DataExplorer 插件提供支持,radare2 则通过 r2hexpat 提供支持。因此,你很可能 能找到可直接复用的现有模式;为 Frida 编写的模式也同样能用于这些工具。

Frida 17.20.0 使用 Go 在 Frida.Compiler 中实现了这门语言,与 TypeScript 编译器并列。 下面来试试看。这是 game.hexpat:

#pragma abi native

struct Player {
    u32 health;
    u32 lives;
    Role role;
    Vec3 position;
    Player* next;
};

struct Vec3 {
    float x;
    float y;
    float z;
};

enum Role : u8 {
    Warrior,
    Mage,
    Rogue,
};

如果你写过 C 结构体,就已经知道该如何阅读它。唯一显眼的是 #pragma abi native,稍后我们会回到这一点。

随后在 agent.ts 中像导入其他模块一样导入该模式:

import { Player, Role } from "./game.hexpat";

const roster = Memory.alloc(Player.size * 3);

const alice = Player.at(roster);
alice.health = 100;
alice.lives = 3;
alice.role = Role.Mage;
alice.position.x = 1.5;
alice.position.y = -2;
alice.position.z = 3;

const bob = Player.at(roster.add(Player.size));
bob.health = 42;
bob.lives = 1;
bob.role = Role.Warrior;
alice.next = bob;

const carol = Player.at(roster.add(Player.size * 2));
carol.health = 100;
carol.lives = 3;
carol.role = Role.Rogue;
bob.next = carol;

console.log("Player.size:", Player.size);
console.log(JSON.stringify(alice, null, 2));
console.log("alice.next.next.role:", Role[alice.next!.next!.role]);

在真实场景中,这些结构体显然由游戏自身持有,我们会通过 Interceptor、内存扫描或类似 方式找到它们。为了让示例自包含,这里由我们自己分配三个实例。

运行它:

$ frida -q -p 0 -l agent.ts
Compiling agent.ts...
Compiled agent.ts (20 ms)
Player.size: 32
{
  "health": 100,
  "lives": 3,
  "role": 1,
  "position": {
    "x": 1.5,
    "y": -2,
    "z": 3
  },
  "next": "0x140cb5bc0"
}
alice.next.next.role: Rogue

这里有几点值得注意:

  • 每个结构体都会变成一个类。Player.at(address) 提供该地址处内存的实时视图, 每个属性都直接读写底层内存。不会复制任何内容,因此你看到的始终是内存中的当前值。
  • position 这样的嵌套结构体同样是视图;next 这样的指针字段会提供其所指对象的 视图,或返回 null。给指针字段赋值时,可以传入视图或 NativePointer。
  • 枚举会变成带反向映射的对象,因此 Role[alice.role] 会得到 “Mage”。
  • Player.size 是结构体的字节大小,JSON.stringify() 也可直接使用。
  • 没有任何内容经过预编译。REPL 将 agent.ts 交给 Frida.Compiler;后者发现 .hexpat 导入后,把模式编译为 JavaScript,并与 agent 一起打包。运行 frida-compile agent.ts -o _agent.js 时也会执行同样的流程,生成的包是自包含的, 可由我们的任意语言绑定加载。

原生布局

由于模式语言是为文件格式设计的,ImHex 会以紧凑方式布局结构体,字段之间没有填充, 因为文件格式通常就是这样。另一方面,Frida 还需要处理由 C 编译器布局的内存中结构体, 而这类结构体会按自然对齐方式填充。这就是 #pragma abi native 的用途。它只存在于 Frida 的语言方言中,用来告诉编译器按照目标平台 C 编译器的方式布局结构体。在上面的 示例中,role 占一个字节,随后有三个填充字节,使 position 达到 4 字节对齐; 在 64 位进程中,next 则达到 8 字节对齐。因此 Player.size 是 32 而不是 25。 省略该 pragma 后会得到 ImHex 的紧凑布局,这正是解码恰好映射到内存中的文件格式时 所需要的布局。

生成的 JavaScript 也会考虑目标平台的 ABI。next 等指针字段在 64 位进程中占 8 字节, 在 32 位进程中占 4 字节,这会改变其后所有字段的偏移量;而且 32 位 Windows 与 32 位 Linux 等平台的对齐规则也不同。Frida.Compiler 会在编译时计算所有这些布局, 生成的代码则根据最终运行所在的进程在运行时选择正确布局。因此,一个编译后的 agent 就能支持 Frida 支持的任意目标,无需维护各架构专用的偏移量。

类型安全

这是最令我兴奋的部分。Frida.Compiler 加载 .hexpat 时,还会为它生成 TypeScript 声明,并以 game.hexpat.d.ts 的形式写在模式文件旁边:

export declare class Player {
    constructor(address: NativePointer);
    static at(address: NativePointer): Player;
    static readonly size: number;
    static pattern(fields: Player.Fields): string;
    static parse(address: NativePointer, size?: number): Player.Parsed;
    readonly $address: NativePointer;
    readonly $size: number;
    health: number;
    lives: number;
    role: Role;
    readonly position: Vec3;
    get next(): Player | null;
    set next(value: Player | NativePointer | null);
    toJSON(): Player.Values;
}

这意味着 TypeScript 编译器能准确知道有哪些字段以及它们的类型。拼错字段名会得到编译 错误,编辑器也能自动补全字段名。在结构体中加入 char name[16] 后,它会显示为只读 string;如果尝试给它赋值,编译器会发出提示。(我写这篇文章时就被提示过。)模式本身 的错误也会像 TypeScript 错误一样,连同文件和行号一起报告:

$ frida-compile agent.ts -o _agent.js
game.hexpat:5:5 - error TS-1: unknown type Badge
compilation failed

你可能需要将 *.hexpat.d.ts 加入 .gitignore,因为每次构建都会重新生成这些文件。

扫描

现在来看让这一切如同魔法的部分。假设我们要寻找一个生命值全满且有三条命的 Player, 但完全不知道它位于内存中的什么位置。每个生成的类都有一个静态 pattern() 方法, 它接收字段的一个子集,并为 Memory.scan() 生成匹配模式;省略的字段会变成通配符:

const pattern = Player.pattern({ health: 100, lives: 3 });
console.log("pattern:", pattern);

for (const { address } of Memory.scanSync(roster, Player.size * 3, pattern)) {
  const p = Player.at(address);
  console.log(`${address}: ${Role[p.role]} with ${p.lives} lives`);
}

结果如下:

pattern: 64 00 00 00 03 00 00 00 ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ??
0x140cb5ba0: Mage with 3 lives
0x140cb5be0: Rogue with 3 lives

字节序、字段偏移量和填充都已自动处理。在真实游戏中,你会扫描 Process.enumerateRanges(‘rw-‘) 返回的堆范围,而不是这个小小的 roster;还可以加入 枚举值或嵌套字段来缩小范围,例如 Player.pattern({ role: Role.Rogue, position: { z: 3 } })。

超越视图

实时视图覆盖纯数据结构体,而进程内部遇到的大多数结构体都属于这一类。但模式语言还能 做到更多:由前置字段决定长度的数组、条件、具有自定义基址的指针、局部变量、函数、 [[format]] 和 [[color]] 等属性、std 库等等。对于这些功能,可以使用 parse(), 它以完整的 ImHex 语义解码内存快照。下面用 macOS 和 iOS 上每个进程都有的内容来试验: 主可执行文件的 Mach-O 头。将以下内容写入 macho.hexpat:

#pragma endian little

struct MachO {
    MachHeader header;
    LoadCommand commands[header.ncmds];
};

struct MachHeader {
    u32 magic [[color("FF8800")]];
    CpuType cputype;
    u32 cpusubtype;
    FileType filetype;
    u32 ncmds;
    u32 sizeofcmds;
    u32 flags;
    u32 reserved;
};

struct LoadCommand {
    u32 cmd;
    u32 cmdsize;
    u8 payload[cmdsize - 8] [[sealed]];
};

enum CpuType : u32 {
    X86_64 = 0x01000007,
    ARM64 = 0x0100000C,
};

enum FileType : u32 {
    Object = 1,
    Execute = 2,
    Dylib = 6,
};

MachO macho @ 0x00;

请注意,这里没有 #pragma abi native,因为这是文件格式。还要注意末尾的 placement, ImHex 模式通常用这种方式声明文件开头的内容。在本例中,“文件”是一段内存,而带有 placement 的模式会为我们提供一个用于解码它们的 parse() 导出:

import { parse, MachHeader, CpuType, FileType } from "./macho.hexpat";

const base = Process.mainModule.base;

const header = MachHeader.at(base);
console.log("magic:", header.magic.toString(16), CpuType[header.cputype],
    FileType[header.filetype]);
console.log("ncmds:", header.ncmds);

const image = parse(base, 4096).macho;
console.log("commands:", image.commands.length);
for (const cmd of image.commands.slice(0, 3)) {
  console.log(`  cmd=0x${cmd.cmd.toString(16)} cmdsize=${cmd.cmdsize}`,
      `@ ${cmd.$address}`);
}
$ frida -q -p 0 -l macho.ts
Compiling macho.ts...
Compiled macho.ts (19 ms)
magic: feedfacf ARM64 Execute
ncmds: 20
commands: 20
  cmd=0x19 cmdsize=72 @ 0x102a64020
  cmd=0x19 cmdsize=312 @ 0x102a64068
  cmd=0x19 cmdsize=152 @ 0x102a641a0

parse() 的第二个参数限制它最多可以读取多少内存。当模式中数组的长度取决于尚未完全 信任的数据时,这样做很有必要。结果是一棵普通值组成的树,每个结构体都带有 $address 和 $size,因此可以知道每部分来自哪里。由于该结构体是纯数据, MachHeader.at() 仍可同时作为实时视图使用。

模式可以导入其他模式。导入项会先相对于发起导入的文件解析,再从 node_modules 解析,因此模式可以作为 npm 包发布。std 库已内置,所以 import std.mem; 可直接使用。 我们的测试套件会运行 ImHex-Patterns 语料库,其中 312 个模式有 303 个无需修改即可编译; 其余模式要么依赖 ImHex 本身,要么在那里也会失败。可视化器(即 hex::visualize())由接下来介绍的宿主端 API 求值,在 agent 内部则会被忽略。

PatternCompiler

Frida.Compiler 负责处理 agent,但构建在 Frida 之上的工具通常希望在宿主端解码内存, 而不向目标注入任何模式代码。为此,frida-core 新增了 PatternCompiler API,自动生成的 frida-python、frida-node 和 frida-swift 等绑定会自动获得它。你向它提供模式源代码, 它会返回一个 PatternModule:该模块描述模式声明的类型,并能按照其中任意类型解码 一段字节。下面从 Python 使用它,解码前面查看过的同一个 Mach-O 头:

from pathlib import Path

import frida

session = frida.attach(0)
script = session.create_script("""
rpc.exports = {
  mainModule() {
    const { base, name } = Process.mainModule;
    return [name, base.toString()];
  },
  read(address, size) {
    return ptr(address).readByteArray(size);
  },
};
""")
script.load()

name, base = script.exports_sync.main_module()
base = int(base, 16)
data = script.exports_sync.read(base, 4096)

module = frida.PatternCompiler().compile(Path("macho.hexpat").read_text(),
                                         platform="darwin", arch="arm64")
assert len(module.diagnostics) == 0

macho = module.decode("MachO", data, base)
header = macho.fields[0]
print(f"{name} @ {macho.address:#x}")
for field in header.fields:
    print(f"  {field.name:<11} {field.type_name:<10} "
          f"{field.label or field.value!s:<10} {field.color or ''}")
commands = macho.fields[1]
print(f"  {commands.name}: {commands.count} load commands, "
      f"{commands.size} bytes")
$ python3 decode.py
Python @ 0x104ec0000
  magic       le u32     4277009103 FF8800
  cputype     CpuType    ARM64
  cpusubtype  le u32     0
  filetype    FileType   Execute
  ncmds       le u32     20
  sizeofcmds  le u32     1232
  flags       le u32     2097285
  reserved    le u32     0
  commands: 20 load commands, 1232 bytes

解码后的树包含 UI 所需的一切:每个值的地址、偏移量和大小,枚举标签,[[format]] 输出,[[comment]]、[[color]],以及模式附加的任何可视化器及其求值后的参数。 具体如何渲染由工具决定。模块还会描述已声明的类型及其字段、偏移量和大小,因此无需 解码任何内容即可构建类型浏览器。模式可以声明 in 变量,解码时按名称提供;如果模式 附加了 button 可视化器,call_function() 可用于按下它。编译错误不会抛出异常, 而是连同行号和列号放入 diagnostics,以便显示在编辑器中。

说到编辑器:17.18.0 引入的 Frida.LanguageServer API 现在也支持 .hexpat 和 .pat 文档,提供诊断、补全、悬停信息、文档符号、折叠范围、语义 token、跳转到定义, 以及 [[color]] 属性的色板。补全功能了解 std 库和可视化器名称。编写导入模式的 TypeScript agent 时,生成的声明还会免费带来字段补全。

Luma

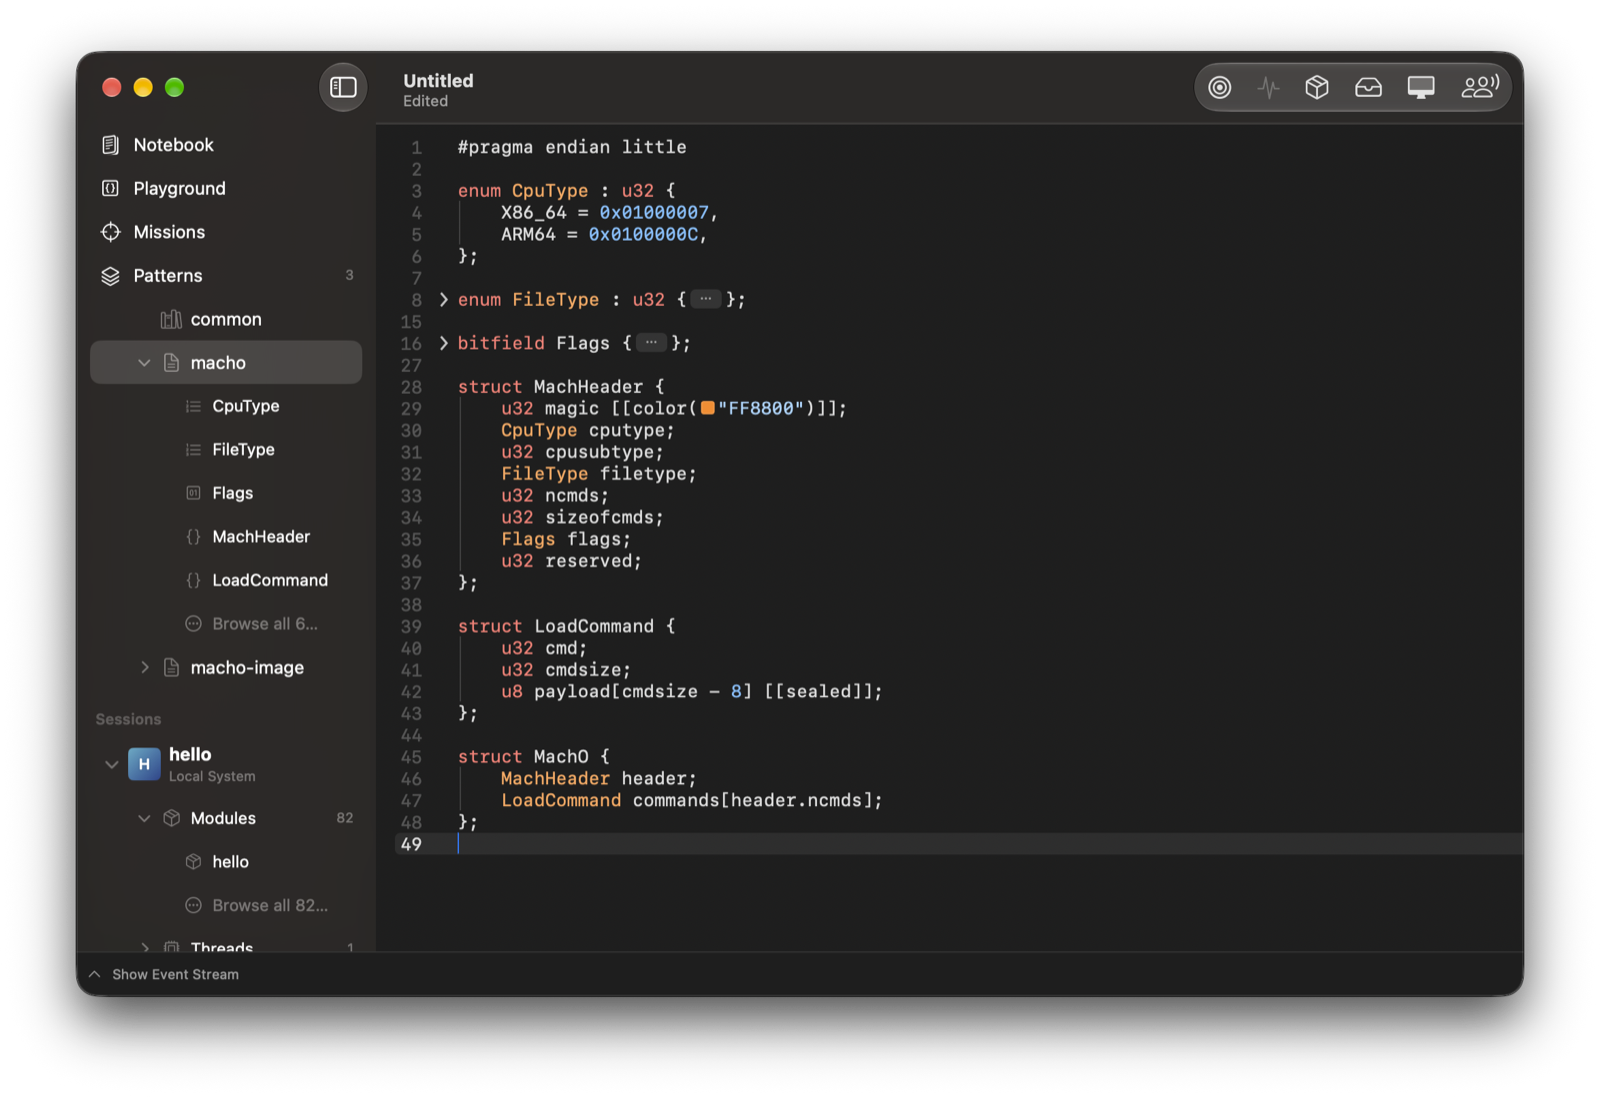
在即将发布的版本中,Frida 官方 GUI Luma 已经用上了上述所有功能。Luma 的侧边栏 新增 Patterns 区域,用于存放模式和共享库,并配有语言服务器支持的编辑器:

luma-pattern-editor

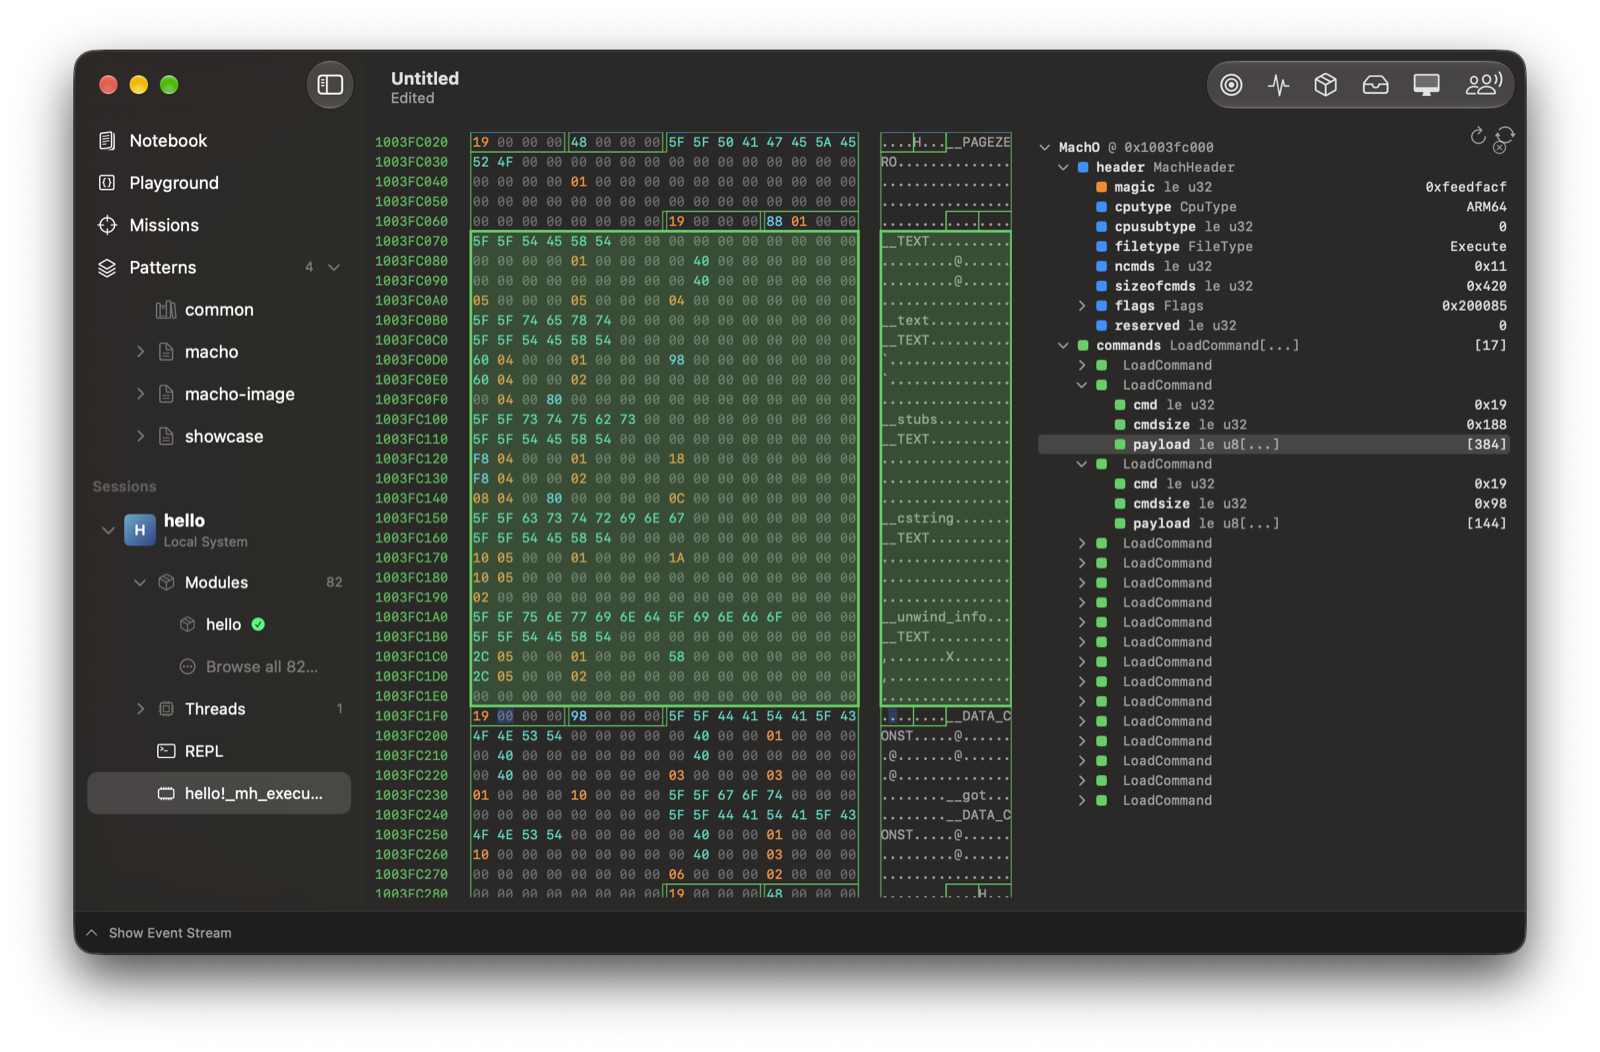
每个文件展开后都会显示它声明的类型,因此可以直接跳转到结构体。无论十六进制视图来自 内存洞察还是 REPL hexdump,都会获得“Decode at … as…”上下文菜单,其中列出模式库中的 类型。选择一种类型后,各字段对应的字节会亮起彩色轮廓,旁边的树则显示名称、类型和值。 单击某个字节会选中它所属的字段,选择字段则会将十六进制视图滚动到对应位置。下面是直接 从运行中进程解码出的 Mach-O 头:

luma-pattern-macho

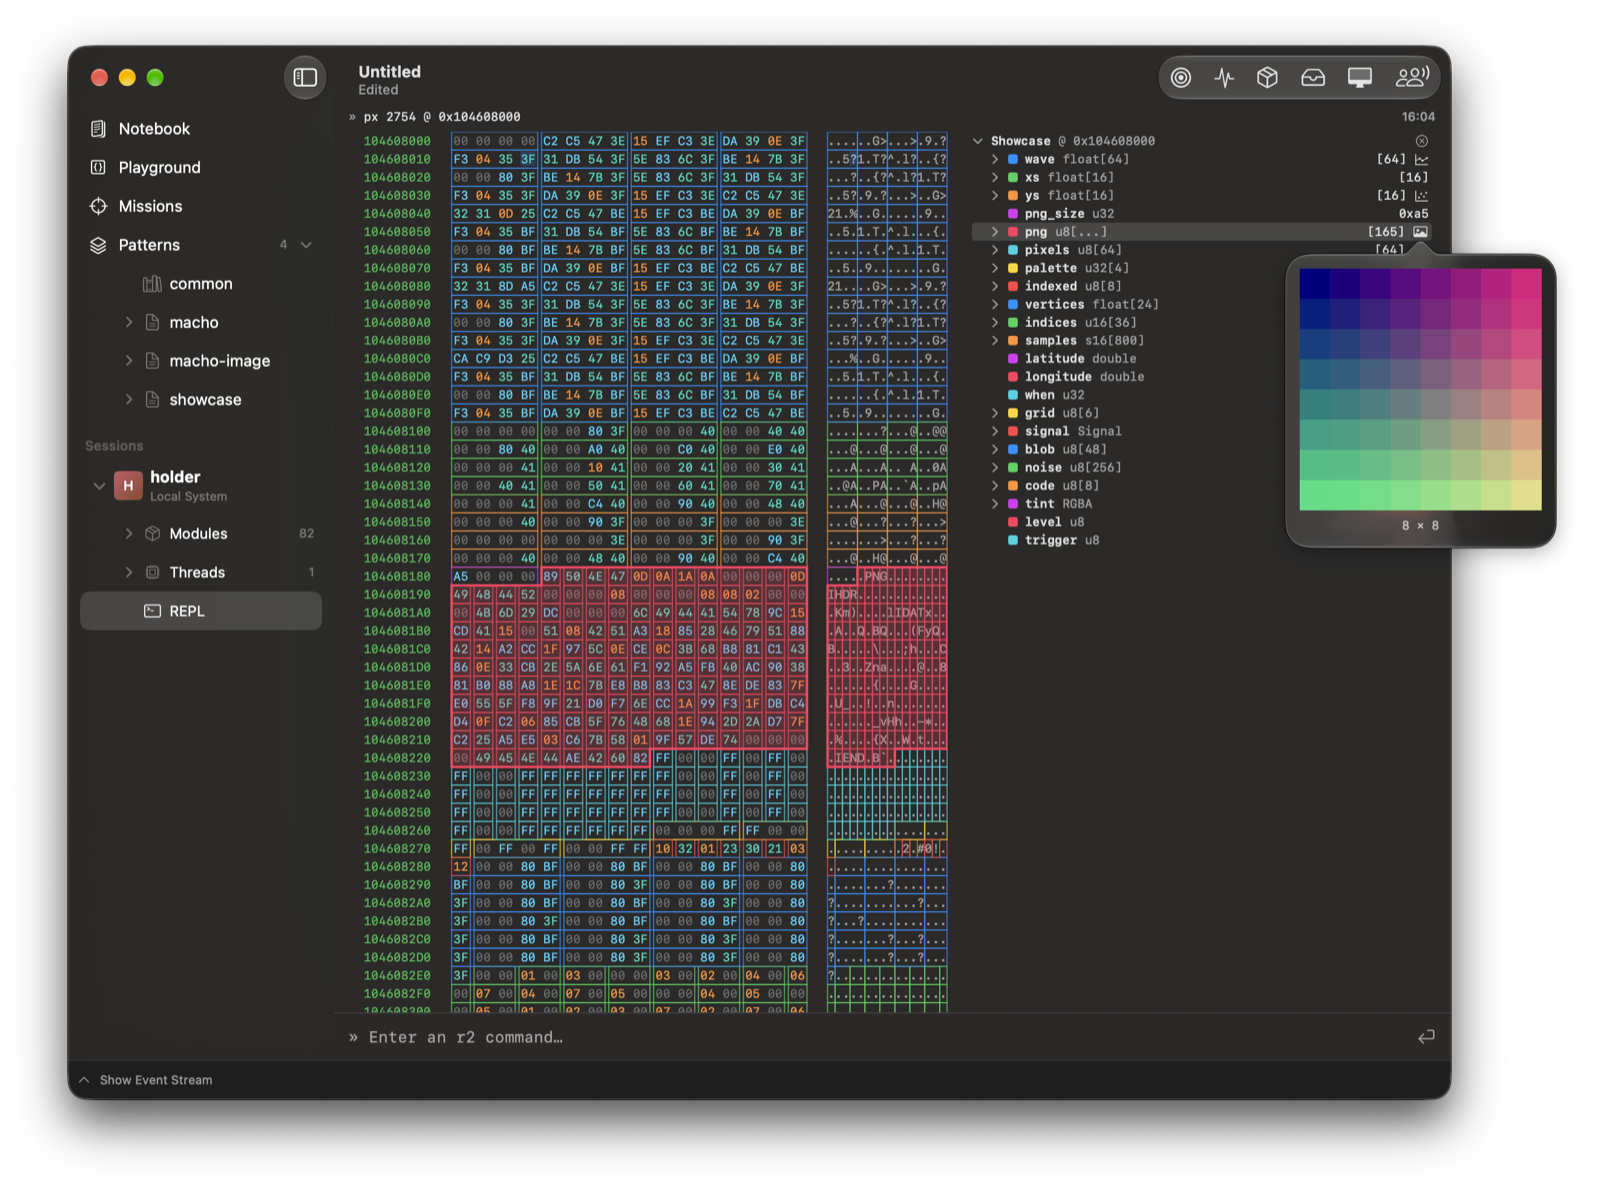
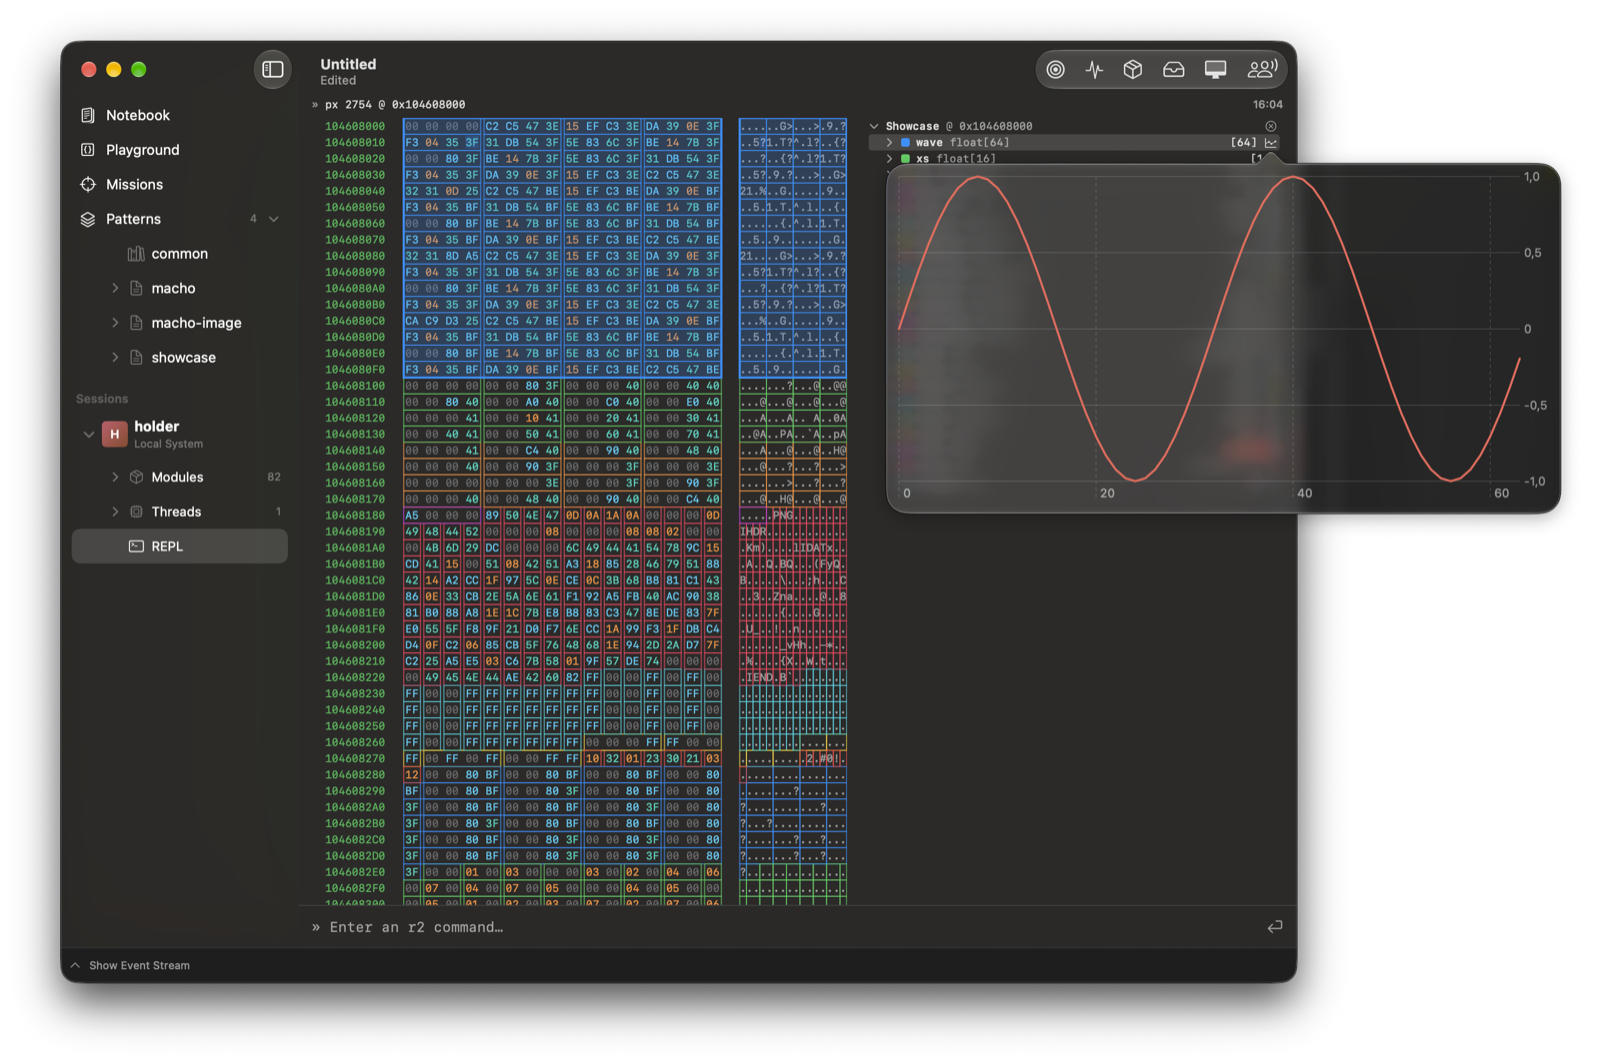
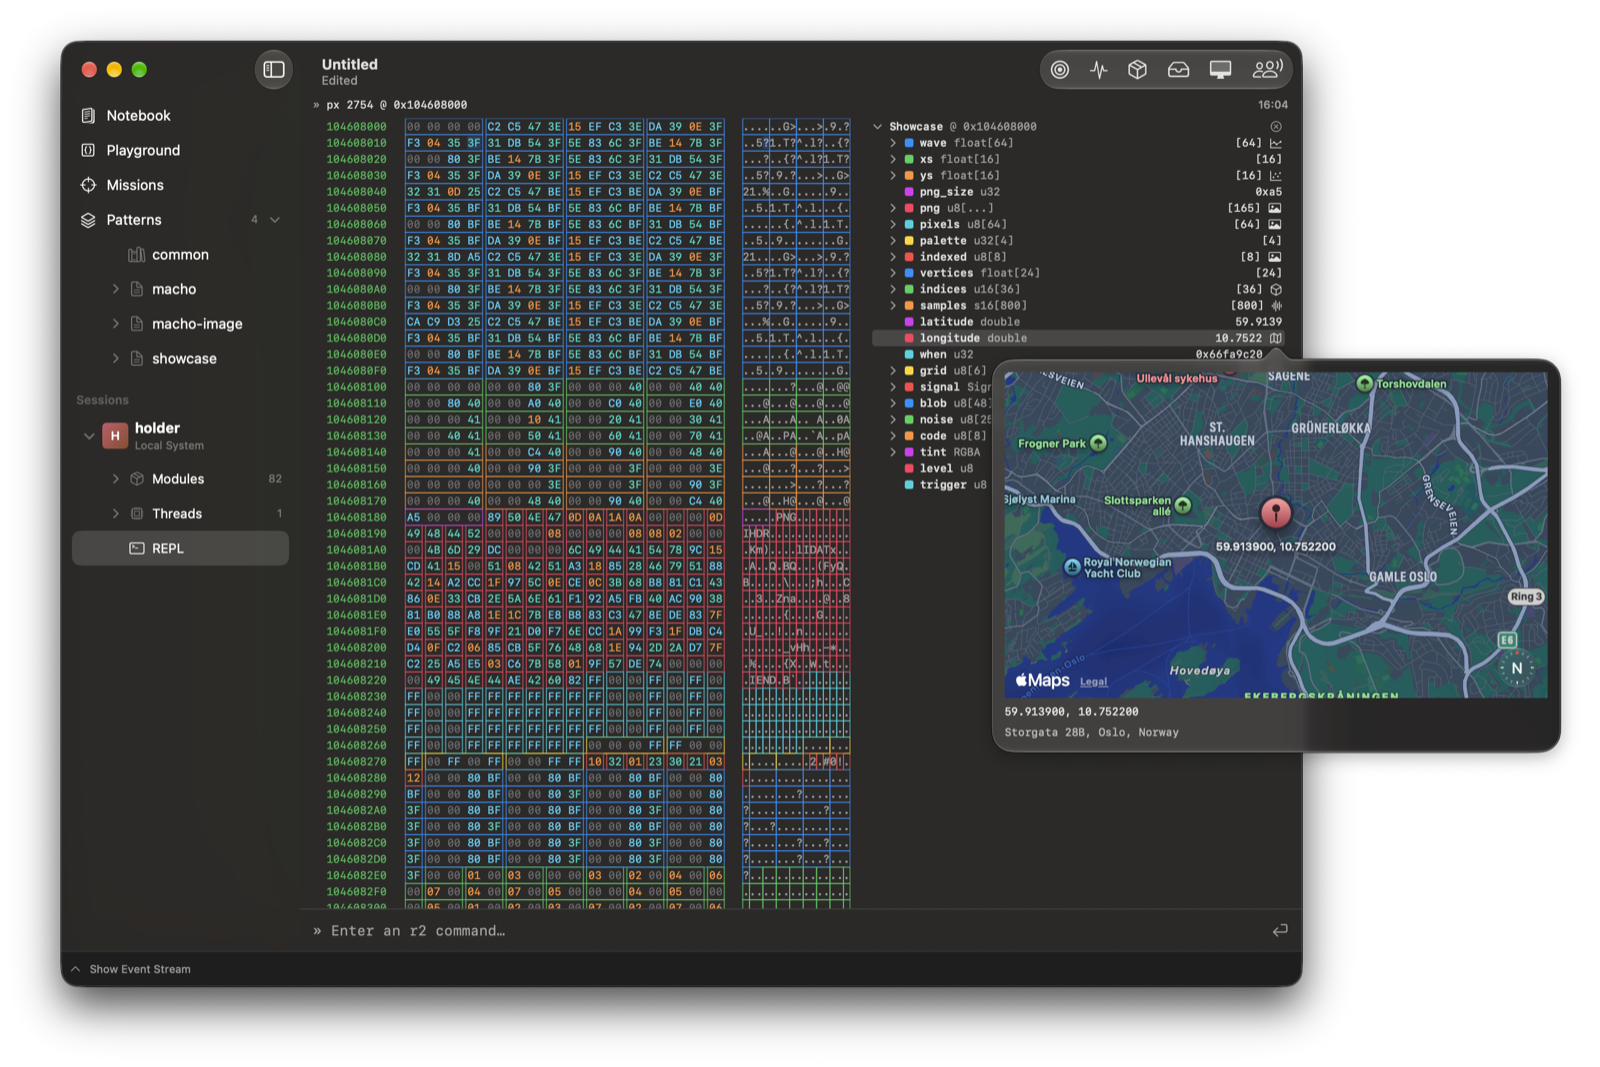
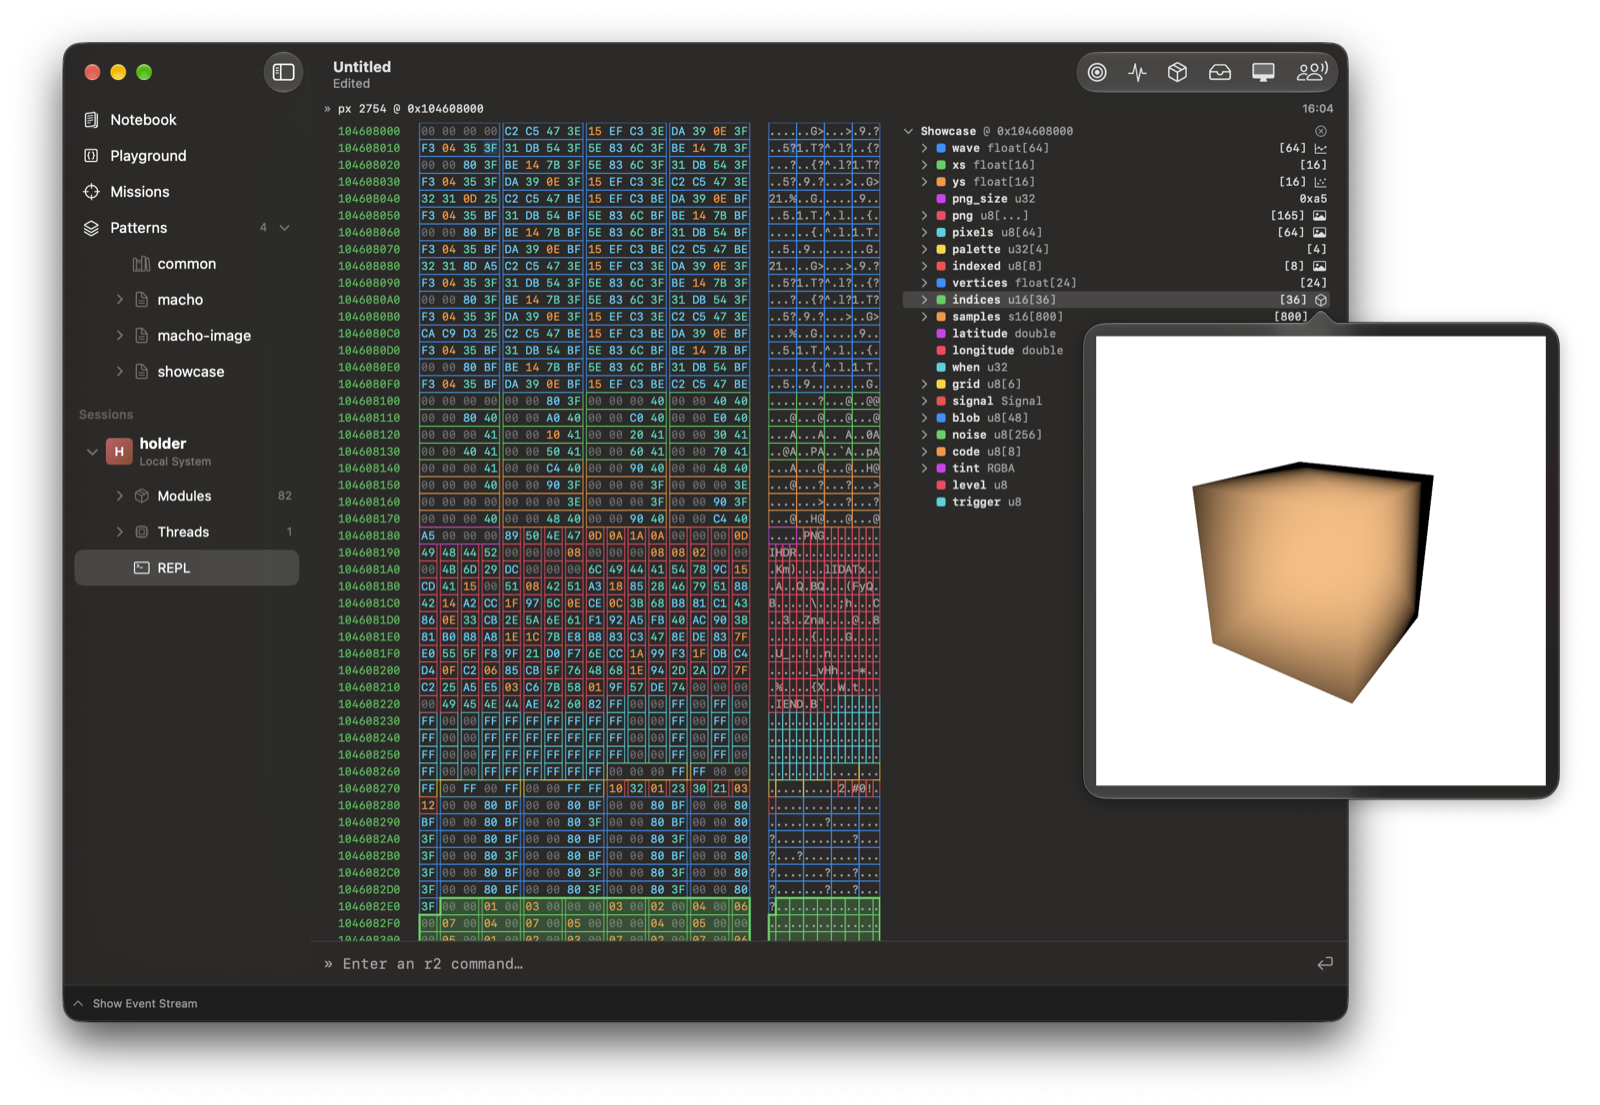
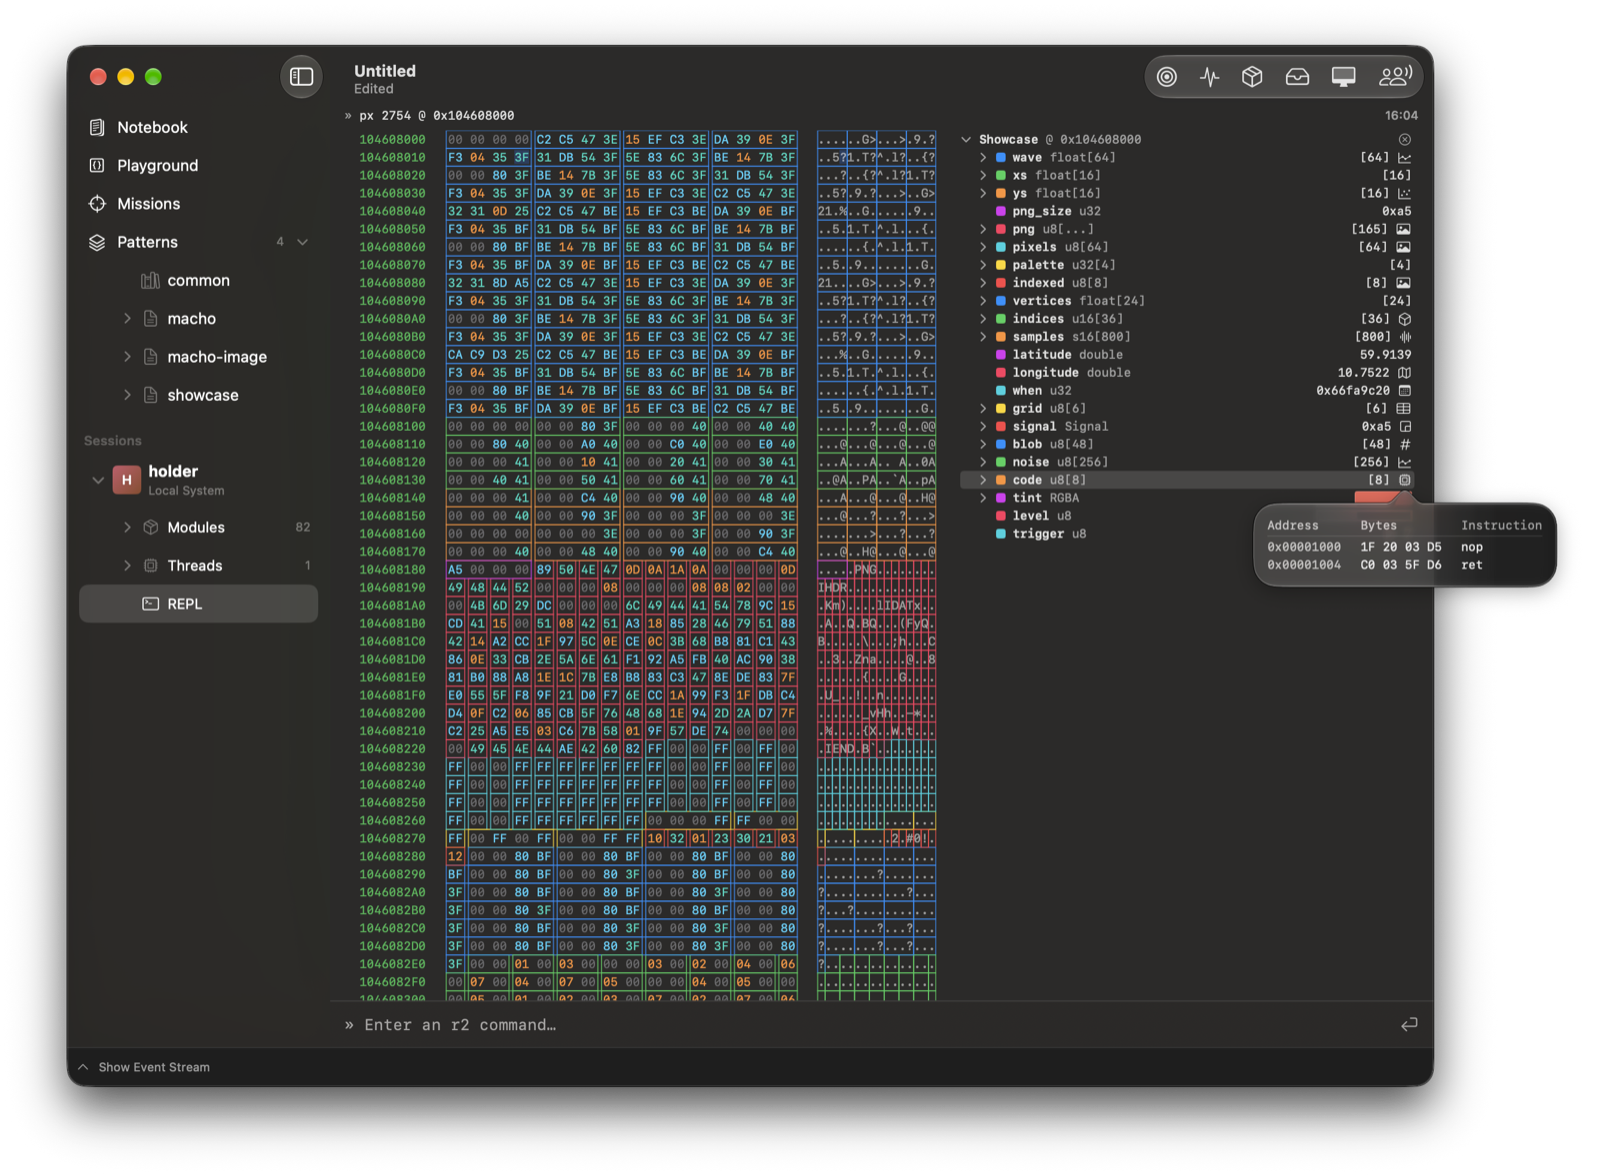
真正有趣的是可视化器。模式语言允许给字段附加可视化器,例如图像、折线图、3D 模型、 地图坐标、音频采样、时间戳、以数字信号显示的位域或反汇编,而 Luma 会将它们渲染出来:

luma-pattern-image

luma-pattern-line-plot

luma-pattern-map

luma-pattern-3d

luma-pattern-disassembler

由于 Luma 的 REPL、自定义仪器和 tracer hook 都通过 Frida.Compiler 编译,它们会获得与 上面所写 agent 相同的能力:导入一个模式,即可得到实时视图、用于扫描的 pattern()、 支持完整语言的 parse(),以及输入时的字段补全。

结语

本次发布还有许多其他变更,务必查看下面的变更日志。

尽情享用吧!

变更日志

  • compiler:添加 ImHex 模式语言支持。(上文已详细介绍。)
  • gumjs:允许 NativePointer 的读写操作接收可选偏移量,例如 p.readU32(4),从而无需 为字段地址分配 NativePointer 即可访问字段。生成的模式视图底层也采用这种方式。
  • gumjs:让 writeVolatile() 返回指针,以便与其他写入方法保持一致。
  • api-resolver:当导出查询是字面量前缀加末尾通配符(如 exports:*!pthread_*)时,沿 Darwin 导出 trie 向下查找,而不再枚举每个匹配 模块的所有导出。在加载 676 个模块时,243 次此类查询从 35 秒缩短到 65 毫秒。 感谢 @hsorbo!
  • swift-api-resolver:使用 Swift 进程中始终存在的 libswiftCore 所提供的 swift_demangle() 进行反修饰,不再使用通常未加载的 libswiftDemangle。解析过程 也改为延迟执行,因此 libswiftCore 加载后解析器便会开始工作。感谢 @hsorbo!
  • arm64:限制重定位器的可达性扫描。此前每个块都会重置 1024 字节预算,导致扫描无限 跟随分支目标;在 Android 上,这会让挂钩分支繁多的代码时,每个目标耗费数百毫秒。
  • exceptor:不再在每次 try 时保存信号掩码;这一步并非必需,却会让每次尝试产生一次 系统调用。
  • payload:修复 Android agent 加载时崩溃的问题。原因是模块注册表在 libc shim 建立 stdio 注册表之前读取了 /proc/self/auxv。
  • barebone:将 macOS Android 模拟器提升为一等目标。shim 已重写为 CModule,使热路径 能够无锁运行;现在会恢复所有核心、将寄存器直接推送到 vcpu、处理被捕获的调试寄存器 访问而不再中止虚拟机,并在原生层过滤空闲调度器命中。现在也可以枚举和启动应用。
  • barebone:将 agent 注入 SMP arm64 Linux;在 Linux 上报告线程状态和寄存器;根据 cmdline 命名 Linux 进程;并避免将 arm64 副本放在大页上。
  • linux-kernel-image:从 32 位内核和 VA_BITS=48 的 arm64 内核中提取 kallsyms, 包括长度超过 80 个字符的 Rust 符号名。
  • barebone:修复不带 Droidy 后端时的构建,以及 32 位 Arm 构建。
  • base:不在 API 中暴露 Posix 类型,使 frida-base 使用者不再需要 posix.vapi。
  • compiler:在 Windows 上使用 cgo 构建时优先选择 UCRT64,并针对每种 flavor 探测 MinGW 编译器。
  • node:转义参数名中的保留字,并将从对象构造的 options 中的 GValue 清零。
  • python:将 null variant 编组为 None。
  • swift:绑定模式编译器类型以及 variant、列表和字典;释放拥有所有权的返回值; 并使用其 C 类型声明 out 参数,使 UInt64 out 参数能在 LP64 Linux 上编译。

Frida 17.19.0 发布

本次发布将 Frida 带到了 PlayStation 5,扩展了 Barebone 对虚拟机和内核的覆盖范围, 并修复了一系列注入和插桩问题。

  • prospero:添加 PS5 后端,并提供 frida-server、portal、inject、Gadget 和 devkit 的构建版本。 在游戏机的限制范围内,该后端可以枚举应用、启动程序和应用,以及注入代理。
  • barebone:添加对 Android 模拟器的支持。内核符号发现现在可以处理更多 Linux 映像和旧版内核, 新增的 hostlink 选项则包括基于 vsock 的管道和串行连接。
  • barebone:将 WinNT 支持扩展到 arm64,包括进程注入,并添加对 VirtualBox 和 Parallels 客户机的支持。大量修复提升了代理在 Windows 和 Linux 内核上的可靠性。
  • device:添加连接进度事件,使应用可以在设备连接或上传 Barebone 代理时显示 Frida 正在执行的操作。 绑定中也提供了这些新信号。
  • fruity:修复 macOS 27 上的 RSD 端口发现;找不到新发布的服务时会刷新服务快照。 新增的 force_transport=usbmux 通道选项允许调用方即使在隧道可用时也选择 usbmux。 感谢 @mrmacete 提供该选项。
  • darwin:修复 iOS 27 上的注入泄漏;该问题可能导致每次附加后都保留一个 40 MB 的代理 blob。 同时改进内存保护处理,并在放宽策略期间保持暂停状态。感谢 @jiska 完成这些修复。
  • gum:改进 arm64 重定位以及 Interceptor 对函数序言的处理,包括 X16 和 X17 同时被占用的情况。 Grafting 现在使用 Arm64Relocator,从而可以重定位 PC 相对指令。感谢 @jiska 和 @daniillnull 在这方面所做的工作。
  • interceptor:跟踪与每个帧关联的 C 栈,改进对有栈协程的处理。感谢 @wertyutreethgfd 的贡献。
  • linux:在内核辅助注入后回收临时栈和 TLS 映射,并在代理卸载时释放加载器区域。 读取辅助向量中的程序头之前先进行验证,修复 Wine 预加载器暴露出来的问题。 感谢 @tntljc 完成后一项修复。
  • socket:处理对等端在 WebSocket 握手与接受连接之间断开的情况,避免中止进程。 感谢 @it4ch1-007 完成该修复。
  • darwin:在可用时使用越狱环境提供的内存挂钩。感谢 @devnoname120 的贡献。
  • gdb:改进线程选择、超时和停止处理,并增强与不支持二进制写入的存根的兼容性。

此外还修复了 Windows 中通过 Interceptor 跳板进行栈展开的问题、Swift 事件传递和变体生命周期问题、 生成的绑定问题,以及各种平台特定的构建问题。

Frida 17.18.0 发布

Frida 17.18.0 已经发布,Barebone 也向前迈出了一大步。XNU agent 现在可作为 macOS 内核扩展加载;Linux agent 获得了更广泛的体系结构支持,并能访问内核自身的类型信息;后端还能在 Linux、XNU、Windows NT 乃至 Windows 9x 上同时为内核本身和用户态进程插桩。我们还将 Frida.Compiler 升级到 TypeScript 7.0,并新增配套的 Frida.LanguageServer API。

一项令人兴奋的新功能是能够把 XNU agent 构建为 .kext。以前,要让它进入内核,必须通过兼容 GDB 的远程 stub(例如 QEMU 的 stub)从外部注入,或使用 JTAG/SWD 硬件调试器。现在 macOS 可以自行加载 agent,/dev/frida 则提供配置和通信通道。这为使用 Frida 进行内核插桩开辟了另一种方式。kext 目前支持内核侧;要在用户进程中放置 agent 副本,仍需使用注入式 XNU agent。

本版本的 Barebone 还有更多内容。注入式 agent 现在把熟悉的 Frida 工作流带入客户机进程:枚举进程、附加、运行脚本、挂钩函数,以及在程序开始运行前就完成插桩并启动它。相关工作覆盖 Linux、XNU、两种字长的 Windows NT,以及 32 位 Windows 9x。Linux agent 注入现在支持 x86、x86-64、Arm 和 Arm64;Linux agent 既可注入运行中的内核,也可作为内核模块加载。

在 Linux 上,脚本现在可以发现已加载的内核模块及其符号,模块注册表会跟踪驱动的加载与卸载。新的 Btf 命名空间还允许脚本在可用时查询内核的 BTF 类型信息。结构体大小、字段偏移与类型、枚举、常量和函数签名都可直接从 JavaScript 获取。例如:

if (Btf.available) {
  const module = Btf.getStruct('module');
  console.log('struct module size:', module.size);
  console.log('name offset:', module.getOffsetOf('name'));
  console.log('name field:', JSON.stringify(module.fields.name));
  console.log('MODULE_STATE_LIVE:', Btf.getConstant('MODULE_STATE_LIVE'));
}

这意味着脚本可以询问内核其结构体如何布局,避免使用绑定到特定构建的硬编码偏移。底层是一个新的 GumJS 原生 API 注册表,使嵌入方能够独立于所用 JavaScript 运行时公开原生函数命名空间。

与此同时,Frida.Compiler 已升级到 TypeScript 7.0。新的 Frida.LanguageServer API 将同一编译器的语言服务带给嵌入 Frida 的工具。它为 TypeScript 和 JavaScript 项目实现 Language Server Protocol:可以为项目目录创建并启动服务器,通过 post() 发送 JSON-RPC 消息,再通过 message 信号接收回复和通知。这样便可结合 Frida 内置的类型定义和编译器配置,集成代码补全等编辑器功能。编译器和语言服务器还共享解析缓存,因此相同文件内容无需分别解析。

其他亮点和修复:

  • barebone:添加用于增删 Barebone 设备的公共 API,ID、名称和图标由调用方提供。公开注入式和常驻 agent 的配置,包括显式 hostlink 地址。
  • barebone:为 Linux、XNU 和 Windows agent 添加进程启动和启动门控;在 XNU 和 Windows 上添加应用枚举,并在 XNU 上添加应用启动。
  • barebone:改进模块和线程观察、故障恢复、进程清理,以及对 agent 自身线程和映射的隐藏。
  • barebone:改进各 agent 的传输交付和唤醒,包括大消息和二进制脚本消息载荷。会话分离时保持常驻 agent 存活。
  • barebone:通过可写别名添加 XNU 内核文本修补,并改进内核边界处的代码分配和指针认证。
  • barebone:从 kallsyms 和导出表公开 Linux 内核模块符号,并在清理期间注销 API 和模块观察器。
  • barebone:将 Linux 内存操作移入客户机,正确处理可写与可执行映射。把重映射和修补扩展到 x86、x86-64、Arm 和 Arm64。
  • barebone:访问 QEMU 物理内存模式时暂停客户机,并修复影子页源自 Linux 线性映射时内核文本补丁被静默丢弃的问题。
  • barebone:在内核空间放置 x86 别名,修复 CModule 访问其数据时的故障。允许虚拟内存扫描跨越多个叶表。
  • barebone:添加 Arm 地址转换和内核空间别名,扩宽 32 位重映射请求中的页地址,并直接刷新 Arm 指令缓存,而不是尝试从内核发起用户空间系统调用。
  • barebone:向 JavaScript 运行时报告实际可用栈空间,防止普通脚本递归溢出 Linux 内核栈。
  • barebone:使用 _end 确定 Linux 内核大小,避免无关映射使 32 位内核看起来大出数 GB。通过 GumElfModule 读取复制的内核映像,不解引用指向实时内核的指针。
  • barebone:修复并完善 Linux 内核模块构建,包括构造函数数组边界和特定变体的运行时依赖。
  • linux:加载 Frida 内核模块时添加内核辅助注入;模块不存在时回退到现有注入路径。
  • gdb:内存写入使用二进制数据包,并遵循目标寄存器大小。
  • interceptor:修复可写视图和可执行视图使用不同映射时 Arm trampoline 的寻址。
  • memory:查找指针时跳过坏页。感谢 @IPMegladon!
  • memory:允许扫描模式边缘使用通配符,包括 Barebone。感谢 @Xoffio!
  • arm64:没有可用着陆垫时避免 BTI。感谢 @inforcqb!
  • arm64:检测进入正在重定位指令的分支,使 Interceptor 能选择更小的重定向,避免分支进入已覆盖代码并崩溃。感谢 @WHW0x455!
  • cmodule:将 CModule 从 GumJS 移入 Gum,使其可独立于 JavaScript 绑定使用。感谢 @cputnam-a11y!
  • elf-module:从文件读取程序头,修复程序头被 patchelf 等工具移动的模块;仅有实时映射可用时限制后备读取范围。感谢 @tracyliving!
  • windows:调整 ACL 以提高注入成功率。感谢 @jamiechapmanbrn!
  • python:修复 Python 3.11 之前版本的 typing 导入。
  • ci:构建 XNU 内核扩展、额外 Linux agent 和所需 Barebone SDK 与 devkit。在 Android 上启用 Barebone 后端。
  • deps:精简 Barebone SDK 中的 Capstone,将归档从约 29 MB 减至 4.4 MB。允许独立式 GLib 构建使用 C 库较小的 printf 实现,并精简区域设置和文件名转换支持。
  • deps:优化 QuickJS 以减少栈消耗,并调整 GLib 以减小 Barebone 场景中的体积。

Frida 17.17.0 发布

这是一个包含大量裸机好料的大版本。Barebone agent 使用 Rust 编写并嵌入 GumJS devkit, 之前只支持 XNU。现在它也能运行在 Linux 内核中,由一个小型 C shim 提供内核粘合层。

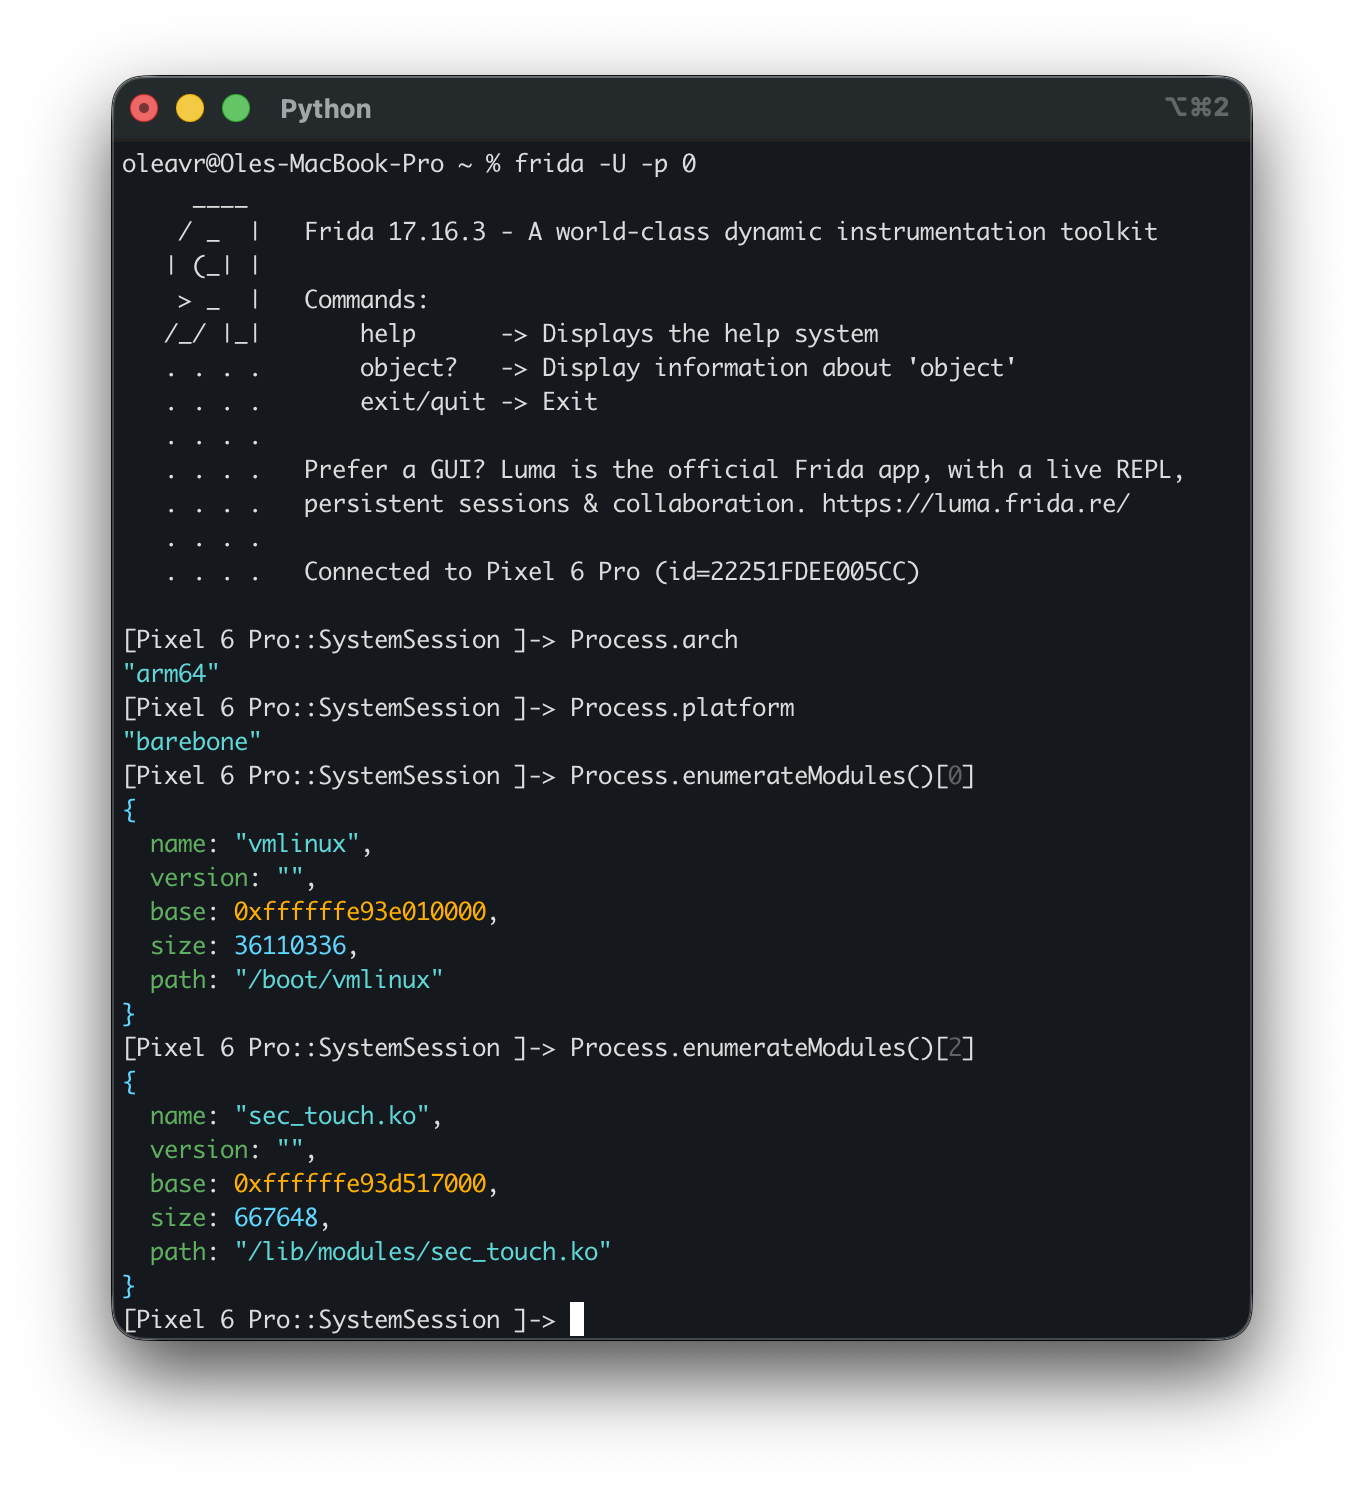
agent 被打包为 .ko:使用 insmod 加载,然后通过 /dev/frida 交换带长度前缀的 GVariant 消息。 将 Barebone 后端配置为使用该传输,并在设备上运行 frida-server --device=barebone。 下图是它在我的 Pixel 6 Pro 上运行的样子:

linux-kernel

为你的设备构建模块

发布页面提供了面向 none-arm64-softfloat 目标的 GumJS devkit。你不需要自行构建 Gum。 下面的步骤将为 Pixel 6 Pro 制作 frida-agent.ko。其他 arm64 Linux 系统使用相同步骤,只需换用不同内核。

请在 x86-64 Linux 主机上完成构建。内核构建树中包含 x86-64 程序。

  1. 安装工具:

    sudo apt-get install build-essential clang binutils-aarch64-linux-gnu
    rustup target add aarch64-unknown-none
    rustup component add rust-src
    

    clang 必须为 19 或更高版本。GCC 未实现软浮点 ABI。

  2. 下载源码:

    git clone --recurse-submodules https://github.com/frida/frida-core.git
    cd frida-core
    
  3. 下载 devkit:

    version=17.17.0
    base=https://github.com/frida/frida/releases/download/$version
    curl -LO $base/frida-gumjs-devkit-$version-none-arm64-softfloat.tar.xz
    mkdir -p ~/gumjs-devkit
    tar -C ~/gumjs-devkit -xf frida-gumjs-devkit-$version-none-arm64-softfloat.tar.xz
    
  4. 下载 SDK:

    releng/deps.py sync sdk none-arm64-softfloat_nopic ~/sdk-none-arm64-softfloat_nopic
    

    SDK 包含 picolibc 和 compiler-rt builtins。devkit 需要它们。

  5. 从设备读取内核版本:

    adb shell uname -r
    6.1.145-android14-11-gc1de4747ac59-ab14219743
    

    名称以 GKI commit 和构建号结尾。这里的 commit 是 c1de4747ac59,构建号是 14219743。

  6. 下载内核文件:

    commit=c1de4747ac59
    build=14219743
    ci=https://ci.android.com/builds/submitted/$build/kernel_aarch64/latest/raw
    mkdir -p ~/kernel-prepared ~/kernel-source
    curl -sSL $ci/modules_prepare_outdir.tar.gz | tar -xz -C ~/kernel-prepared
    curl -sSL $ci/kernel_aarch64_Module.symvers -o ~/kernel-prepared/Module.symvers
    curl -sSL https://android.googlesource.com/kernel/common/+archive/$commit.tar.gz \
        | tar -xz -C ~/kernel-source
    
  7. 构建模块:

    make -C src/barebone/agent/linux \
        FRIDA_SDK=$HOME/sdk-none-arm64-softfloat_nopic \
        GUMJS_DEVKIT_DIR=$HOME/gumjs-devkit \
        AGENT_LD=aarch64-linux-gnu-ld \
        AGENT_AR=aarch64-linux-gnu-ar \
        AGENT_NM=aarch64-linux-gnu-nm \
        AGENT_OBJCOPY=aarch64-linux-gnu-objcopy \
        KDIR=$HOME/kernel-source \
        KOUT=$HOME/kernel-prepared \
        LLVM=1
    
  8. 加载模块:

    adb push src/barebone/agent/linux/frida-agent.ko /data/local/tmp/
    adb shell su -c 'insmod /data/local/tmp/frida-agent.ko'
    

该模块只能加载到与构建时完全相同的内核上。内核会精确比较版本字符串。即便是同一内核分支的不同构建也无法工作。

更多信息请阅读module README。

完整更改日志:

  • gumjs:修复 JS 内部的原生故障被后续处理器恢复后,分离时挂起的问题。 现在当线程存活时,我们会重新平衡 Interceptor 事务,而不是将其结束两次。感谢 @pandasauce 报告此问题并帮助追查。
  • arm64:检测跳入正在重定位的范围的分支,防止 Interceptor 重写某个分支后,使其落在自身重定向补丁中间。 感谢 @WHW0x455 提供此修复。
  • python:修复 attach() 的 linker_notifier_offsets 关键字参数,恢复 Script.enable_debugger() 的默认端口,并恢复对远程设备和相关 API 的证书选项进行编组。
  • barebone:支持将 agent 作为 Linux 内核模块运行。agent 现在以 .ko 形式在目标内部启动, 暴露用于传输的字符设备,并可通过普通的 frida-server --device=barebone 实例访问。
  • deps:添加一个由 picolibc 和 compiler-rt 组成的软浮点裸机 SDK。这为 none-arm64-softfloat 变体提供了在通用寄存器中传递浮点值方面保持一致的 libc 和运行时。
  • deps:在 CI 中构建软浮点 SDK,在花时间安装工具链之前检查已发布的 bundle,将 libc 头文件排除在 devkit 头文件外, 使用 SDK 作为 sysroot,并确保配置时的链接检查能正确解析 libc。
  • deps:升级 GLib、libffi 和 QuickJS,以获得 freestanding 修复、向量汇编器指令修复、优先级爬升解析器和相应的 x18 修复。
  • arm64:在软浮点目标上,通过为 memcpy、指针扫描和 Interceptor 的寄存器重排使用标量回退,避免 FP 和 SIMD 代码。
  • gumjs:在裸机上限制 QuickJS 栈,重新启用其栈检查,使解析器在耗尽这类主机可能提供的小栈之前停止。

Frida 17.16.4 发布

这是一个快速错误修复版本,用于恢复近期 bindgen 重写中发生回归的部分 Python 绑定 API 和类型定义范围:

  • bindgen:恢复其余公共名称。cancellable 装饰器、RPCResult、make_rpc_call_request()、make_auth_callback() 和 ScriptExportsAsync 现在重新从 frida.core 公开。
  • bindgen:为 facade 的 on()/off() 辅助函数生成信号回调重载。这意味着格式错误的信号处理程序现在会被类型检查器捕获,而不是悄悄地被当作任意可调用对象放行。
  • bindgen:恢复基于 .gir 的生成器遗漏的 facade 成员:get_device()、get_device_matching()、enumerate_devices()、shutdown()、Cancellable.connect() 和 Cancellable.disconnect()。
  • bindgen:恢复 facade 的类型定义范围。生成的软件包再次附带预期的类型别名和注解,包括模块函数、只读选项属性,以及此前缺失的 _frida.pyi 条目。

Frida 17.16.3 发布

又一次快速错误修复版本,解决 Python 绑定中的两个问题:

  • bindgen:修复可选关键字参数的编组。现在会省略 None 值,而不是将其传给带类型的 setter。
  • bindgen:修复集合值关键字参数;遍历父链时,会将它们映射到适当的 select_ 或 add_ 方法。这会影响 specs、omits、externals、PID 和 identifiers。

Frida 17.16.2 发布

又一个快速错误修复版本,修复 Darwin 和 Linux 上的 frida-helper 会让嵌入方 stdio 管道保持打开的问题。

此前 helper 会在启动时继承这些流,以便之后供 Device#spawn() 配合 stdio='inherit' 使用。现在,这些流会随每个此类请求传给 helper。

  • darwin:将 helper 自身的 stdin、stdout 和 stderr 重定向到 /dev/null。
  • linux:应用与 Darwin 相同的修复。

Frida 17.16.1 发布

这是一次快速的错误修复版本,包含两项以 Darwin 为重点的修复:

  • apple:不再强制使用经典链接器。这是针对 Xcode 15.0 beta 7 问题的临时方案,当时现代链接器会过度链接 libresolv。现代链接器已不再这样做,而 ld-classic 会遗漏 __DATA_CONST 上的 SG_READ_ONLY,导致较新的 dyld 拒绝我们的映像。
  • darwin:将 CodeSegment 限制到旧内核。恢复后的签名 dylib realize 路径会让现代 XNU 接受我们的签名并映射页面,随后可能在 iOS 15.6.1 及更高版本上触发内核恐慌。现代内核现在会回退到 mprotect,并像以前一样暂停线程;需要该路径的旧越狱内核仍可使用签名段路径。

Frida 17.16.0 发布

这次是一个大型版本,包含安全加固、平台修复和多项 API 打磨。非常感谢 @hsorbo 和 @SamSunNV 的贡献。

主要变化包括:

  • spawn-gating:使其具备故障安全能力并限定作用域。系统级 Linux eBPF spawn gater 现在需通过新的 SpawnGatingScope 显式启用;所有会挂起进程的 gater 共享一个看门狗,若捕获的进程挂起过久,就禁用 gating 并恢复全部进程。这样可避免客户端消失或停止恢复 spawn 时卡死全系统的进程创建。
  • spawn-gating:在 HostSession 上新增 spawn_gating_disabled(reason) 信号并向上传递到 Device,使客户端知道看门狗何时介入。
  • python:根据 Frida GIR 自动生成 Python 绑定,并通过新的 frida.aio 包支持 asyncio。
  • swift:根据 Frida GIR 自动生成 Swift 绑定。
  • auth:关闭认证通道前刷新待发送的 INVALID_ARGUMENT 回复,使客户端可靠看到令牌被拒绝,而不是连接直接关闭。
  • fruity:在执行 threaded 和 chained fixup 前应用各段保护,修复 arm64e 上的上传注入。可写数据段因此能无故障地接收重定位和认证后的指针,同时仍避免任何 rwx 映射。感谢 @hsorbo!
  • darwin:生成带 exec-segment 字段和非空标识符的现代 SHA-256 CodeDirectory,使现代 iOS 重新支持 CodeSegment 实现。实现会先探测现代形式,必要时回退到旧形式,并缓存可用策略。
  • darwin:通过修补暂存页面在运行时探测 CodeSegment 支持,不再依赖 XNU 版本猜测这种因内核而异的行为。
  • gumjs:在 iOS 上避开 macOS 专用 MAP_JIT 路径,改用 Gum 自身的 JIT 分配路径,使 V8 能在 iOS 应用沙箱内执行 JIT。
  • darwin:在 add-image 桩经 resident notifier handler 指针跳转前为其签名,修复 arm64e attach 崩溃。
  • darwin-mapper:对 threaded bind 跳过存储;解析后的目标已位于链处理器符号表中,而默认段/偏移可能指向只读 __TEXT。感谢 @hsorbo!
  • arm64-writer:新增 PACIA 和 MOVK 指令生成器,可用于内联签名指针和在生成代码中构建 ptrauth discriminator。感谢 @hsorbo!
  • x86:在 Stalker 中保留 AVX-512 状态。在 AVX-512 主机上保存并恢复 zmm0-15 的上半部分、zmm16-31 和 k0-k7 opmask 寄存器,修复跟踪使用 EVEX 的 libc 例程时的崩溃。
  • x86:新增 AVX-512 CPU 特性检测,以及 Stalker 保存寄存器所需的 writer 生成器。
  • x86:在 CpuContext 中公开 XMM 寄存器;可用时以实时保存区为后端,并新增 gum_cpu_context_copy() 和 boxed 类型以安全持久化。感谢 @hsorbo 带来的愉快协作!
  • interceptor:模块卸载时丢弃 Hook,不再尝试恢复已取消映射内存中的函数序言。感谢 @SamSunNV!
  • module-registry:修复程序头未映射在 ELF 头旁边的模块(如 libgit2)的 ELF 范围计算。尽可能根据程序头计算,仅在必要时回退到 /proc/self/maps。
  • memory:完成内部调用方到 gum_memory_allocate() 和 gum_memory_free() 的迁移,并移除旧 gum_alloc_n_pages() 系列。
  • windows:展开 <arch>、在各架构目录中查找辅助程序,并由管理器生成唯一 rendezvous 名称传给所有辅助服务,以修复已安装资源中的辅助程序发现。
  • windows:改进 MSVC 交叉构建:保持 arm64->x86 构建为交叉构建;各编译器使用自己的 include 和库路径;为原生构建机工具保留环境中的 INCLUDE/LIB。
  • build:通过新的 glib.wrap 预先解析 GLib;根据 GLib 变体确定树内载荷;为交叉构建配置原生语言;避免把父构建机选项转发到 compat 构建。
  • deps:使用当前 GitHub Actions Xcode 重建预构建包,采用更新后的 arm64e ABI。
  • compiler/barebone:将 @types/frida-gum 升级到 19.10.0。
  • tests:字节码测试在丢弃最后一个引用前先卸载脚本,修复负载下偶发的拆卸竞态。感谢 @hsorbo!

Frida 17.15.5 发布

这是一个快速错误修复版本,包含 @dezige131 提供的 Android 修复,以及 @hsorbo 提供的多项 Darwin 和 Gum.Memory 改进:

  • android:当目标进程未映射启动映像时,容忍暂时性的 USAP 补丁未命中。
  • darwin:在较新的内核上重新启用 CodeSegment。vm_remap 的 OVERWRITE 技巧在 iOS 17.6 及更高版本上再次有效,因此可重新启用 CodeSegment。
  • memory:修复 patch_code 中的挂起死锁。现在先在暂存缓冲区准备补丁,使 apply 回调能在挂起其他线程并无锁复制回原处之前自由分配内存。
  • memory:提高 patch_code 在并发和失败情况下的安全性。提交任何字节前先将全部目标页面设为可写;只复制已修改的字节;刷新指令缓存前将页面恢复为 RX。
  • memory:把三种补丁策略提取到各自的辅助函数中,在不改变行为的情况下简化分派器。

Frida 17.15.4 发布

这个快速发布的版本带来了几项实用改进:

  • gumjs:添加 Checksum copy 和 peek 方法。感谢 @mrmacete!
  • defs:添加对 Capstone 6 的支持。感谢 @kripticni!
  • darwin-symbolicator:补上缺失的锁,并在跳转到清理流程前初始化模块。 感谢 @comex!
  • qml:在较新的 clang 上抑制 Qt __yield 错误。
  • barebone、compiler:将 @types/frida-gum 升级到 19.8.0。
  • 将 FridaCore 升级到 17.15.3。

Frida 17.15.3 发布

这是一次快速的错误修复版本,于当天晚些时候发布,因为软件开发很难,而且它显然很喜欢提醒我们这一点。

  • darwin:在激活 interceptor 前填充模块注册表。第一次 gum_interceptor_obtain() 会激活 unwind broker,其后端通过模块注册表解析 libdyld。在获取初始快照前这样做,可能重新进入空注册表,并在查询 NULL 模块时崩溃。现在会先为模块生成快照,再开始跟踪变更。

Frida 17.15.2 发布

这是一个快速错误修复版本,包含 @wave-sky 针对 Android 10 上生成进程的修复:

  • linux:修复 Android 10 上的载荷基址选择。由于 Android 的 XOM 机制使 libstagefright.so 仅可执行,生成进程可能因远程连接错误而失败。现在选择目标库时 不再要求读取权限,同时会考虑更多媒体共享库,并强制设置读取与执行权限,以便载荷运行。

Frida 17.15.1 发布

这是一个快速错误修复版本,包含以下修复:

  • darwin:修复非 arm64e 构建中的未使用变量警告。
  • linux:修复涉及多个 GumModuleRegistry 实例时 musl RTLD 调用点的发现逻辑。现在改为扫描链接器的磁盘镜像而非实时内存,从而保留原始指令,并允许链式拦截器挂钩相同的已加载地址。

Frida 17.15.0 发布

是时候发布新版本了,本次在 Gum 和我们的动态链接器集成中带来了一些令人兴奋的改进:

  • gumjs:添加 Process.getThreadById() 和 Process.findThreadById(),底层由新的原生 find_thread_by_id() API 支持,可按 ID 查找单个线程,无需枚举所有线程。
  • gumjs:添加 Process.getFunctionRange(),这是一个便捷包装器,与现有 findFunctionRange() 匹配,它会抛出异常而不是返回 null。
  • gumjs:修复附加线程观察器时的线程枚举死锁。现在我们会在执行原生枚举时释放 JS 运行时锁,并在之后构建 JS 对象。
  • gumjs:将剩余通过字符串拼接生成的查找错误现代化为模板字符串。
  • darwin:重做现代 dyld 的模块观察。近期 dyld 会在受保护栈上持有加载器写锁时调用其映像加载通知器,这意味着观察器无法安全地回调 dyld。我们现在为 FULL teardown 使用常驻的 _dyld_register_func_for_add_image() trampoline,在脱离写锁的普通栈上交付,并挂钩 RuntimeState::decDlRefCount 以处理移除。
  • darwin:无需 dlopen() 即可解析模块导出。这避免在 dyld 仍在加载映像时强制运行模块初始化器,包括 Objective-C +load。
  • linux:修复 musl RTLD 通知器挂钩。我们不再内联挂钩只有一条指令的 _dl_debug_state stub 并破坏后续的 __dl_seterr,而是挂钩链接器的调用点。
  • ci:将 GitHub Actions 的使用从已弃用的 Node.js 20 运行时上迁移。
  • barebone, compiler:将 @types/frida-gum 升级到 19.7.0。

Frida 17.14.1 发布

这是一个修复 GumJS 问题的快速错误修复版本:

  • gumjs:修复 ControlFlowGraph.toJSON() 中的栈溢出。序列化循环块图时会无限 递归,因为 BasicBlock.toJSON() 会将 successors、predecessors 和 immediateDominator 生成为新的 BasicBlock 对象。这意味着 JSON 基于对象身份的 循环检测始终不会触发,最终导致原生栈溢出。现在相邻块改为以起始地址表示, 而顶层仍会完整列出各个块。

Frida 17.14.0 发布

今天发布的版本旨在降低失控脚本带来的风险。衷心感谢 @tpetsas 提交最初的 Gum PR,推动了这项工作。

  • script:添加 Script.interrupt(),它会中止当前正在执行的任何 JavaScript, 同时让脚本保持加载并可再次运行。这对于希望通过 Ctrl+C 从失控求值中恢复的 REPL 尤其方便。在没有代码执行时进行中断不会产生任何效果,因此操作刚结束后 到达的 Ctrl+C 不会干扰下一个操作。
  • script:添加 Script.terminate(),它会中断执行并卸载脚本,因此陷入长时间 运行或无限操作的脚本仍可被彻底清理。
  • gumjs:为 QuickJS 和 V8 实现中断与终止支持。QuickJS 现在会轮询每个脚本的 中断标志,而 V8 使用 Isolate::TerminateExecution(),并在执行展开后清除 粘滞的终止状态。
  • core:通过 AgentSession、载荷脚本引擎和公共 Script 类接通新 API。 Barebone 会话会将这些操作报告为不受支持。
  • core:从 enumerate_processes() 以 metadata 范围公开进程 argv,与 path 一致,而不再将其限制在 full 范围。

Frida 17.13.0 发布

又到了发布新版 Frida 的时候,本版本带来了一些 API 和内省方面的改进:

  • core:向枚举到的进程参数添加 argv。请求完整范围时,Frida 现在会在 Windows、macOS、Linux 和 FreeBSD 上公开目标进程的命令行参数。
  • swift:通过类型化访问器公开新的 argv 进程参数;后端提供此参数时,返回目标的命令行参数。
  • gumjs:为 ControlFlowGraph 及相关类添加 toJSON() 支持,使它们传给 JSON.stringify() 时能得到良好呈现。
  • gir:在合成的文档中输出文件名和行信息,便于将生成的 API 文档追溯到源代码。

Frida 17.12.0 发布

新版本带来了 Gum/GumJS 中全新的代码形态分析工具箱、大量 Linux 注入器 加固与清理修复、大幅提升 Windows arm64 稳定性的工作,以及 Gum 和 Core 各处已有文档说明的公共 API。

亮点:

  • gum:添加原生控制流图模块,包括基于解析器的图构建、 Cooper-Harvey-Kennedy 支配节点算法,以及按最近优先顺序枚举支配位置。
  • gumjs:添加 ControlFlowGraph 和 BasicBlock。
  • gum:添加 Process.find_function_range()。它不需要符号,因此也适用于 已剥离符号的二进制文件。
  • gumjs:添加 Process.findFunctionRange()。
  • interceptor:添加按函数和按监听器刷新,使调用方能够等待自己的 Hook 排空,而不会被无关的待处理工作阻塞。
  • linux:当采样 PC 落在很小的系统调用包装函数中时,通过遍历栈来寻找 可 Hook 的触发点,从而提高多线程目标中的注入器可靠性。
  • linux:通过 /proc/<pid>/fd 而不是 /proc/self/fd 加载 agent, 使附加的调试器解析出的对象路径与目标进程一致。
  • linux:以与安装对称的方式恢复被修补的触发函数,避免另一个线程执行 写入到一半的序言时产生竞态。
  • linux:捕获 libbpf 诊断信息并将其包含在抛出的错误中,不再泄漏到 stderr。
  • linux:使用实际的 bootstrap stub 确定触发候选项大小,避免无谓拒绝 体积较小但频繁执行的 libc 例程。
  • linux:当缺少权限导致 eBPF/perf 采样不可用时,回退为轮询 /proc/<pid>/task/<tid>/syscall。
  • linux:在清理时排空线程注册表,修复卸载期间线程频繁变化所导致的 use-after-free。
  • linux:使用新的 CFG 机制重定位 start_thread Hook,使 Hook 落在安全的 支配指令上,而不是覆盖仍在使用的调用位置。
  • linux:通过反复进行锚点探测和锁交叉检查,直到两者结果一致,增强高频线程 变化情况下的 pthread 布局检测。
  • x86:使 can_relocate() 能够感知重定位场景,拒绝那些必须跨越调用或 类系统调用指令的在线重定位。
  • meson:构建捆绑的 Capstone 时启用所有架构,与预构建 SDK 保持一致, 让跨架构反汇编随处可用。
  • stalker:修复代码 slab 相距超过 128 MB 时远距离 backpatch 尾声丢失 BL 的问题;该问题会破坏栈并导致崩溃,在 Windows arm64 的宽广地址空间中暴露。
  • stalker:检测 Windows 上的线程退出,从而不再跟踪正在终止的线程进入 ntdll 的清理流程。
  • exceptor:在 Windows arm64 上通过 RtlRestoreContext() 而不是 longjmp() 恢复执行,修复崩溃恢复;后者的栈展开会拒绝我们的合成帧并终止进程。
  • gdb:修复 iOS debugserver 等 LLDB stub 上的寄存器访问;此前会表现为 “Failed to attach: invalid integer value: E03”。
  • gum:为公共 API 编写文档:Interceptor、Stalker、Exceptor、Module、 ModuleMap、ModuleRegistry、MemoryMap、MemoryAccessMonitor 和 DarwinGrafter。
  • core:为公共 API 编写文档,并将 Vala 文档注释注入 GIR。
  • ci:发布 GObject 内省数据。
  • ci:添加 windows-arm64 原生任务。
  • barebone/compiler:将 @types/frida-gum 升级到 19.6.0。

Frida 17.11.0 发布

这是一个内容丰富的版本,重点是让 Frida 进入更棘手的环境,并投入大量精力改进 Barebone 后端、Linux 注入路径和 Gum 底层机制。感谢 @hsorbo 与我们共同度过愉快的 iOS 内核黑客松,并提交增加 Segger J-Link 支持的 PR;也感谢 @ltlly 对 Stalker 的贡献。

主要变化:

  • linux:为 ptrace 槽已被其他跟踪器占用的目标新增无 ptrace 注入后备方案。Frida 会改用 /proc/$pid/mem,把引导代码写入目标以映射并运行加载器,支持 x86、x86_64 和 arm64。对于从不调用 malloc 的安静目标,Frida 会采样 CPU 活动,解析最热的 libc 叶函数并改在该处 Hook。
  • barebone:Virtualization framework 客体的内核内插桩取得重大进展,包括 VZ 内核 GDB 桩客户端、物理内存桥接、fileset kernelcache 和 kext 处理、按段重定位,以及通过主机修补内核文本。
  • barebone:通过 vsock 建立内核内 hostlink,包括 PAC 签名回调和异步连接处理。W^X 操作现在通过 RPC 完成,使 NativeCallback、Interceptor、Memory.patchCode() 等无需依赖会让研究内核 panic 的 BRK 回调。
  • barebone:让 Interceptor 和 Stalker 在内核中工作,包括经物理桥接实现可写重映射、修改页表后刷新 TLB、从 Stalker 排除 Agent 自身范围,以及让线程 ID 可安全地经 JavaScript 往返。
  • barebone:提升内核注入稳健性。Agent 就位后分离调试桩;调用函数时容忍线程迁移;从缓存 MMU 参数查询页面大小;就近分配失败时返回 NULL 而不是 panic。
  • barebone:为 none-arm64 资源、devkit 和 Barebone Agent 添加 CI。
  • barebone:省略 Arm64 向量上下文,避免溢出狭小的内核栈。
  • gdb:改进远程桩兼容性。缺少 g/G 时回退到逐寄存器访问;检测 vCont 支持并提供后备;接受空 qRcmd 回复;按 qXfer 支持加载目标属性;访问寄存器前切换线程;始终发送正确校验和。感谢 @hsorbo!
  • compiler:修复归档符号重命名。现在只在字符串表中重写符号,而不是匹配整个归档中的字节;同时更新归档索引,使 COFF 归档重命名后仍能正确链接。
  • module:为 GumExportDetails 新增 size,通过 QuickJS 和 V8 中的 enumerateExports() 公开导出大小。ELF 报告 st_size;无法提供信息的平台报告 -1。
  • memory:在 Linux 6.11 及更高版本使用 PROCMAP_QUERY ioctl 加速保护查询,并缓存回退到解析 /proc/self/maps。让代码可读时也会保留页面保护,并共享旧版 manylinux 工具链所需的 O_CLOEXEC 后备。
  • stalker:在 Arm 和 Arm64 后端为待处理字面量预留空间,使每条指令都带 callout 的大型无分支代码块不再溢出 slab 并破坏相邻内存。感谢 @ltlly!
  • process:限制 aarch64 ucontext 记录遍历,避免畸形记录或 libunwind 较小的上下文布局让回溯器崩溃。
  • vapi:新增 X86Writer 绑定,使 Vala 代码能生成 x86 和 x86_64 指令,与现有 Arm64Writer 支持一致。

Frida 17.10.1 发布

这是一个错误修复版本,其中还加入了一个崭新的内存扫描辅助函数,以及一些 Darwin、Android 和构建系统修复。非常感谢 @cylentsec 和 @AeonLucid 的贡献。

  • darwin:在 launchd 代理中支持 ElleKit/palera1n。现在会检测 ElleKit 的注入器门函数, 并让它对 Frida 管理的 PID 返回 false,从而防止已启动进程遭到重复注入。感谢 @cylentsec!
  • darwin:恢复选择性异常掩码,并将非断点异常转发给系统处理程序,同时保持现有 arm64e PAC 修正路径有效,以此修复 ElleKit 的进程启动兼容性。修复 #1239。感谢 @cylentsec!
  • android:修复 Nothing OS 上的辅助程序初始化。感谢 @AeonLucid!
  • gumjs:公开 Memory.findPointers(),其底层由新的 gum_memory_find_pointers() 辅助函数支持。 它提供一种专门且经过 SIMD 加速的方式,可在一个或多个范围中查找与一个或多个值匹配的 指针对齐字。
  • memory:添加 gum_memory_find_pointers(),支持并行范围分片以及 SSE2、NEON 等各架构内核。
  • interceptor:修复 x86 stdcall 离开时的回收问题。由被调用方清理栈的返回可能使调用栈无法追踪 正在返回的帧,进而发生崩溃。
  • process:拒绝过期的 Darwin 文件映射结果,修复 Rosetta 下匿名区域被错误归属于无关文件映射的问题。
  • vapi:将 gum_darwin_read 的 length 绑定为 gsize,避免向 4 字节槽位写入 8 字节数据。
  • gir:确保内省辅助可执行文件在 g-ir-scanner 尝试运行它之前完成链接,修复 Ubuntu noble 暴露出来的竞争条件。
  • ci:由于 GitHub 的 Intel macOS runner 已下线,现在通过 Rosetta 在 arm64 主机上构建, 继续维持 macOS/x86_64 覆盖。
  • build:修复针对 arm64e 构建时的警告。
  • bindings:将 @types/frida-gum 升级到 19.4.0。

Frida 17.10.0 发布

Frida 17.10.0 已发布,为 Gum 内部机制带来大量新能力,并打磨了许多棱角。

主要变化:

  • gum:为生成代码新增通用展开代理。Interceptor 创建时即获得展开支持,使异常和回溯可穿过跳板传播;Stalker 则在 Darwin 和 Linux 上改为始终执行 PC 转换。
  • core:将 Darwin 展开机制迁移到 Gum 新的通用 UnwindBroker 和 UnwindSectionsProvider API;旧 UnwindSitter 现在只注册入侵者范围。
  • interceptor:用可组合选项结构替换旧 attach 标志,覆盖暂存寄存器选择、在线/离线场景、重定位策略、替换数据和监听器数据。
  • gumjs:向 JavaScript 公开新的 Interceptor 插桩选项;attach()、replace() 和 replaceFast() 现在可接收包含目标和新插桩配置的选项对象。
  • interceptor:支持自定义重定向生成器和进程级默认选项。调用方可提供写入被 Hook 函数序言的指令序列,使 Hook 点更难预测。
  • gumjs:在 QuickJS 和 V8 运行时中公开自定义重定向生成器、重定向空间提示和默认 Interceptor 选项。
  • interceptor:修复异常或 longjmp() 越过被 Hook 调用后发生的挂起。现在会正确回收未到达 on-leave 跳板的调用帧,防止 gum_interceptor_flush() 永久自旋。
  • unwind-broker:支持 32 位 ARM EH ABI,包括 ARM 特有的 personality 和 exidx 处理。
  • unwind-broker:通过原始展开例程读取 throw 和 resume 指令指针,修复经过 Stalker 代码的异常处理。
  • stalker-x86:在 Android 上启用展开支持,与 arm64 后端一致。
  • stalker-arm64:不再要求就近分配 slab,代码和数据 slab 可分配在任意位置。
  • memory:代码补丁完成后恢复页面保护;除非原本为 RWX,否则重新收紧为 RX。
  • exceptor:新增仅处理器模式,安装 Frida 信号处理器但不 Hook signal() 和 sigaction()。
  • module-registry:允许在 ELF 和 Darwin 上自定义 RTLD 通知器偏移,有助于提高 Frida 隐蔽性。
  • core:通过 SessionOptions 公开 Agent 功能开关和链接器通知器偏移,包括 exceptor 模式、展开代理、退出监视器和线程挂起监视器设置。
  • base:修复使用 frida-1.0/<arch>/ 的已安装布局中的资源解析;此前探测的路径仍包含字面量 <arch> 标记。
  • devkit:使 Gum 示例与新的 attach 选项同步。
  • deps:将依赖升级到 20260531,包括 Capstone d536b15,并把 @types/frida-gum 更新到 19.3.0。

Frida 17.9.11 发布

这是一个快速错误修复版本,进一步改进了 Darwin 加固兼容性,完善了一些 Barebone 目标,并包含 @Lixhr 贡献的 arm32 重定位器修复:

  • agent:在加固的 Darwin 任务上启用 Gum.Exceptor。旧的选择退出机制源自 Mach 异常端口时期,而得益于 Gum 最近的改进,POSIX 信号后端现在已可在 arm64e 上运行。
  • darwin:先通过匿名页面洗净嵌入式 agent,再将其重新映射到目标中。这样可避免 在较新的加固内核上携带 frida-server 自身 __DATA 映射的代码签名状态。
  • exceptor:通过 trampoline 执行 long jump,让异常处理程序能够在 arm64e 上 重定向 PC 和修改寄存器,从而绕过 XNU 的 sigreturn 验证。
  • exceptor:直接从信号处理程序执行 long jump,而不是尝试通过信号上下文重定向 PC,从而修复 arm64e 作用域恢复。
  • darwin:操作当前任务时跳过 pid_for_task(),省去一次 Mach 往返。
  • process-darwin:在较新的 arm64e 系统上从进程外读取 dyld 镜像元数据时剥离 PAC, 并妥善处理 NULL 读取。
  • process-darwin:容忍 sysctlbyname("kern.version") 在受限 XPC 沙箱中失败。
  • arm32-relocator:重定位 B<cond> 时保留条件码。
  • meson:在没有 libsoup 的 barebone 目标上跳过 inspector。
  • vapi:绑定 gum_memory_allocate() 系列 API。

Frida 17.9.10 发布

这是一个包含两项修复的快速错误修复版本,让一切继续顺畅运行:

  • android:匹配待处理的启动请求时处理 android:process。声明自定义进程的 Activity 最终会获得一个由 zygote fork、名称类似 com.example.app:foo 的进程,而启动请求以包名作为键。现在会在匹配前移除冒号后缀,从而避免启动超时。感谢 @pakbaz-dev 追踪并修复此问题。
  • package-manager:修复 @scope/name 这类 scoped 软件包名称的解析。此前我们把 scope/name 当作版本范围并获取注册表根目录,最终以误导性的 missing dist-tags 错误失败。

Frida 17.9.9 发布

又一个快速错误修复版本,重点处理 GumJS 边界情况,并由 @agent-polyblank 完善 README:

  • gumjs:预先将 NativeCallback 返回值清零,并在转换失败时跳过复制 FFI 值。这修复了一项回归:未初始化的栈数据可能返回给原生代码,包括返回结构体的情况。
  • gumjs:在 QuickJS 运行时中,当结构体的数组长度与字段数量不匹配时抛出异常,而不再静默转换失败。
  • gumjs:在 V8 未处理异常接收器中处理空栈跟踪,避免 Error 来源不在任何 JavaScript 栈帧中时发生崩溃。
  • readme:添加构建与测试说明。感谢 @agent-polyblank!

Frida 17.9.8 发布

这是一个快速发布,包含一项 GumJS 错误修复、一项小型 API 改进以及编译器类型版本升级。非常感谢 vfsfitvnm 和 Francesco Tamagni 对 GumJS 的改进:

  • gumjs:修复 NativeCallback 返回结构体。libffi 针对 FFI_TYPE_STRUCT 的闭包结果路径此前未实现,会触发 g_assert_not_reached()。现在会遍历结构体返回值(包括嵌套结构体),并把各叶字段的自然字节复制到返回缓冲区。QuickJS 和 V8 回调调用器也会按 rtype->size 确定临时返回缓冲区大小,使结构体能按预期容纳。感谢 @vfsfitvnm 提供修复。
  • gumjs:为 Memory.alloc() 的选项对象新增可选 protection 字段,默认值为 "rw",以保持现有行为。这样便能在内存无法从 rw 切换为 rx 的环境中分配页面对齐的可执行内存,例如未越狱的 iOS 26+。感谢 @mrmacete。
  • compiler:将 @types/frida-gum 升级到 19.1.0。

Frida 17.9.7 发布

这是一个快速错误修复版本,包含对 Darwin 后端、Stalker 和 Compiler 的修复:

  • darwin:在强制执行调试器映射时,确保新分配的代码页包含在页计划中。这修复了较新 Apple 设备上 iOS 26+ 中的 Interceptor 和 Memory.patchCode:在这些设备上,即使是新分配的可执行页,也需要页计划才能在执行时满足代码签名检查。感谢 @mrmacete 提供修复。
  • stalker-x86:避免在 Windows 7 WoW64 上保存和恢复 AVX2 YMM 的高半部分。从 Stalker 的 JIT 代码执行此操作可能损坏 wow64cpu 状态,使下一次系统调用在 wow64cpu!CpupReturnFromSimulatedCode 中崩溃。由于 fxsave 已覆盖低 128 位,且 x86 Windows ABI 不会在调用之间保留 YMM 的高半部分,我们现在会在 NT 6.1 WoW64 上跳过此操作。感谢 @fitblip 提供修复。
  • compiler:修复使用 Go/cgo 后端时的 Windows 崩溃。我们原先用 mingw 的 CRT 分配回调字符串,却让 Vala 端使用 MSVC 的 UCRT 释放它们,这意味着涉及不同的堆,Windows 很合理地以 STATUS_HEAP_CORRUPTION 紧急刹车。这些字符串现在会在回调返回后由 Go 端释放,Vala 端则将其视为非所有,并在需要时复制。

Frida 17.9.6 发布

这是一个快速错误修复版本,用于解决 rootless iOS 上的回归:Darwin 后端此前对路径前缀处理得过于积极。

  • darwin:修复 rootless iOS 上的 Agent 路径。Frida.agent_path 现在是已解析的绝对路径,因此再在前面添加 sysroot 或 CRYPTEX_MOUNT_PATH 会重复 rootless 前缀并生成不存在的路径。服务器现在把检测到的前缀直接传给 TemporaryDirectory.use_sysroot,修复 #1232。

Frida 17.9.5 发布

事实证明软件开发很难,所以这里又有一个当天发布的错误修复版本。此版本改进了 Darwin 后端:

  • darwin:握手出错时回收辅助进程。GDBus 可能会在 ChildExitMonitor 观察到子进程退出前报告 EOF,导致 child_exited 仍为 false,并使 obtain() 跳过 arm64e 后备重试。

Frida 17.9.4 发布

Frida 17.9.4 已发布,重点修复并改进 Darwin、Apple TLS 兼容性,以及几个棘手的正确性问题:

  • darwin:把辅助程序临时文件存放在容器的 Caches 目录,而不是 ~/.Trash。xctest 沙箱禁止从 .Trash 执行,而 Caches 在所需场景中均可写且可执行。
  • darwin:用 socketpair 替换辅助程序握手所用的文件系统 socket,避免 HOME 深度嵌套(如沙箱容器内)时触及 macOS 104 字节 sun_path 限制。dyld 启动期间辅助程序崩溃现在会更可靠地表现为 PROCESS_NOT_FOUND。
  • darwin:在 installed 模式下也把辅助程序裁剪为 arm64,使用相同的通用二进制后备方案,无需发布两个产物。
  • darwin:跳过无操作的 stdio dup2() 动作。当源 fd 是从 Node 等父进程继承的 FIFO 时,posix_spawn 会以 EBADF 拒绝 dup2(fd, fd)。
  • darwin:使用 posix_spawn 返回值修复错误报告,因为它可能不更新 errno;失败不再显示为“Undefined error: 0”。
  • macos:使用 NSWorkspace 和 LaunchServices 元数据实现 applications API,并支持按 bundle 标识符启动应用。
  • build:确保 lipo 目标存在并安装通用 frida-agent.dylib,在 shared+installed 模式下正确安装 frida-agent。
  • base:在 AssetLocation 中新增平面布局后备,使未安装构建能解析放在库旁边的资源。
  • compat:父构建使用 gioapple 时,在 Apple 平台用 OpenSSL TLS 构建 frida-agent,避免向目标注入 Security、Network 和 CoreFoundation;注入器无法安全完成这种注入。
  • agent:compat 已拥有主机架构 Agent 时避免重复构建,修复 Darwin 通用 lipo 失败。
  • value:修复 Json.Reader 根节点所有权,保持解析器拥有的原始节点存活,避免 json-glib 有缺陷的节点复制行为导致子节点父指针仍指向已释放节点。
  • interceptor:为 dispatcher thunk 指针签名,修复 arm64e 上的共享 deflector。
  • tests:新增 Darwin 启动应用覆盖,并在设置未配置时容忍空的 nvram boot-args 输出。

Frida 17.9.3 发布

又是一个快速错误修复版本,因为软件开发很难,而且它显然很喜欢每天不止一次提醒我们这一点。

  • asset-location:修复 frida-core 静态链接时的已安装资产路径解析。AssetLocation.detect() 可能从主机可执行文件中运行,因此安装在 bin/ 或 sbin/ 下的二进制文件可能让我们 相对于该目录查找资产,而不是相对于已配置的 libdir,例如查找 /usr/sbin/frida-1.0/... 而不是 /usr/lib/frida-1.0/...。我们现在会通过 Meson 配置的 libdir 进行重定向, 同时处理 sbin,并且在 Darwin 上不追加 <arch>:由于肥二进制,默认资产路径没有架构组件。

Frida 17.9.2 发布

Frida 17.9.2 已发布。这个版本重点打磨构建系统和打包基础设施,同时还带来了新 API、Swift 绑定改进以及大量错误修复。

主要变化:

  • fruity:保持共享 LLDB 会话存活,直至使用它们的最后一个 Gadget 分离。感谢 @mrmacete。
  • elf:更妥善地处理 ELF 后备文件缺失的情况。
  • exceptor:从异常详情中的 arm64e PC 移除 PAC 位。
  • module-registry:使用 r_debug 同步 Linux RTLD 通知,以避免重新进入动态链接器。
  • fruity-syscall-trace:当某个 PID 的符号解析器签名查找失败时,回退到最小签名并继续跟踪。感谢 joe。
  • syscall-trace:添加 include-syscall 支持。感谢 @IPMegladon。
  • stalker-x86:销毁时释放 slow slab,并添加相应辅助函数。感谢 @buherator。
  • compat/build:修复允许的预构建集合为空时的源码构建问题,惠及 FreeBSD 等平台。感谢 @cl45h。
  • build:添加一等的发行版打包支持。Frida Core 现在可以依赖上游 GLib 和系统依赖项构建为共享库;已安装资源位于 lib/frida-1.0 下;支持可重定位的资源发现;生成更干净的 .pc/GIR/typelib 输出;并减少泄漏到安装前缀中的内部子项目产物。
  • apple:在 Darwin 上弃用 OpenSSL。TLS 现在使用 gioapple,证书生成使用 SecKey,libnice 使用 CommonCrypto 和 arc4random_buf,XPC UUID 生成使用 GLib.Uuid,而 macOS 构建会跳过需要 OpenSSL 的 Fruity 代码。此外还新增了 –with-apple-min-os 配置标志,用于提高 Apple 部署目标的最低版本。
  • fruity:把可移植的配对/隧道代码拆分到独立文件;在非 macOS 平台上直接通过 OpenSSL 驱动 TLS-PSK;并修复二进制 plist 序列化器针对 Bytes 值的哈希与相等性判断。
  • core:通过固定已解析的根节点,规避 JSON-GLib 的 Json.Reader 生命周期陷阱,修复启用运行时检查的 GLib 构建中的中止问题。
  • core:修复后续调用 frida_init() 时覆盖 frida_init_with_runtime() 的问题。
  • api:添加 WebRequestHandler、WebRequest、WebResponse 以及端点请求处理程序支持;公开 PortalService 额外端点注册功能。
  • host-session:用捆绑的 PNG 资源替换旧有的硬编码提供程序图标数据,并为本地和模拟器提供程序添加图标。
  • compiler:让动态加载的后端常驻内存。
  • swift:通过 pkg-config 添加 Linux 支持;在 Apple 平台上提供 USE_SYSTEM_FRIDA 逃生开关;添加 WebRequestHandler 绑定、PortalService 端点绑定和 DeviceChange 异步流;扩大 Variant 反序列化覆盖范围;并完善 Swift 6 Sendable 支持。
  • swift:修复 Apple 平台上的 NSNumber JSON 分类、仅使用 CoreFoundation 辅助函数导致的 Linux 构建失败,以及 MSVC 上 Int32/UInt32 枚举原始值不匹配的问题。
  • build:按机器隔离 pkg-config;保留调用方的 PKG_CONFIG_PATH;避开 Strawberry Perl 中损坏的 pkg-config。

Frida 17.9.1 发布

这是一个快速错误修复版本,包含以下改进:

  • package-manager:修复 semver 预发布标识符溢出。此前 "202508252028" 等数字预发布标识符会验证失败,因为 parse_uint() 拒绝超过 UINT32_MAX 的值;使用 uint 的版本比较也受同一溢出影响。现在验证遵循 semver 规则,数字标识符不得包含前导零;比较则改用带长度前缀的字符串比较,可正确处理任意大的数字标识符。

Frida 17.9.0 发布

本版本在 Fruity、Droidy、Linux 和打包层面带来了一批实用性改进和新能力:

  • device:添加 override_option(),用于在创建主机会话时覆盖特定于后端的选项;如果已建立会话,更新将在下一次连接时立即生效。
  • fruity:添加 control-endpoint 后端选项。默认值为 tcp:27042。仅支持 TCP 端点。
  • droidy:添加 control-endpoint 后端选项。默认值为 tcp:27042,但可设为 ADB 支持的任何端点,例如 localabstract:/my-frida-server。
  • android:在仅支持 64 位的系统上跳过 32 位 helper,避免浪费时间尝试启动它。
  • linux:添加基于 eBPF 的 spawn gater 实现。感谢 @NSEcho!
  • linux:支持向组停止状态的 PID 注入。
  • gum:添加将 devkit 打包为 XCFramework 的工具。感谢 @sewerynplazuk!
  • python:添加 spawn gating 示例。
  • python:修复 child gating 示例。

祝使用愉快!

Frida 17.8.3 发布

本版本带来了又一轮修复和文档改进:

修复

  • fruity:修复大于 8192 字节的延迟 CDTunnel TLS 记录导致的 TcpTunnelConnection 停滞。需要时发送最小的虚拟 IPv6 数据报,以触发延迟数据的交付并提高可靠性。感谢 @hsorbo 报告并帮助追踪此问题,也感谢 @tux-mind 确定根本原因。

  • fruity:修复 iOS 26.4 beta 版本上受限环境中的 spawn()。感谢 @mrmacete!

  • fruity:修复 TreeSet 比较器行为:分数相同的传输可能被视为相等而丢弃,导致 Frida 在 macOS 上明明已有 CoreDevice 隧道可用,却优先选择带 lwIP 的 usbmuxd。感谢 @tux-mind 报告并帮助追踪此问题。

  • fruity:处理隧道过早丢失的情况,例如 remotepairingdeviced 崩溃时。

  • android:如果 dlopen(libart) 失败,则调整 RTLD 路径。感谢 @sam0holix!

文档

  • docs:修订 README 中的 macOS 证书标识符,以更好地支持拥有多个 Apple Development 证书的设置,并避免 make 期间出现模糊的证书选择。感谢 @samykamkar!

  • docs:更新 README,在 frida-trace 所需的安装说明中加入 websockets 软件包。感谢 @samykamkar!

Frida 17.8.2 发布

这是一个小型后续版本,为 Android 和 Node.js 绑定带来几项修复与完善:

  • android:同时在匿名内存中检测 setArgV0()。
  • bindings:将 .withTimeout 和 .combine 重新加入 Cancellable;迁移到自动生成的绑定时曾意外遗漏它们。感谢 @hsorbo!

Frida 17.8.1 发布

此版本为 Android、Linux、基于 musl 的系统和较新的 LLVM 工具链带来了大量修复 与兼容性改进:

  • android:仅在 ART 命名空间确实存在时才在其中加载。
  • android:处理 Chrome 的 zygote 进程,使其不受 spawn gating 影响而保持不可见, 同时其子进程继续按预期接受 gating。
  • android:升级到 Android NDK r29,并在所有架构上以 API 21 为目标,因为最新 NDK 已不再支持更低的 API 级别。
  • linux:改进进程枚举,确保始终存在 uid,提高用户查找的稳健性,并正确处理 状态不确定或容量不足的 getpwuid_r() 缓冲区。
  • linux:避免 musl 上的 rtld 通知器死锁。
  • linux:在调试器检查中处理 /proc 缺失的情况。
  • compiler:添加兼容 musl 的后端模式,以持久辅助进程的形式在进程外运行 Go 编译器后端,避免 frida-core 在启动后加载或通过 dlopen() 加载时受到 TLS 限制。
  • libc-shim:补齐更多 stdio API,包括 setbuf()、setlinebuf()、setbuffer()、 __srget(),并修复 glibc + musl 上的 setbuffer() 签名。
  • meson:在需要时使用 FreeBSD 专用版本脚本,修复现代 LLVM/LLD 工具链上的链接。

祝你使用愉快!

Frida 17.8.0 发布

本版本在各方面都带来了重大改进。

系统调用跟踪器

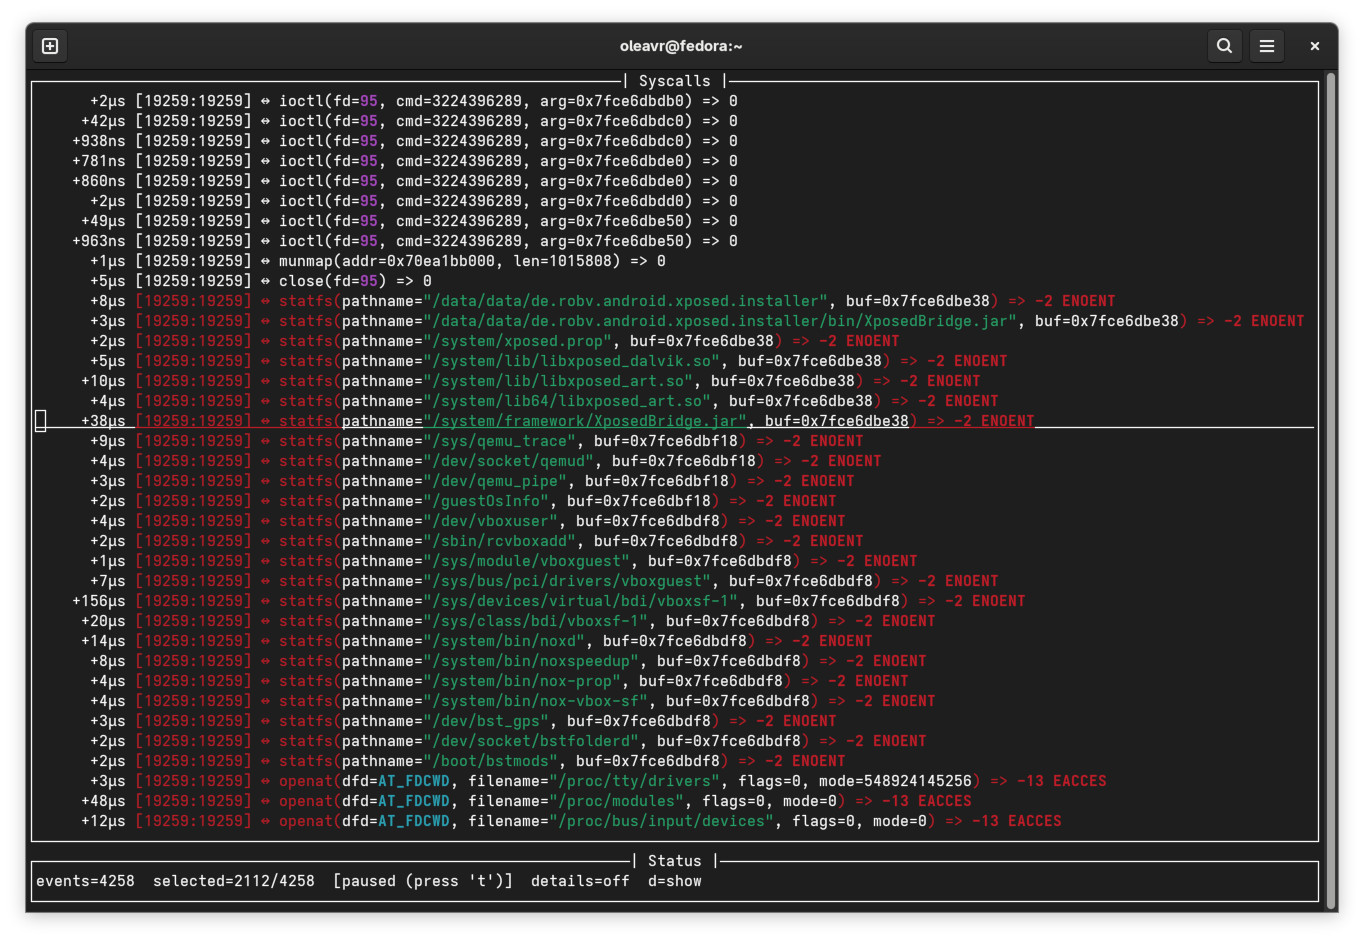
有时,观察特定目标进程内部发生的系统调用很有用。当目标包含某种 Frida 检测、root 检测或其他形式的运行时应用自我保护(RASP)时,尤其如此。在这种情况下,发现用于检查痕迹的系统调用,意味着你可以快速确定需要应用何种插桩或补丁才能绕过这些检查。

正因如此,从 Frida 17.8.0 和 frida-tools 14.6.1 开始,现在可以这样做:

$ frida-strace -U -f com.dexprotector.detector.envchecks

frida-strace-android

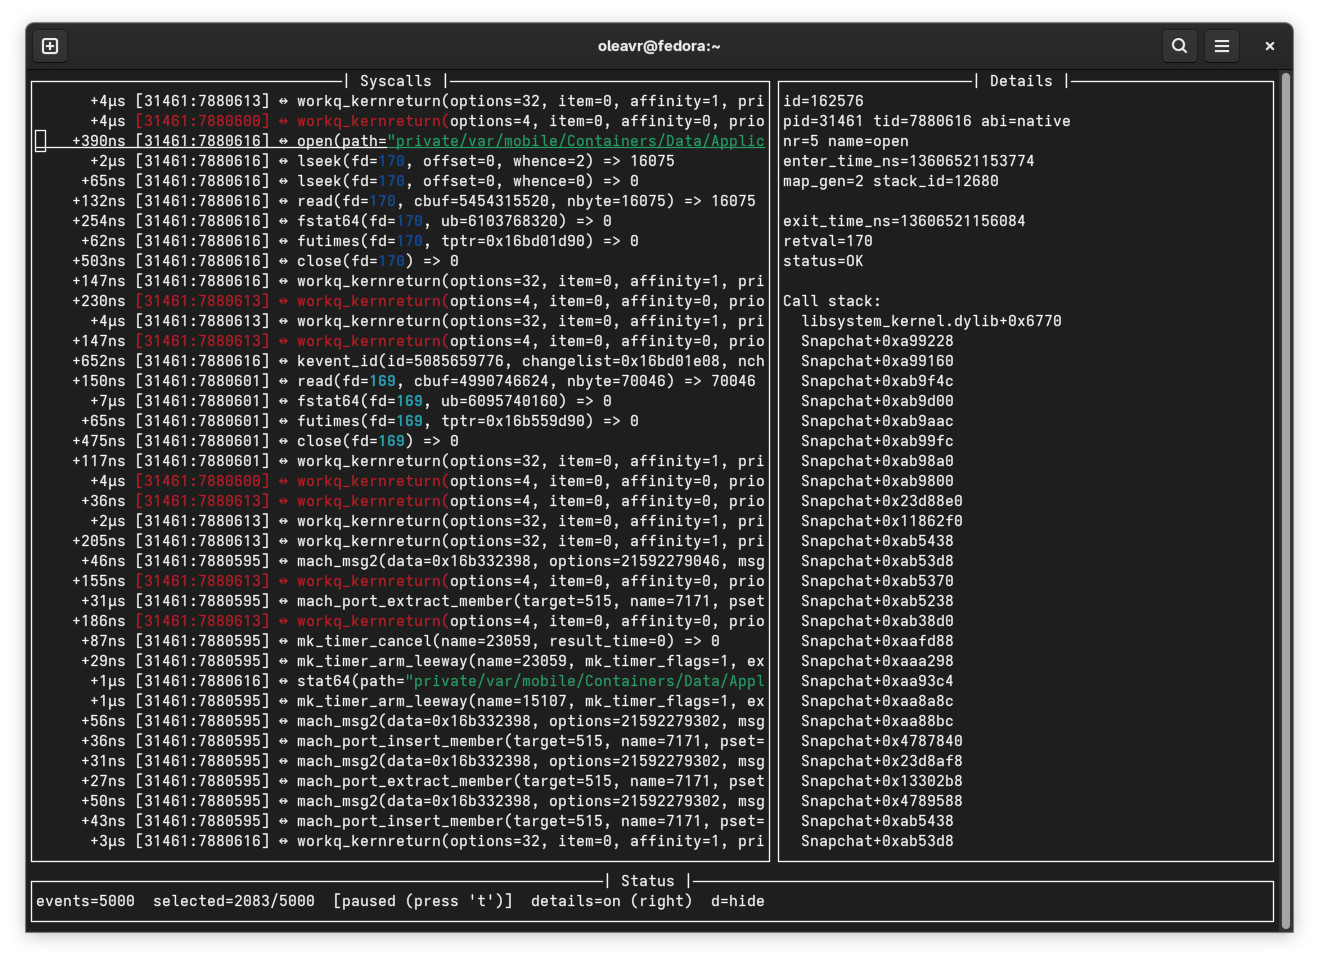
或者,连接一台运行最新 iOS 的 iPhone(无需越狱):

$ frida-strace -U -f com.toyopagroup.picaboo

frida-strace-ios

你还可以任意多次重复 -f 以启动多个程序或应用,也可与 -p $pid 和 -u $username 开关组合使用。不过,iOS 不支持按用户指定目标。这项功能在 Android 上尤其有用,因为每个应用都有自己的用户账户:通过这种方式,可以观察属于特定应用的所有进程中的系统调用。

结束语

本版本还包含许多其他好东西。请务必查看下方的变更日志,了解完整细节。

祝使用愉快!

变更日志

  • fruity:基于 CoreProfile ktrace/kdebug 实现系统调用跟踪,具备系统调用解码、文件系统相关调用的路径重建、拼接调用栈以及符号化支持。
  • 支持启动不可调试的应用:当无法通过 LLDB 启动时,回退到 ProcessControlService,并通过信号暂停它们。
  • dtx:添加 CoreProfileService,扩展 ProcessControlService,升级协议处理,取消缓冲限制,并改进对 nil 参数和批量数据的处理。
  • linux:使 Linux 系统调用跟踪器的 eBPF 后端对验证器更友好,增大 BPF 日志缓冲区,并使 Linux 系统调用跟踪协议与最新的跨平台格式对齐。
  • android:加载 ART/Dalvik VM,并在进程内运行 frida-helper.dex。这消除了大量边缘情况,包括 ROM 兼容性问题。
  • android-helper:通过使用 Looper.prepareMainLooper() 修复某些传音系 ROM 上的初始化崩溃。感谢 @depreciating!
  • android:修复新版 Android 上的链接器检测和导出解析。
  • libc-shim:扩大 stdio 覆盖范围,为 libstdc++ 添加带版本的 fopen/fopen64 支持,并且除非明确请求,否则跳过反初始化,以避免关闭期间的未定义行为。
  • elf-module:必要时回退到 .dynsym,以改进符号枚举,并收紧符号名边界检查。感谢 @danielbaier!
  • gumjs:向 SQLite API 添加列元数据。感谢 @codecolorist!
  • objc-api-resolver:在复制方法前实现已收集的类,避免崩溃和未定义行为。感谢 @mrmacete!
  • websocket/network-stack:通过暂停 libsoup 输入来避免饥饿,并异步处理传入数据报,改善高负载下的公平性。感谢 @mrmacete 和 @hsorbo!
  • atomics:修复 guint64 未自然按 8 字节对齐的 ABI 上的 -Watomic-alignment 警告。
  • gum:添加 Gum.Android vapi 绑定。

另外,也感谢 @hsorbo 一起对 Fruity 相关部分进行愉快的结对编程!

Frida 17.7.3 发布

这是一次快速跟进版本,包含若干 Linux 系统调用跟踪器改进和修复:

  • syscall-tracer:解码 timespec 值。识别 timespec 指针参数,并将其解码为结构化值,而不是不透明字节数组。支持 __kernel_timespec 和 old_timespec32 两种布局。
  • syscall-tracer:修复原始附件生命周期。此前 GVariant 是根据返回前已释放的数据创建的,导致其中留下悬空指针。
  • syscall-tracer:通过编码每个附件预留的空间大小,修复多附件解析。

Frida 17.7.2 发布

这是一次快速跟进版本,包含 Variant 和 XPC 服务层中的若干修复与清理:

  • python:增加转换为 uint64 Variant 的支持。
  • node:不再接受多余的 uint64 Variant 转换。创建 uint64 GVariant 值时请使用 BigInt。
  • node:修复 Variant 转换逻辑错误处理中存在的泄漏。
  • xpc-service:移除对多余转换的支持。

Frida 17.7.1 发布

这是一个快速错误修复版本,因为软件开发很难,而且它显然还喜欢在同一天加演一场:

  • android:将启动完成推迟到 setArgV0(),具体做法是在 selinux_android_setcontext() 中只记录软件包名称,并延迟到 setArgV0() 才联系 RoboLauncher。这样可确保 ART 已准备就绪,使 frida-java-bridge 能够附加到虚拟机。

  • android:重构 Zymbiote 代码并改进命名。

Frida 17.7.0 发布

此版本带来了几项重要的新 Linux 能力、改进的服务连接机制,以及覆盖 Darwin、 Android 和 API 表面的少量平台专用修复。

亮点包括:

  • linux:添加由 eBPF 驱动的新 SyscallTracer 服务,并为未来的活动采样奠定基础。
  • droidy:支持使用远程服务以及在本地实现服务。
  • darwin:在 macOS 26 上接受 __dyld_apis dyld 段。
  • android:修复较新操作系统上的生成包名逻辑。
  • icons:图标尺寸使用 uint16,并在 macOS 上省略 PNG 图标的宽度/高度, 以与其他平台保持一致。
  • node:扩展 GVariant 封送支持,对 64 位整数使用 BigInt,并修复可能导致 引用计数下溢和内存损坏的 Service.request() 生命周期问题。

感谢 @veecore 修复 macOS 26 兼容性,也感谢 @hsorbo 共同完成部分 Linux 系统调用和 BPF map 工作。

Frida 17.6.2 发布

这个版本为多个平台和组件带来了一系列稳定性与兼容性改进:

  • fruity:恢复在 FLUSHING 状态期间调用 handle_events_completed,使 pending_usb_ops 最终能够清空,从而修复 PortableCoreDevice flush 无限循环。感谢 @mrmacete。
  • compiler:重命名存在冲突的 Go 符号。感谢 @NSEcho。
  • compiler:通过 memfd 加载后端并提供后备方案,从而在可行时继续享受避免临时文件的优势。
  • linux:修复 memfd 受限时的系统会话问题(在 Android 的 Termux 环境中观察到)。
  • elf-module:将 {Section,Symbol}Details 改为 boxed 类型,通过添加 ref/copy/free 语义并更新 Vala 绑定,使绑定能够安全地传递和持有它们。
  • process:让 ThreadDetails free 函数能安全处理 NULL。
  • darwin-module:让 Image free 函数能安全处理 NULL。
  • linux:初始化变量,消除编译器无法证明返回 TRUE 时输出参数已初始化所产生的警告。
  • linux:处理解释器 exec 包装二进制文件(例如 ld.so <program>):检测 AT_BASE == 0,并从 /proc/self/maps 恢复真正的程序和解释器映射。

Frida 17.6.1 发布

这是一个规模虽小却很重要的维护版本:修复了最近重新设计的 Android Zygote 插桩在启用 BTI 的 arm64 系统上的崩溃,扩大了设备兼容范围;同时修复了一项 GumJS 崩溃,并改进了对 Termux 环境的开箱即用支持。

  • android:把 zymbiote 有效载荷放入更安全的地址范围,避免与 Zygote 使用的内存范围冲突(在 fork 出的应用/服务有机会在意此事之前就会还原)。
  • android:确保注入的有效载荷在构建时启用 BTI,使间接分支跳入其中时不会触发故障,从而修复全新、低侵入性的 Zygote 插桩在启用 BTI 的 arm64 系统上的崩溃。
  • android:调整静态链接的 OpenSSL,使其自动使用 Termux 的 ca-certificates,让 Frida.PackageManager(frida-pm)无需设置 SSL_CERT_FILE 即可在 Termux 上开箱即用。
  • compiler:避免使用 memfd 路径,修复 Android 上的后端加载问题。该路径可能因使用更严格的权限重新打开同一底层文件而失败。现在,即使支持 memfd,我们也会使用临时文件。
  • gumjs:NativeCallback 构造失败时(例如参数类型无效)避免释放 NULL ffi_closure,从而防止 libffi 崩溃,并允许 JavaScript 异常继续传播。

感谢 @leg1tsoul 修复 GumJS,也感谢 @as0ler 和 @ApkUnpacker 协助追踪 Android Zygote 插桩问题。

Frida 17.6.0 发布

这个版本让我非常兴奋。在 Android 上,我们消除了两大系统不稳定来源:过去对 Zygote 和 system_server 侵入性很强的插桩。感谢 @mrmacete,Apple 平台上的 DebugSymbol 性能也得到显著提升,并包含多项稳定性修复。此外,各方面还普遍增强了稳健性。

Android

下面仔细看看 Android 端的稳定性工作。

在深入 Zygote 和 system_server 之前,先说明一项重要基础工作:感谢 @AeonLucid,SELinux 用户空间库已变基到更新得多的上游版本,在保留 Android M 特有行为的同时支持现代二进制策略格式。

过去,Zygote 处理依赖注入 frida-agent,以便通过子进程门控功能观察 fork() 转换。必须在这里注入代码,是因为除非应用标记为可调试,否则系统不允许以暂停状态启动它。

这种注入代价高昂:它需要停止并重启线程,会在之后的所有子进程中留下痕迹,并且在多个方面都很脆弱。

例如,必须小心隐藏文件描述符,防止 Zygote 调用 abort()。如果 frida-core(通常作为 frida-server 的一部分)恰好在不合适的时机执行注入,例如应用或服务启动期间,就可能使该进程崩溃,并拖垮用户空间的大部分内容。

我们通过 ptrace() 跟踪 Zygote,直到它到达一个被认为表示空闲状态的系统调用,以此缓解问题。但我一直没有为清理实现相同逻辑,所以那部分始终存在风险。

更糟的是,系统调用跟踪机制本身存在错误,会随机失败。我最初打算修复它们,但在发布此版本前有了另一个想法:能否用轻量且专用的方案替代这一切复杂性?

我与 @hsorbo 结对开始工作。最终方案从外部完成全部插桩,完全避开 ptrace(),转而依赖 /proc/$pid/mem:

  1. 打开 /proc/$pid/mem 并扫描相关内存范围,定位 android.os.Process.setArgV0Native() 的 ArtMethod(或 Dalvik 等效项)。这是 libandroid_runtime.so 中实现的 native 方法,因此先确定模块基址,再使用 Gum 的 ELF 解析器(Gum.ElfModule)计算精确函数指针。该方法也非常适合子进程门控:它运行时 SELinux 转换已经完成,软件包名称也已知,并作为新的 argv0 传入。
  2. 不再像以前那样做内联挂钩(技术上仍然可行),而是直接替换方法结构中的函数指针。
  3. 选择一段包含可执行代码的内存范围;其中的代码要么已经运行且不会再次运行,要么只会在 fork() 后运行,例如子进程使用特定多媒体 API 时才会到达的代码。
  4. 将 “zymbiote” 载荷写入该区域。它很小——arm64 上目前为 920 字节——因此无需覆盖太多内容。
  5. 更新方法结构的函数指针,使其指向载荷。
  6. 载荷恢复原始函数指针、调用真实实现,然后连接到抽象 UNIX socket。它发送 PID、PPID 和软件包名称,再等待 ACK。
  7. 如果该软件包有待处理的 spawn() 请求,或已启用启动门控,frida-core 会暂缓发送 ACK,直到应用使用给定 PID 调用 resume()。这样客户端便有机会 attach() 并应用早期插桩。
  8. 如果 connect() 失败或发生 socket 错误,载荷直接返回,因此 frida-core 崩溃不会拖垮用户空间。
  9. 如果通信成功并收到 ACK,载荷尾调用 raise(SIGSTOP)。尾调用对于保证下一步安全十分重要。
  10. frida-core 观察到进程处于停止状态后——意味着它不再于载荷内部执行——会回滚所有更改并发送 SIGCONT。任何未由 Frida 插桩的子进程都会保持完全原始的状态。过去并非如此,一些应用会因为 RASP 系统检测到先前加载 frida-agent 后残留(但已失效)的痕迹而崩溃。

这就是最终采用的方案,结果相当直截了当。整个载荷只有 295 行 C 代码(包括用于尾调用的少量内联汇编)。由于完全不再涉及 ptrace(),与其他工具的互操作性也显著改善。

system_server 端的工作量小得多。我们已有一个用于非 root Android 的小型辅助程序 frida-helper.dex。我们会把它写入临时文件,让 app_process 指向它,并与其通信以枚举已安装应用、运行中进程等。

本版本将该方案通用化:辅助程序现在由 Linux 和 Droidy 后端共享,并扩展支持其他请求类型,例如启动 activity 和发送广播。

除了显而易见的稳定性收益,这也意味着 frida-core 不再依赖 frida-java-bridge。因此,未来操作系统版本或 Play Store 更新引入的 libart.so 兼容性问题不会损害 Frida 的核心功能。

不再向 system_server 注入内部 agent 的一个缺点是,我们失去了禁用系统默认应用启动超时的能力。我认为可以接受,因为必要时仍可向 system_server 注入一个小脚本来实现同样效果。

结束语

本版本还包含许多其他改进。请务必查看下面的变更日志了解完整细节。

祝使用愉快!

变更日志

  • android:将 SELinux 用户空间库变基到更新的上游版本,在保留 Android M 特性的同时支持现代二进制策略格式。(感谢 @AeonLucid)
  • android:改用轻量级 Zygote 挂钩:修补 android.os.Process.setArgV0Native(),使其通过小型载荷跳转并回连 frida-core 进行插桩。此方案取代此前在 Zygote 中放置内部 agent 的做法,并移除对 frida-java-bridge 的依赖。(共同作者:@hsorbo)
  • android:全面迁移到 frida-helper.dex,消除向 system_server 注入代码的需求。
  • libc-shim:修复长期存在的 Android SELinux getline() 分配器不匹配问题,该问题会导致堆损坏和未定义行为。
  • darwin:通过重写的解析器加快按地址查找 Objective-C 方法,并用 GumModuleRegistry 信号替换 symbolutil 缓存失效器。后者修复了交换 dyld 通知场景中的 SIGBUS。(感谢 @mrmacete)
  • fruity:在关闭状态下执行 TCP 写入时抛出 CLOSED,避免无限轮询循环。(感谢 @mrmacete)
  • fruity:修复可能导致 USB 工作线程死锁的 USB 启动/关闭竞态,使枚举和关闭过程具有确定性。
  • linux:修复 ptrace 信号等待器转发和系统调用跟踪不同步,使存在 ptrace 内部停止和真实信号时的 spawn/attach 流程更加稳健。
  • linux:修复 arm64 ucontext 记录解析。(感谢 @MarlinDiary)
  • android:处理新版 Android 中的 __pthread_start 符号后缀,使线程枚举不再错误地把系统视为不受支持。(感谢 @MarlinDiary)
  • android:在 enumerateRanges() 中处理 APK 库。(感谢 @monkeywave)
  • arm64:不可行时避免尝试 Interceptor 快速修补。(感谢 @Jiay1C)
  • interceptor:添加 FORCE attach 标志,即使函数太小而无法安全修补,也允许内联挂钩。这可能覆盖函数末尾之后的字节,应谨慎使用。
  • elf:必要时强制挂钩 RTLD 通知器,并改进 ELF 模块哈希解析和验证,包括正确解析 ELF32 的 GNU 哈希。
  • frida-node:使用 Symbol 描述而非强制转换,避免 XPC 相关用法中的 “Cannot convert a Symbol value to a string” 错误。(感谢 @mrmacete)

Frida 17.5.2 发布

本次发布提高了 Windows 上模块导出信息的准确性,让 Darwin 上的辅助程序启动更加稳健, 并通过 SwiftPM 和新的 FridaCore xcframework 为 Swift 用户带来重大增强:

  • windows:修复 Module 导出元数据,使 type 属性准确反映真实导出类型,而不是始终报告为函数。 感谢 @Ninja3047!
  • darwin:启动辅助程序时使用 DO_NOT_REAP_CHILD,使辅助程序在未使用 -arm64e_preview_abi 启动的系统上更稳健,同时让宿主进程免受信号相关副作用影响。
  • python:改进类型标注。感谢 @EtienneMaheux!
  • swift:添加 SwiftPM 软件包清单和支持;将 Frida_Private 模块重命名为 FridaCore; 实现 LocalizedError(Foundation 可用时)并添加错误说明;完善 RPC API,并允许丢弃调用结果; 对 Device 实例去重,并修复 AsyncEventSource 中 yield/finish 的竞争条件。
  • swift:添加 AuthenticationService、PortalService、EndpointParameters、PackageManager 和 Compiler 的绑定;添加最小化的 GLib 绑定(MainLoop、File、Uuid、TlsCertificate、DateTime/TimeZone), 并将 GLib 和 JSONGLib 移入子命名空间。
  • ci:随 frida-core 发布 .xcframework。

Frida 17.5.1 发布

新鲜出炉:Frida 17.5.1!🍞

此版本包含一项重要错误修复:

  • darwin-mapper:为本地共享缓存查找添加验证。看似位于缓存中的符号, 现在不会再解析到潜藏在缓存外的 dylib(例如 libsystem_pthread.dylib 的 introspection 构建)。衷心感谢 @hsorbo 与我们结对调查!

祝你逆向愉快!🧠💥

Frida 17.5.0 发布

喝完几杯新鲜的 ☕,又堆积了一大批提交后,我们带着一个功能丰富的版本回来了。亮点包括更聪明的编译器、更稳固的 Darwin 内部实现,以及大规模的 Swift 重构——绑定现在优先使用 async/await,不再依赖委托,并且大体上与平台无关。

亮点

  • compiler:向 CompilerOptions 添加 platform 和 externals 选项,并将它们一路传递到 Go 后端。这让 frida-compile(以及 Frida.Compiler)能针对目标平台定制输出,并将选定的模块视为外部依赖——例如为 GumJS agent 构建插件时,agent 公开的 API 应在运行时链接,而不是打包进去。(感谢 @leonitousconforti)
  • darwin:重写 query_shared_cache_range(),改为解析 dyld 共享缓存头,而不是从 AllImageInfos 中找到的基址开始遍历虚拟内存区域。这消除了猜测,并确保页面发生写时复制后仍能得到正确的区间。(感谢 @hsorbo 参与结对编程)
  • darwin:AllImageInfos 现在会报告 Dyld Shared Cache 的 UUID 和滑动值。(感谢 @hsorbo 参与结对编程)
  • simmy:spawn() 现已正确接入 argv 和 env,因此模拟器的行为更接近真实设备。
  • frida-node:生成的 from_value() 辅助函数现在会包含继承的属性,因此 externals 等选项能正确传递。
  • frida-python:修复 PackageManager 规格选项解析中一处很小但会泄漏的角落问题。

Swift 绑定:现代化的跨平台革新 🍎

Frida Swift 绑定已经进行了大规模重构,使其符合 Swift 习惯、优先并发,并支持跨平台。

  • 全面采用 async/await——大多数 API 现在使用 Swift Concurrency,并通过 GCancellable 支持取消 Task。
  • 移除委托——基于委托的回调已替换为 异步事件流(AsyncStream),使事件处理更符合习惯,也更易于组合。
  • 线程友好——api: Support invocation from any thread 允许从非主线程安全调用。(感谢 @hsorbo 参与结对编程。)
  • 纯 Swift 核心与跨平台支持——核心绑定现已不依赖 Foundation 和 Dispatch,并使用纯 Swift 类型(二进制数据表示为 [UInt8])。目前仍有两个小缺口:Marshal 辅助函数中的 JSON 编解码当前使用 Foundation;以后会添加不依赖 Foundation 的后备实现。
  • SwiftUI 友好——新增 DeviceListModel,它是一个 @MainActor ObservableObject,公开 @Published devices 和 discoveryState,便于顺滑集成 SwiftUI。
  • 图标可移植性——用可移植的 Icon 枚举取代特定于平台的图像处理,并为 CGImage、NSImage、UIImage 和 SwiftUI.Image 提供平台适配器。
  • API 稳定性改进——公开枚举标注了 @frozen,并在必要时将一些复杂引用类型标记为 @unchecked Sendable。

注:本版本不包含 frida-swift 预构建二进制文件;如果你使用 Swift 绑定,应执行 git clone 并从 main 构建,以获得最新变更。

还请注意,Swift 绑定仍然处于实验和演进阶段——虽然新 API 向前迈出了一大步,但在即将推出的版本中 Swift 层稳定之前,它们可能还会继续变化。

快速示例(来自 frida-swift README)

DeviceListModel(界面友好的模型):

import Combine

@MainActor
public final class DeviceListModel: ObservableObject {
    @Published public private(set) var devices: [Device] = []
    @Published public private(set) var discoveryState: DiscoveryState = .discovering

    @frozen
    public enum DiscoveryState: Equatable {
        case discovering
        case ready
    }

    public let manager: DeviceManager

    public init(manager: DeviceManager) { … }
}

现在可以这样使用:

import Frida
import SwiftUI

struct DevicesView: View {
    @StateObject private var model = DeviceListModel(manager: DeviceManager())
    @State private var selectedDevice: Device?
    @State private var session: Session?

    var body: some View {
        NavigationStack {
            List(model.devices, id: \.id) { device in
                Button {
                    Task {
                        selectedDevice = device
                        session = try? await device.attach(to: 12345)
                    }
                } label: {
                    VStack(alignment: .leading) {
                        Text(device.name)
                            .font(.headline)
                        Text(device.kind.rawValue)
                            .font(.subheadline)
                            .foregroundStyle(.secondary)
                    }
                }
            }
            .navigationTitle("Frida Devices")
            .overlay {
                if model.devices.isEmpty {
                    ProgressView("Searching for devices…")
                }
            }
        }
    }
}

完整脚本生命周期示例:

func testFullCycle() async throws {
    let manager = DeviceManager()

    for await devices in await manager.snapshots() {
        guard let local = devices.first(where: { $0.kind == .local }) else {
            continue
        }

        let session = try await local.attach(to: 12345)
        let script = try await session.createScript("""
            console.log("hello");
            send(1337);
        """)

        Task {
            for await event in script.events {
                switch event {
                case .message(let message, _):
                    print("Message:", message)
                case .destroyed:
                    print("Script destroyed")
                }
            }
        }

        try await script.load()
        break
    }
}

祝使用愉快。一如既往,如果遇到任何问题,请告诉我们!

Frida 17.4.4 发布

这是面向 Darwin 用户的一项虽小但重要的更新:

  • darwin:在有根系统上运行时,恢复 iOS ≥ 16 的应用列表和启动功能。frida-core 提交 8108d4d 在修复两个 Interceptor 单例泄漏时破坏了 dccb612,本次更新使后者重新生效。事实证明,springboard.m 中的泄漏是有意为之,它承担只初始化一次且不需要清理的逻辑;没有它,我们应用的插桩会立即被还原。感谢 @alexhude 提醒。

Frida 17.4.3 发布

万圣季带来了一小批修复和改进:

  • simmy:启用系统完整性保护(SIP)时,让依赖注入 SpringBoard 的功能优雅降级。这意味着 get_frontmost_application() 和图标获取现在会使用后备方案,而不会直接崩溃。

  • simmy:修复请求部分 bundle ID 时对已安装应用的枚举。感谢 @hsorbo 协助!

  • docs:更新 README 的 Apple 证书章节,以反映当前实际情况。感谢 @gemesa 发现并修复过时内容!

尽情使用,祝各位逆向愉快!

Frida 17.4.2 发布

本周轮到一批 Simmy 后端改进登场。感谢 @hsorbo 参与结对编程,带来以下改进:

  • simmy:实现 get_frontmost_application(),轻松确定当前位于前台的是谁。
  • simmy:修复 query_system_parameters() 所报告的 hardware.product, 例如返回 iPhone18,2 而不是“iPhone 17 Pro Max”。
  • simmy:接通应用图标。

祝你使用愉快!

Frida 17.4.1 发布

这是一个小巧可口的后续版本,让势头继续保持:

  • android:升级 system-server 中的 frida-java-bridge,纳入最新的稳定性改进:
    • android:处理静态 trampoline 修正,将每个 ArtMethod 回滚到之前的入口点,避免挂钩被绕过。
    • android:在 GC 后同步 ArtMethod 类字段,避免替换用的 ArtMethod 实例失效并导致未定义行为。 感谢 @hsorbo 一起结对编程。
  • devkit-assets:将 GumJS 示例升级到新的 Frida 17 GumJS API。感谢 @Hexploitable 促成此事。
  • freebsd:接入 PTY 支持,使依赖控制终端的启动/附加操作开箱即用。

祝使用愉快!

Frida 17.4.0 发布

又到了发布功能丰富的新版本的时候!主要变化:

  • simmy:全新的后端,通过 CoreSimulator.framework 与 Apple 模拟器通信。启动应用、对进程插桩,并像对待其他设备一样使用模拟器——全部都能在 Frida 中轻松完成。

  • darwin:支持对 dyld_sim 进行早期插桩,因此即使模拟进程中的动态加载器尚未完成自举,也可以附加并加载脚本。

  • darwin:修复最新版 iOS 18 模拟器上的 sysroot 检测;其中 dyld_sim 现在不会出现在 _dyld_image_count 和 TASK_DYLD_ALL_IMAGE_INFO_64 中。感谢 @CodeColorist 追踪到这个问题!

  • fruity:遇到 InvalidHostID 错误时自动取消配对,使下一次配对尝试能够成功。感谢 @mrmacete 的出色工作!

  • android:将 system-server 更新至 frida-java-bridge 7.0.9。变更如下:
    • 修复 Android 16 上的 Java.deoptimize*() 和 Java.backtrace()。感谢 @hsorbo!
    • 改进类型定义。感谢 @yotamN!
  • host-session:添加跨后端通信,使通过一个后端发现的设备现在可以供另一个后端的内部逻辑使用。

  • base:引入 StdioPipes 和 FileDescriptor 辅助工具,由 Darwin、Linux 和 FreeBSD 后端共享。

  • value:新增 VariantReader.list_members() 辅助方法,使内省更加容易。

尽情使用吧!

Frida 17.3.2 发布

新版本已经准备好了!本次发布专注于进一步榨取 Fruity 后端的性能:

  • fruity:批量传递数据报,使跨线程交接更具确定性,并减少上下文切换开销。
  • ncm:重新设计宿主到设备的调度。现在会维护一个 OUT 传输滑动窗口,并在任意 URB 完成后立即补充,让 bulk pipe 始终保持繁忙;在我们的测试中,HS 吞吐量从约 29 MB/s 提升到约 34 MB/s。
  • ncm:改用固定槽位的 NDP 布局,把 O(k²) 的“缩小直到能够装入”打包器变为 O(k)。对于 256 MiB 的传输,布局时间从约 1.1 秒降至噪声水平。

尽情使用,也请告诉我们实际效果如何!

Frida 17.3.0 发布

新鲜出炉的新功能!本次发布为 Barebone 和 Fruity 后端带来了令人兴奋的新能力, 同时也打磨了一些不够顺畅之处:

  • barebone:添加对 XNU 注入的基本支持,已在 QEMU 中的 iOS 14.0 上成功测试。 与 @hsorbo 共同完成。
  • barebone:公开带下划线前缀的 CModule 符号,使其可以在 Frida 脚本中使用。
  • fruity:隧道超时或遇到其他传输错误时回退到 usbmux。感谢 @Xplo8E 的推动。
  • fruity:处理 CoreDevice 配对事件,并使用 FIFO 而不是序列号来匹配配对请求与响应。 非常感谢 @hsorbo。
  • fruity:处理清理过程中的少数边缘情况。感谢 @mrmacete。

尽情享用吧!

Frida 17.2.17 发布

版本虽小,影响很大:@mrmacete 提供的两个单行修复确保 Interceptor 在新版 iOS 上行为正确。

  • code-allocator:使用 pc 检查切片地址,使 data 与 pc 不同时(例如 iOS 26 上)is_near 和 is_aligned 仍保持一致。感谢 @mrmacete!

Frida 17.2.16 发布

这个新的维护版本全面带来了少量修复和易用性改进:

  • gumjs:确保 onLeave 只会在与之匹配的 onEnter 确实运行后调用,从而消除 在调用途中附加 Hook 时出现的不可预测行为。感谢 @mrmacete!
  • darwin-module:对 dyld “all image infos”中的 lldb_image_notifier 指针 进行 swap-hook,使模块注册表即使在通知器只有一条指令的现代 iOS 设备上也能 正常工作。感谢 @mrmacete!
  • barebone:添加 try_remap_writable_pages()。
  • barebone:允许覆盖 query_rwx_support(),以便针对特殊平台定制 RWX 能力探测。
  • frida-node:在 TypeScript 阶段遵循 package-lock.json,使 JS 依赖树完全确定。

Frida 17.2.15 发布

这个版本酝酿了一段时间,现在一大批好东西终于落地:

  • darwin / fruity:通过双重映射支持 iOS 26,并在 palera1n 上启用注入。特别感谢 @mrmacete 推动这项工作。
  • android:升级 system-server 中的 frida-java-bridge,以纳入 @AeonLucid 对 ART 偏移查找的改进。
  • platform:添加初步的 visionOS 支持。衷心感谢 @demonguy 开拓这片全新领域。
  • freebsd:加入 x86(32 位)支持。感谢 @saruman9 完成实现。
  • threads:在 Linux 和 Darwin 上接通 ARM/arm64 的 NEON 寄存器访问——感谢 @londek 贡献这组补丁。
  • barebone:为 NativeFunction / NativeCallback 添加 uint 类型支持,并在 MMU 被禁用时进行优雅处理。
  • buffer:修复 BufferReader.read_pointer(),此前我们错误地认为需要传入偏移量。

尽情使用吧!

Frida 17.2.14 发布

此版本对 Cloak API 和模块处理进行了多项改进,同时还包含一些必要的更新和 错误修复。特别感谢 @AeonLucid 为 Android 支持作出的贡献。

  • android: 更新 system-server 中的 frida-java-bridge,纳入 @AeonLucid 改进的 ART 偏移查找。详情请参阅 frida-java-bridge#362。

  • cloak: 在 Android 上添加对 Art::GetOsThreadStat 的支持,解决一个 与 frida-core#500 类似的问题:Zygote 会等待进程变为单线程后再继续, 否则就会崩溃。此变更适配了 art::GetOsThreadStat 的新用法。(感谢 @AeonLucid)

  • cloak: 修复 ThreadCountCloaker.dispose() 中的内存泄漏,原因是此前 未能向上调用 GObject.dispose()。

  • module: 添加可选的 get_version() 虚函数。

  • module: 将大多数接口方法改为可选,以减少 Barebone 集成所需的样板代码。

  • darwin: 实现 Module.get_version(),在可用时公开 LC_SOURCE_VERSION。

  • darwin-module: 添加 source-version 属性,以在存在时公开 LC_SOURCE_VERSION。

  • darwin-module: 支持在非 Darwin 环境中以内存方式使用,例如在 XNU 内部。

  • gumjs: 向 JavaScript 公开 Module#version。

  • barebone: 支持注册模块。

  • compiler: 将 @types/frida-gum 升级到 19.0.1。

Frida 17.2.13 发布

这是一个快速错误修复版本:

  • android:升级 system-server 中的 frida-java-bridge,以包含 @AeonLucid 提供的 ART 偏移检测修复。
  • barebone:支持实现 DebugSymbol API。

Frida 17.2.12 发布

我们很高兴宣布 Frida 17.2.12 发布。此版本初步支持在没有操作系统的情况下运行 Gum, 显著增强了 Barebone 后端,并带来多项改进和修复。

  • android:升级 system-server 中的 frida-java-bridge,包含一项针对 ART 类规格偏移检测错误的修复。 这可防止 libart.so 独立于 SDK 版本更新时因偏移不匹配而崩溃。现在的修复通过已知类在运行时检测, 而不是使用 SDK 启发式规则,从而提高了跨 Android 更新的可靠性。

    非常感谢 @AeonLucid 带头推动这项工作——这是一次真正英雄般的努力, 面对不断变化的 ART 内部机制,它为 Frida 的 Android 支持带来了坚如磐石的可靠性。

  • gum:初步支持在没有操作系统的情况下运行,使 Frida 能在裸机目标上运行。集成者使用特定于目标/固件的实现 覆盖所需的弱符号。我们正在开发一个 XNU agent,它让我们可以在 Apple 的 OS 内核中运行 JavaScript。

  • barebone:在 arm64 后端添加对 APRR 的支持(感谢 @hsorbo 与我结对编程)。

  • barebone:添加对 R_AARCH64_PREL32 重定位的支持(感谢 @hsorbo),改善与更多 ARM64 二进制文件的兼容性。

  • barebone:实现 Memory.protect(),提供在裸机目标上更改内存保护的能力。

  • fruity:上传前对 Gadget 的 r-x 页面进行喷洒,将其变为调试器映射(感谢 @hsorbo、@mrmacete 和 @as0ler), 修复新一代硬件上的问题。

  • buffer:添加新方法:read_bytes()、write_bytes()、write_int64()、 write_uint32()、write_int32()、write_uint16()、write_int16()、 write_uint8()、write_int8(),扩展 Buffer API 对各种数据类型的处理能力。

  • gumjs:避免使用正则表达式解析内联 source map,以减少栈使用,提高在栈大小受限平台上的稳定性。

  • build:添加对以 ‘armv6kz-‘ 为前缀的工具链的支持(感谢 @zetierhg),改善与更多工具链的兼容性。

  • build:修复 Python < 3.9 的 typings(感谢 @oriori1703),确保与旧版 Python 兼容。

  • build:为 FreeBSD linker 特别处理 ld 脚本,以修复构建问题(感谢 @grimler),改善 FreeBSD 支持。

  • devkit:让符号前缀变为可选(感谢 @Hexploitable),允许使用者选择是否为第三方符号添加前缀以避免冲突。

Frida 17.2.11 发布

就在我们以为一切都已搞定时,软件又提醒我们它能有多难!感谢 @mrmacete、@hsorbo 和 [@0xmurphy][],我们迅速解决问题并带来以下修复:

  • frida-node:修复 fdn_keep_alive_until() 的 TSFN 生命周期问题。此前我们会把 TSFN 设为 NULL,当其他引用持有者尝试安排清理时会导致崩溃。

  • fruity:修复终止预热目标时的问题。在 spawn 时终止预热进程会产生“connection closed”错误;现在会捕获该错误,从而可以启动新实例。

Frida 17.2.10 发布

这是一个快速发布的错误修复版本,解决了两个重要问题:

  • frida-node:修复保活 ThreadSafeFunction 的清理。在保活场景中使用 napi_release_threadsafe_function(),使待处理的微任务能在 libuv 句柄被丢弃前有时间运行。 这可以防止清理期间出现“unsettled top-level await”。由 @as0ler、@hsorbo 和 @mrmacete 共同完成。

  • barebone:确保 RustModule 的 C ABI 入口点能够在垃圾回收后保留下来。 较新的 Rust 工具链使用 --gc-sections,它会剥离未使用的段。我们重构了 make_linker_script(),扫描 Rust 源代码中预期公开的符号,并生成 KEEP(*(.text.<symbol>)) 指令,从而保留这些入口点。

Frida 17.2.9 发布

这次我们带来了初步的 iOS 26 支持,并修复了 Node.js 绑定中的一个错误:

  • fruity:支持在强制调试器映射的 iOS 目标(iOS 26)上注入 gadget;在这种情况下, 我们无法从目标进程内将内存保护重新改为可执行。遇到这类情况时,在 Interceptor 支持强制调试器映射之前,gadget 配置的 code_signing 将被设为 required。感谢 @mrmacete!

  • device:修复 stdio 选项未传递给 spawn() 的问题,该问题导致子进程始终继承 stdio。 与 @hsorbo 共同完成。

Frida 17.2.8 发布

这是一次快速的错误修复版本,用于解决影响 Windows 用户的问题:

  • package-manager:修复 Windows 上损坏的 #if。错误的预处理器指令会导致在 Windows 平台上编译时构建失败。

Frida 17.2.7 发布

我们很高兴宣布 Frida 17.2.7 发布,此版本对软件包管理器进行了显著改进。

  • package-manager:改进解析和提升,以更贴近 npm 的行为。与 @hsorbo 共同完成。感谢你的帮助!
  • package-manager:为 install() 添加 role 选项,实现与 npm install 的 --save-* 开关等价的效果。
  • package-manager:为 install() 添加 omits 选项,实现与 npm install 的 --omit=x 开关等价的效果。
  • package-manager:改进对可选软件包的处理。
  • package-manager:在非 Windows 系统上解压时处理文件模式。
  • package-manager:修复 has_install_script 逻辑,使其也考虑 preinstall 和 postinstall 脚本。
  • meson:说清 Vala 构建系统说明。Vala README 过去只提到 autotools 说明, 而以该方式编译 Vala 时,版本字符串不会添加 -frida 后缀,导致 frida-core 对 Vala 的检查失败。现在我们已明确,Vala 需要使用 Meson 从源码构建。感谢 @grimler 指出此问题!

Frida 17.2.6 发布

我们很高兴发布 Frida 17.2.6,其中包含两项重要修复:

  • buffer:修复 read_fixed_string() 中的 max_length。

    现在会同时按请求大小和缓冲区大小正确限制 max_length。

    感谢 @mrmacete!

  • agent:在模拟 realm 中禁用 Exceptor。

    Exceptor 需要 Hook signal() 和 sigaction(),但它们位于 libc 中。这会导致 gum_mprotect() 因无法修改 libc 的只读映射而中止。此修复避免了在 Android 14 和 15 AVD 上使用 frida-server 或 frida-inject 时出现的崩溃。

    感谢 @ptrstr!

Frida 17.2.5 发布

此版本为 Frida 带来了重要修复和改进。以下是主要亮点:

  • frida-node:在 promise settled 之前保持 TSFN 存活,避免可能导致 Node.js 提前退出并显示“Detected unsettled top-level await”警告的竞态条件。感谢 @mrmacete 和 @hsorbo 协助追踪这个问题。

  • frida-node:简化 findMatchingDevice()(由 @hsorbo 共同完成)。

  • package-manager:仅在明确请求时提升版本。

  • package-manager:修复 dev 逻辑。

  • docs:修复 README 中的 Mapper URL(感谢 @cmdlinescan)。

Frida 17.2.4 发布

这是又一个改进软件包管理器的快速错误修复版本,@hsorbo 和我一直在努力开发这部分。 以下是新内容:

  • package-manager:修复依赖项安装死锁。当某个软件包的子依赖同时也是安装栈中 更高层另一个软件包的依赖时,可能发生死锁。该子依赖会等待高层软件包在物理上安装完成, 但该软件包又要等子依赖解决后才能完成自身安装,从而形成循环等待。
  • package-manager:改进 manifest 处理,使其行为更接近 npm。(与 @hsorbo 共同完成。)
  • package-manager:改进进度报告。

Frida 17.2.3 发布

这是一个专注于改进软件包管理器的快速错误修复版本:

  • package-manager:修复对 scoped spec 的处理。

  • package-manager:处理包含根级条目的 tarball。

    该修复确保能正确处理包含“package/”目录条目或位于根层的任意文件的 tarball。

Frida 17.2.2 发布

我们又带来了一个快速错误修复版本:

  • package-manager:修复锁文件已为最新时的处理路径。
  • package-manager:仅报告已安装的软件包。不再包含那些未经改动的顶层软件包。 同时还简化了 install() 逻辑。

Frida 17.2.1 发布

又一个快速错误修复版本,解决了上一版本发布后发现的多个问题:

  • compiler:在 Android 上将后端改为共享库,以避免线程局部存储导致的动态链接问题。
  • python:公开 PackageManager.registry 属性。
  • python:修复 Compiler、PackageManager 和 FileMonitor 缺失的顶层计数器逻辑,确保信号能够正确发出。
  • python:为 PackageManager 类型添加 __repr__ 方法,便于调试。
  • core:修复将 libsoup 用作子项目时的构建问题。

Frida 17.2.0 发布

我很高兴地宣布 Frida 17.2.0 正式发布。本次发布的重点是让软件包发现变得极其简单。

查找现有的 Frida 专用软件包就是这么容易:

终端中显示的 frida-pm 搜索结果

使用其中任何一个软件包也同样简单:

终端中显示的 frida-pm 安装结果

亮点

  • 🔍 frida-pm search – 零干扰结果(按 keywords:frida-gum 过滤)。
  • 📦 一条命令即可安装 – 即使没有 Node.js,frida-pm install <pkg> 也能工作。
  • 🧩 编程接口 – 从 Python、C 等语言使用时具有相同的接口。

你在这里看到的是 frida-pm 命令行工具,它随 frida-tools 14.2.0 一同推出。 它的 Python 代码不到 300 行,因为它只是底层 Frida.PackageManager 实现的一层薄封装。

高级用户和软件包维护者通常仍会使用 npm、yarn 等工具,但我认为,如果要求初次接触 Frida 的用户同时熟悉更庞大的 JavaScript 生态系统,很可能会让他们不知所措并感到困惑。

frida-pm / Frida.PackageManager 的巧妙之处在于,搜索只会显示 Frida 专用软件包。 这是通过在搜索查询中内置 keywords:frida-gum 来实现的。

如果你在维护 Frida 专用软件包,请务必将 frida-gum 添加到 package.json 的 keywords 字段中。如果你的软件包是语言/运行时桥接,还请同时添加 frida-gum-bridge。

因此,可发现性是这里的一项关键功能。另一项功能是,它可以在没有 Node.js + npm 的系统上运行。 虽然我们默认使用 npm 的注册表作为后端,但你可以将它指向任何自己喜欢的注册表。

你还可以通过编程方式使用全部功能。例如,如果你想使用 Python 绑定执行搜索:

import frida

pm = frida.PackageManager()
result = pm.search("il2cpp", limit=3)
print(result)
print(result.packages)

你会看到类似下面的内容:

$ python search.py
PackageSearchResult(packages=[<3 packages>], total=13)
[Package(name="frida-il2cpp-bridge", version="0.12.0", description="A Frida module to dump, trace or hijack any Il2Cpp application at runtime, without needing the global-metadata.dat file.", url="https://npm.im/frida-il2cpp-bridge"),
 Package(name="frida-objc-bridge", version="8.0.5", description="Objective-C runtime interop from Frida", url="https://npm.im/frida-objc-bridge"),
 Package(name="frida-java-bridge", version="7.0.4", description="Java runtime interop from Frida", url="https://npm.im/frida-java-bridge")]
$

或者,你可能想安装几个软件包:

import frida

pm = frida.PackageManager()
result = pm.install(specs=["[email protected]", "frida-il2cpp-bridge"])
print(result)
print(result.packages)

运行后的结果可能类似这样:

$ python install.py
PackageInstallResult(packages=[<2 packages>])
[Package(name="frida-java-bridge", version="7.0.4", description="Java runtime interop from Frida"),
 Package(name="frida-il2cpp-bridge", version="0.12.0", description="A Frida module to dump, trace or hijack any Il2Cpp application at runtime, without needing the global-metadata.dat file.")]
$

添加安装进度也很容易:

import frida

def on_install_progress(phase, fraction, details):
    print({
        "phase": phase,
        "fraction": fraction,
        "details": details,
    })

pm = frida.PackageManager()
pm.on("install-progress", on_install_progress)
result = pm.install(specs=["frida-java-bridge", "frida-il2cpp-bridge"])
print(result)
print(result.packages)

输出可能类似下面这样:

$ python install.py
{'phase': 'initializing', 'fraction': 0.0, 'details': None}
{'phase': 'preparing-dependencies', 'fraction': 0.05, 'details': None}
{'phase': 'resolving-package',
 'fraction': -1.0,
 'details': 'frida-java-bridge@latest'}
…

我们已经看过如何从 Python 使用 PackageManager API,我或许还应该说明: 从 C 使用这个 API(几乎)同样简单:

#include <frida-core.h>

int
main (int argc,
      char * argv[])
{
  GCancellable * cancellable = NULL;
  GError * error = NULL;

  frida_init ();

  FridaPackageManager * manager = frida_package_manager_new ();

  FridaPackageInstallOptions * opts = frida_package_install_options_new ();
  frida_package_install_options_add_spec (opts, "[email protected]");
  frida_package_install_options_add_spec (opts, "frida-il2cpp-bridge");

  frida_package_manager_install_sync (manager, opts, cancellable, &error);
  if (error != NULL)
    g_printerr ("%s\n", error->message);

  return (error == NULL) ? 0 : 1;
}

如果你想试试这个示例,请从我们的发布页面下载 frida-core devkit。

你可以像下面这样构建并运行它:

$ gcc install.c -o install -I. -L. -lfrida-core -Wl,--gc-sections
$ ./install

(frida-core-example.c 顶部提供了一条示例命令行,它针对该 devkit 所适用的特定操作系统/架构进行了调整。)

请注意,可以通过传入 NULL 来省略 opts。在这种情况下,如果 package.json 中定义的软件包 尚未安装,或已安装版本不匹配,就会安装这些软件包。与 npm 一样,如果你没有 package.json 文件, 而是直接安装一些软件包,系统会为你创建 package.json。

本次发布还包含其他一些改进和修复:

  • Compiler:
    • 将 @frida/net 升级到 5.0.0。
    • 修复缺失的 shim 资源(感谢 @imlihe)。
  • frida-node:
    • 更改 Device.openChannel() 的返回类型,以公开带有 destroy() 的更具体类型。

要升级,请运行:

$ pip install --upgrade frida frida-tools

尽情享用吧!

Frida 17.1.5 发布

关键错误修复:恢复与 Android 14–15 的兼容性;上个版本添加 Android 16 支持时意外破坏了它。感谢 @tbodt 提供修复。

Frida 17.1.4 发布

很高兴宣布 Frida 17.1.4,它带来了多项重要修复和改进——最值得注意的是支持 Android 16。以下是新内容:

  • Compiler:将 esbuild 的 platform 切换为 node,使 package.json 中的 main 和 exports 按 Node.js 方式解析,恢复与依赖该行为的软件包的兼容性。感谢 @hsorbo 帮助追踪此问题。
  • Plist:修复二进制属性列表的 offsetIntSize,确保与 Core Foundation 兼容。感谢 @mrmacete 帮助追踪此问题。
  • Plist:XML 输出中的空字典和数组现在使用自闭合标签(例如 <dict/>),与 Apple 的编码器保持一致。
  • Android:将 system_server agent 中的 frida-java-bridge 升级到 7.0.3,添加 Android 16 支持。感谢 @tbodt——同时也感谢 @thinhbuzz 贡献错误处理补丁,解决了某些 Android 12 设备上无法工作的问题。
  • Darwin:将内部 agent 中的 frida-objc-bridge 升级到 8.0.5。
  • GumJS:修复 FFI 参数的大端处理。

我们建议所有用户尽快升级。请确保同时升级到刚刚发布的 frida-tools 14.1.2。

Frida 17.1.3 发布

本次发布为多个组件带来了一系列改进和错误修复。主要内容如下:

  • 重命名 Compiler 后端中存在冲突的 Go 符号,避免链接到 Go 二进制文件时发生冲突。 这可确保与 Go 项目集成时保持兼容。
  • 在 Linux 上修复与线程列表锚点相关的问题,以防止误报。此前,锚点可能被错误地添加到线程列表, 导致行为不正确。
  • 修正 gadget 和 GumJS 中的 QuickJS 大端字节码检查。此前的检查在大端系统上不正确。
  • 向 API 添加版本定义和宏,为开发者提供更明确的版本信息。

Frida 17.1.2 发布

看来软件开发确实很难!17.1.1 发布仅仅几小时后,我们又带来了后续版本, 对 frida-core 和 frida-node 进行了完善。

frida-core

  • Compiler – DeviceManager 构造函数参数现在可以省略。 为保持 ABI 兼容性,它仍保留在函数签名中,但已不再使用。

frida-node(Node.js / N-API 绑定)

  • 信号处理
    • 处理程序现在能正确接收 GVariant 参数。
    • 处理程序内部抛出的异常会向上传播,不再被吞掉。
  • Compiler – 只要还有任何 output 信号处理程序处于连接状态,就让运行时保持存活, 防止过早退出。

祝你玩得开心!

Frida 17.1.1 发布

喝着刚泡好的咖啡,我完成了以下改进:

  • 构建系统改进:
    • 以下组件改用 ESBuild 打包:
      • reportcrash.js on Darwin.
      • osanalytics.js on Darwin.
      • system-server.js on Linux.
      • Barebone 后端中的运行时。
  • Barebone 后端修复:
    • 修复 ESM 处理:此前未等待返回的 Promise 会吞掉错误,现在所有错误都会得到正确报告。
    • 移除过期的桥接全局变量。

Frida 17.1.0 发布

这是一次包含多项精彩改进的重大更新!

首先,我们在 Compiler 后端中改用了 ESBuild 和 typescript-go,性能获得大幅提升;由于不再需要维护打包器,维护负担也随之减轻。我们还添加了用于配置输出和打包格式的选项,并支持禁用类型检查。

其次,我们现在终于提供 Windows/ARM64 二进制文件。GitHub 向公众开放 Windows ARM64 托管运行器后,阻碍这项工作的因素也随之消除。

特别感谢 @mrmacete 修复 Interceptor 单例泄漏,也感谢 @fesily 在 Windows 上实现 Module#enumerateSections(),并改进 Module#enumerateImports() 以公开 slot。

以下是完整变更列表:

  • Compiler 改进:
    • Compiler 后端改用 ESBuild 和 typescript-go。
    • 添加用于配置输出和打包格式的选项,并支持禁用类型检查。
  • Windows/ARM64 支持:
    • 更新 CI,以发布 Windows/arm64 二进制文件。
  • 社区贡献:
    • 修复 Thumb 地址的 32 位 ARM 断点逻辑。
    • 修复 Interceptor 单例泄漏(@mrmacete)。
    • 在 Windows 上实现 Module#enumerateSections() 并接通导入槽位(@fesily)。

Frida 17.0.7 发布

本次发布包含几项重要修复:

  • device:允许代理会话在释放前分离,以稳健应对乱序分离可能导致释放时无限挂起的情况。 感谢 @mrmacete!
  • darwin:销毁模块解析器索引,避免在使用短生命周期解析器的场景中 (例如不同任务中)泄漏原生模块。感谢 @mrmacete!
  • stalker:处理没有内联缓存条目的代码块。

Frida 17.0.6 发布

这是一个快速错误修复版本,其中包含 @londek 的一项重要贡献。本版本解决了以下问题:

  • darwin:修复 launchd agent。它仍在使用一个现已移除的旧 GumJS API,导致该 agent 无法在已越狱的 iOS/iPadOS/tvOS 系统上运行。

Frida 17.0.5 发布

这是一个快速错误修复版本,用于修复最新版 frida-compile 生成的 Agent。随着 TypeScript 编译器更加符合规范并开始生成 CommonJS 胶水代码,我们需要把内部 Agent 显式声明为 ESM。此修复覆盖 Darwin 和 Android Agent,以及 Barebone 后端的脚本运行时。

Frida 17.0.4 发布

此版本改进了 Compiler 实现,它为 frida-tools 中的 frida-compile CLI 工具提供 底层支持。具体变更如下:

  • 升级到 frida-compile 18,现在包含 TypeScript 5.8.3、最新版 frida-fs 等。
  • 修复 Windows 上的资源打包逻辑,此前虚拟路径使用了错误的路径分隔符。

Frida 17.0.3 发布

软件开发很难,对吧?紧随上一个版本,这里有一项快速修复:

  • compiler:更新 @frida/rollup-plugin-node-polyfills 以解决一个依赖问题,其仍依赖旧的 frida-fs。

Frida 17.0.2 发布

此版本带来了几项错误修复:

  • Compiler:将 frida-compile 和 frida-fs 更新到最新版本。
  • gum:既然 GObject 已恢复为必需库,修复与其相关却被遗忘的 diet 位。
  • gumjs:修复禁用断言进行构建时的 assigned-but-not-used 警告。

Frida 17.0.1 发布

惊喜!在 17.0.0 发布的同一天,我们又带来了一个快速补丁版本。事实证明,软件开发很难!

此版本包含以下修复:

  • Core:更新接口版本,使其与主版本一致。
  • Darwin:将 frida-objc-bridge 升级到 8.0.4。
  • Android:将 frida-java-bridge 升级到 7.0.1。
  • frida-node:修复 Device.openChannel() 的返回类型,避免暴露未来可能需要更改的实现细节。

Frida 17.0.0 发布

在喝掉数不清的咖啡、经历许多愉快的编程时光后,@hsorbo 和我很高兴为大家带来 Frida 17.0.0。距离上一次主版本升级已近三年,我们一直苦于找不到合适的时机引入破坏性变更,现在终于决定是时候了。

运行时桥接

长期以来,最困扰我们的一点是运行时桥接,也就是 frida-{objc,swift,java}-bridge,都捆绑在 Frida 的 GumJS 运行时中。这带来了几个主要痛点:

  • 惯性:它们受制于 Frida 的发布周期。
  • 臃肿:用户可能并不需要某个特定的运行时桥接。
  • 可扩展性:我们希望看到面向各种运行时的桥接,但加入 Frida 的桥接越多,惯性和臃肿问题就越严重。
  • 可发现性:社区维护的桥接更难被发现,因为使用它们需要另一套工作流。

不过,我一直不愿停止捆绑这些桥接,因为要求自定义 agent 必须经过构建步骤,似乎会增加太多阻力。而且,一想到这会破坏书籍、博客文章和 CodeShare 等处的示例,我也难以接受。

正因为构建阻力,我们在 15.2 中引入了 frida.Compiler API,同时 frida-tools 还附带了基于它构建的 CLI 工具 frida-compile。我们的 REPL 也得到改进,支持直接加载 .ts(TypeScript),其背后使用的正是 frida.Compiler。

但这仍然多了一步,对于一次性脚本,以及使用 Frida REPL 或 frida-trace 进行的早期原型开发来说,这一步还是太麻烦了。而且,它会破坏大量现有示例。为解决这个问题,刚刚发布的 frida-tools 14.0.0 已将这三个桥接内置进 REPL 和 frida-trace agent。

我们的桥接也已迁移到 ESM,因此可以由最新版 frida-compile 使用。(感谢 @yotamN 将 frida-java-bridge 迁移到 ESM ♥️)

从源码构建 Frida 的用户还可能注意到构建速度有所提升。由于不再捆绑这些桥接,我们终于可以移除 Gum 对 frida-compile 的依赖,并让 Gum 本身不再依赖 Node.js + npm。

我们仍然保留 GumJS 自己的运行时,它实现了 console.log() 等内置功能;不过,将它移植到 ESM,并直接逐个嵌入各模块后,我们就不再需要 JavaScript 打包器了。这意味着 Gum 自身的构建速度更快:在运行 Linux 的 i9-12900K 系统上,构建时间从约 24 秒降至约 6 秒。

可以在桥接文档中查看快速参考教程。

旧式枚举 API

过去,我们所有同步枚举 API 都是这样的:

Process.enumerateModules({
  onMatch(module) {
    console.log(module.name);
  },
  onComplete() {
  }
});

此外还有一个名称带 Sync 后缀的等效方法;在这个例子中就是 Process.enumerateModulesSync()。当初的想法是,底层实现未来可能变为异步;但在当时,大多数实现并非异步,所以带 Sync 后缀的实现只是套在那个看起来像异步的 API 外的一层薄包装。

后来,随着支持的平台越来越多,我意识到所有这些假装异步的实现始终都是快速且低开销的操作。因此,提供异步形式毫无意义。而少数从一开始就真正异步的 API,例如 Memory.scan(),继续保持异步仍然合理。

不过,我不愿直接破坏 API,于是选择为每个不带后缀的实现增加一项检查:如果省略回调参数,它就会像带 Sync 后缀的对应方法一样工作。为了推动用户迁离旧式 API,我还更新了 TypeScript 绑定,使其中只包含现代形式。

对应的现代写法如下:

for (const module of Process.enumerateModules()) {
  console.log(module.name);
}

其中 Process.enumerateModules() 返回一个 Module 对象数组。

这些旧式 API 现在终于全部移除了。使用 TypeScript 编写 agent 的用户无需做任何改动,除非你使用的是非常古老的类型定义版本。

内存读写 API

过去,你会这样访问内存:

const playerHealthLocation = ptr('0x1234');
const playerHealth = Memory.readU32(playerHealthLocation);
Memory.writeU32(playerHealthLocation, 100);

现代等效写法是:

const playerHealthLocation = ptr('0x1234');
const playerHealth = playerHealthLocation.readU32();
playerHealthLocation.writeU32(100);

每个写入方法都会返回 NativePointer 本身,以支持链式调用:

const playerData = ptr('0x1234');
playerData
    .add(4).writeU32(13)
    .add(4).writeU16(37)
    .add(2).writeU16(42)
    ;

这些旧版 API 现在也已移除;它们从 TypeScript 绑定中消失的时间和旧式枚举 API 一样久。因此,大多数用户应该也不会察觉这项变化。

静态 Module API

接下来介绍同样会影响那些在 19.0.0(与 Frida 17 同时发布)之前一直使用最新版 TypeScript 绑定的用户的破坏性变更。以下静态 Module 方法现已移除:

  • Module.ensureInitialized()
  • Module.findBaseAddress()
  • Module.getBaseAddress()
  • Module.findExportByName()
  • Module.getExportByName()
  • Module.findSymbolByName()
  • Module.getSymbolByName()

从这些方法迁移都很直接。

不过,先来看看其中比较特殊的一个:

Module.getSymbolByName(null, 'open')

现在要这样实现:

Module.getGlobalExportByName('open')

对于其余方法,需要先查找 Module,再访问其上的所需属性或方法。例如,不再这样写:

Module.getExportByName('libc.so', 'open')

新的写法是:

Process.getModuleByName('libc.so').getExportByName('open')

Module.getBaseAddress() 的等效写法因此是:

Process.getModuleByName('libc.so').base

这意味着 Module 内省现在只有一种方式,而且 API 设计会引导你编写高性能代码。例如,过去你可能会想这样写:

const openImpl = Process.getExportByName('libc.so', 'open');
const readImpl = Process.getExportByName('libc.so', 'read');

但现在,在写出下面这样的代码之前,你可能会多考虑一下:

const openImpl = Process.getModuleByName('libc.so').getExportByName('open');
const readImpl = Process.getModuleByName('libc.so').getExportByName('read');

而会改成这样:

const libc = Process.getModuleByName('libc.so');
const openImpl = libc.getExportByName('open');
const readImpl = libc.getExportByName('read');

这种写法既更易读,性能也更好。

最后同样重要的是,Module.enumerateExports() 等静态枚举 API 现在也已移除。不过,它们很早以前就从 TypeScript 绑定中删除了,所以大多数用户应该无需处理。如果确实需要迁移,方式与上面完全相同。

EOF

大致就是这些。祝各位逆向愉快!

Frida 16.7.19 发布

此版本改进了 glibc 下的 Linux 线程枚举,并加固静态 OpenSSL 构建,防止意外 加载配置。

变更:

  • linux:跳过 tid = 0(已退出但尚未 join)的 glibc 线程,以避免错误的 “Unsupported Linux system” panic。
  • linux:按创建顺序(最早的在前)列出 glibc 线程,以反映真实的线程生命周期。
  • deps (TLS):使用 OPENSSL_NO_AUTOLOAD_CONFIG 构建 OpenSSL,阻止加载任何 系统配置文件,避免 TLS 初始化时崩溃。

Frida 16.7.18 发布

版本接连发布!软件开发很难,有时我们需要快速推送修复,确保一切顺畅运行。 以下是此版本的新变化:

  • frida-node 修复 Device.openChannel() 返回类型相比以前发生变化的回归问题。
  • Fruity 后端改进:使用 Apple 的 CoreDeviceProxy 作为回退方案,从而支持 NCM 存在问题的系统。同时每 250 ms 重传一次 mDNS-SD 请求,以增强稳健性。

祝你逆向愉快!

Frida 16.7.17 发布

这个版本为 Fruity 后端带来多项改进和修复,增强了跨平台兼容性与错误处理。以下是本版本包含的变更:

  • fruity:必要时也在 macOS 上发起配对。
  • fruity:调整 macOS CreateAssertion 错误处理,使失败时能够提供清晰的错误消息。
  • fruity:处理 OPACK 布尔值和紧凑整数。iOS 18.4.1 上的配对需要后者支持。
  • fruity:改进便携隧道错误处理。当我们使用 lockdown 判断 iDevice 是否支持隧道,却因缺少 lockdown 级别配对而失败时,直接假定操作系统支持隧道。
  • fruity:为 Linux netif 等待逻辑添加超时。
  • fruity:处理 NetworkManager 的 DISCONNECTED+CARRIER 状态。这样,当设备快速经过 state=DISCONNECTED、reason=CARRIER 时,我们会真正等待设备就绪。

Frida 16.7.16 发布

又一个快速错误修复版本,因为软件开发很难!此版本解决以下问题:

  • node:修复并非从源码构建时的模块解析。事实证明,构建目录中生成的 package.json 干扰了 bindings 软件包的模块根目录检测。这意味着我们的 搜索路径实际有误,只是依赖了这次误检测。

Frida 16.7.15 发布

我们很高兴宣布 Node.js 绑定迎来重大更新!它们已经从头重写。过去,绑定依赖 Node.js 和 V8 API,而这些 API 不可避免地会随版本变化,因此每种 ABI 都需要单独构建;现在,我们的绑定改为面向 Node-API。这意味着单个二进制文件可以用于所有现代版本的 Node.js、Electron、nw.js 等。每种 OS/架构/libc 组合只需构建一个二进制文件。不仅如此,新绑定还是自动生成的,确保 frida-core 中的 API 变更能够立即反映出来;如有需要,只需调整自定义部分。

这个版本还包含其他一些好东西:

  • DeviceManager:修复 HostSessionService 的 start() 被取消时,过早调用 close() 导致的崩溃。
  • Web Service:修复 TLS 连接处理,因为远程地址逻辑此前没有考虑它们。
  • API:修正 .gir 文件中的 FridaBase 引用。
  • Bus:移除原本不应公开的 device 属性。

一如既往,衷心感谢所有贡献者和用户的支持。

Frida 16.7.14 发布

此版本改进了对 Google 最新 32 位 ARM ART 运行时的支持、Linux 上的错误处理,以及对大端 ARM 架构的支持。

主要变化如下:

  • 改进 frida-java-bridge,以支持 Google 最新的 32 位 ARM 二进制文件。 感谢 @Rwkeith。
  • Linux 后端失败时向上传递 ptrace 错误。 感谢 @DoranekoSystems。
  • 改进对大端 ARM 架构(armbe8、arm64be、arm64beilp32)的支持。
  • 移除 Linux 后端中多余的硬件断点代码。

一如既往,感谢所有贡献者为改进 Frida 付出的宝贵努力。

Frida 16.7.13 发布

这是一个解决 ELF 解析器问题的快速错误修复版本:

  • elf-module:修复回退到实时内存时 check_str_bounds() 中的递归。该函数假定 ELF 由文件支持;回退到实时内存可能触发无限递归。现在添加了显式实时内存检查, 改为返回错误。

Frida 16.7.12 发布

本次发布带来了几项重要改进和修复:

  • interceptor:避免暂停期间分配堆内存。将已暂停线程的 ID 存入 GumMetalArray 而不是 GQueue, 可以防止已暂停线程持有 dlmalloc 锁时发生死锁。感谢 @mrmacete 做出这项改进。
  • linux:修复缺少 ELF 时的 ModuleRegistry 初始化。枚举 RTLD 通知器和已加载模块以查找 DT_DEBUG 条目时,我们不再假定 ELF 文件存在。这修复了程序从 memfd 加载且在没有文件的 情况下启动时的问题。
  • elf-module:无法映射文件时使用实时内存。对于以 memfd 为后端的模块,如果无法映射文件, 现在会使用内存中的 ELF,而不是直接放弃。
  • linux:重做 glibc pthread 内部结构检测。不再通过解析机器代码来确定内部结构, 而是启动线程,以更稳健的方式解开这个谜题。

Frida 16.7.11 发布

这是一个快速错误修复版本,改进了 Fruity 后端,并初步支持 iOS 18.4:

  • darwin:更新 iOS 18.4 的注入器 dyld 初始化检测。

  • fruity:更新 iOS 18.4 的注入器 dyld 初始化检测(#1154)。感谢 @pachoo 作出这项贡献。

  • network-stack:缩短两次写入之间的延迟。一旦有部分空间可用就标记为可写, 不再等待低水位线。感谢 @mrmacete 作出这项改进。

  • network-stack:修复 TCP 写入块长度(#1156)。这是 @mrmacete 带来的另一项修复。

  • network-stack:始终发送已入队的数据。此变更确保即使队列中没有更多可用空间, 也会调用 pcb.output(),从而避免停滞。感谢 @mrmacete 消除这些恼人的停滞。

Frida 16.7.10 发布

我们很高兴宣布 Frida 16.7.10,带来多项稳定性改进。特别感谢 @mrmacete 找出所有这些问题的根本原因,并修复 Apple 操作系统上的一处死锁。

本版本包含以下变更:

  • network-stack:修复 TcpConnection 发送逻辑。
  • network-stack:改进 VirtualStream 锁定机制,以增强批处理并避免在 Frida 线程上进行不必要的调度。
  • virtual-stream:为了方便起见,允许在不持有锁的情况下调用 update_pending_io(),适用于子类在调用前无需更新其他状态的场景。我们的一个子类假定可以这样做,因为在把通用逻辑提取到 VirtualStream 基类之前,它一直如此工作。这意味着 16.7.4 中的重构引入了竞态条件,而此项变更将其修复。
  • darwin:通过避免使用 flags 来优化线程枚举。这消除了堆分配,降低了 Interceptor 等使用场景中的死锁风险;在这些场景中,线程枚举用于按 ID 暂停和恢复线程。(由 @mrmacete 贡献。)

尽情使用吧!

Frida 16.7.9 发布

事实证明软件开发真难!在上一个版本发布的同一天,我们又推出了一个快速错误修复版本, 用于解决出现的一些问题。非常感谢 @mrmacete 的贡献。以下是新内容:

  • channel:遇到空缓冲区时跳出读取循环。(感谢 @mrmacete!)
  • device-manager:修复拆除逻辑:之前在 HostSessionService 尚未被 start() 的情况下, 我们也会调用其 stop()。

Frida 16.7.8 发布

这是一个快速错误修复版本,用于修复 Apple 操作系统上的崩溃。

感谢 @mrmacete 提供以下修复:

  • darwin:修复 find_module_by_address 中的模块类型。此前的类型混淆会导致难以察觉的崩溃。

Frida 16.7.7 发布

软件开发确实不容易,对吧?这是一个用于解决编译问题的快速修复版本:

  • freebsd:解除 Binjector 的 sealed 限制以修复编译。目前 C 胶水代码仍依赖它的字段。

Frida 16.7.6 发布

谁能想到软件开发会这么难呢?这里再提供一个快速修复,让一切继续顺利运行:

  • qnx:取消 Qinjector 的 sealed 限制以修复编译问题。目前 C 胶水代码仍依赖其字段。

Frida 16.7.5 发布

我们很高兴宣布 Frida 16.7.5 发布。此版本改进了构建系统和 API,并为 Darwin 平台 带来重要修复。以下是新内容:

  • Darwin:修复 find_module_by_address 中的双重释放。(感谢 @mrmacete。)

  • Darwin:更新线程列表指针切分,以支持近期 iOS 版本。在这些版本上, pthread_from_mach_thread_np() 内的线程列表指针通过 ADRP + LDR 引用, 而不是 ADRP + ADD。(感谢 @mrmacete 贡献。)

  • API:修复 sealed 类的 VAPI 条目。

  • API:移除一些意外暴露的类型。

  • API:封闭不应被子类化的类,防止意外的子类化。

  • 构建系统:为方便起见提供 Gio-2.0.gir,因此用户在构建语言绑定并将 Frida 作为子项目使用时,无需安装任何 GObject Introspection 软件包。

  • 构建系统:修复未安装情况下的 frida_girdir。它现在会正确指向包含精炼后 .gir 文件的目录,而不是 Vala 编译器产生的原始文件。

Frida 16.7.4 发布

本版本包含多项改进和修复,包括支持远程服务与通道,以及其他增强:

  • Core:
    • 在主机会话中添加远程服务和通道支持,使 ControlService/frida-server 能够提供服务会话和通道。
    • 修复 ControlService 中远程设备的会话逻辑。
  • Compiler:
    • 将 frida-compile 和 @types/frida-gum 升级到最新版本。
  • Python 绑定:
    • 修复 IOStream.read_all() 对流结束的处理。

一如既往,祝你玩得开心!

Frida 16.7.3 发布

好吧,软件开发有时确实很难。这里有一个修复 CI 的快速更新:

  • ci:暂时从 package-linux 任务中移除 arm64beilp32。由于部分组件尚未移植到 此架构,在移植工作完成前,我们暂停将其纳入 Linux 软件包。

  • ci:将 pypa/gh-action-pypi-publish 升级到最新版 v1。

Frida 16.7.2 发布

同一天又发布了一个快速错误修复版本——事实证明,软件开发很难!

我挽起袖子修复了以下问题:

  • droidy:修复 MAX_MESSAGE_LENGTH 声明。新的最大值超出了 uint16 的范围。

Frida 16.7.1 发布

很高兴宣布 Frida 16.7.1 发布!此版本改进了多种架构支持,并修复一些棘手问题。非常感谢 @jpstotz 和 @philippmao 的宝贵贡献!

主要变化包括:

  • fruity:跳过 UDID 为空的设备,修复 Windows 上的 Input/Output Error。(感谢 @jpstotz)

  • droidy:提高消息大小限制,支持超过约 8 台 ADB 连接设备。(感谢 @philippmao)

  • thumb-relocator:在 can_relocate() 中利用 LLD 对齐填充,提高 Hook Android 现代工具链生成的微小函数时的成功率。

  • thumb-relocator:要求最后一条指令位于四字节边界且为双字节指令,从而限制填充检测。

  • module-registry:在 Hook 前填充注册表,使 CodeAllocator 能找到附近的 ELF 头,从而修复微小 ELF 通知器的 Hook。

  • ci:在 Linux CI 中新增 arm64be、armbe8 和 armhf-musl。

  • env:在 32 位 ARM 上启用 Thumb 代码生成,以得到更小的二进制文件。

  • linux:为 32 位 ARM 上的 musl 新增 pthread 探测。

  • build:修复 musl 的 armhf triplet 解析。

  • devkit:也为 Gum devkit 定义 GUM_STATIC,使用方无需自行定义。

  • devkit-assets:现代化 Gum 示例。

  • compiler:将 @types/frida-gum 升级到 18.8.1。

一如既往,祝你玩得开心!

Frida 16.7.0 发布

对软件进行插桩时,一个具有挑战性的方面是处理各种事物的动态特性:线程会启动和终止, 模块会加载和卸载。

例如,如果使用 Stalker 跟踪正在执行的线程,那么在考虑插桩本身之前,就会遇到几个基本 挑战。

哪些线程?

你可以使用 Interceptor 在某处放置内联挂钩,当线程执行某项有趣的操作时,再使用 Stalker 跟踪其执行。不过,有时你会更愿意调用 Process.enumerateThreads(),并跟踪 自己认为有趣的线程。

每个线程都可能有可供使用的 name;如果没有,通常只能采用较模糊的办法。你可以查看 context 属性提供的 CPU 寄存器,也可以将它传给 Thread.backtrace() 来生成线程“指纹”, 或者观察在某项操作期间哪些线程占用了最多 CPU 时间。

但如果能够确定线程的入口点例程及其参数呢?现在可以了:

$ frida -p 163431
Local::PID::163431 ]-> Process.enumerateThreads()
[
    …
    {
        "id": 163560,
        "name": "SDLAudioP1",
        "state": "waiting",
        "context": { … },
        "entrypoint": {
            "parameter": "0x561210844900",
            "routine": "0x7fc7781237c0"
        }
    }
]

未来的线程

接下来的挑战是跟踪尚未启动的线程。在此之前,这需要挂钩操作系统专用的内部机制,而维护 跨平台 Agent 中的这类代码相当复杂。

我很高兴地宣布,现在我们提供了专门解决这个问题的 API:

const observer = Process.attachThreadObserver({
  onAdded(thread) {
    …
  },
  onRemoved(thread) {
    …
  },
  onRenamed(thread, previousName) {
    …
  }
});

onAdded 回调会立即接收所有现有线程,因此无需担心竞态条件,就能轻松处理初始状态与 后续更新。如果参数是刚创建的新线程,此调用会从该新线程同步发生。因此,这正是对它调用 Stalker.follow() 的理想位置,不会错过早期执行的任何指令。

相应地,onRemoved 回调会在线程即将终止时通知你。该调用从相应线程同步发生,因此仍有 机会在线程上下文中执行一些最后的代码。

最后,onRenamed 回调会在线程的 name 刚刚变化时通知你,同时提供旧名称;如果之前 没有名称,则为 null。

所有回调都是可选的,但必须至少提供一个。

之后如果想停止观察,只需执行:

observer.detach();

未来的模块

线程会来去,模块/共享库也一样。你可能会很早应用插桩,以免错过初期活动。然而,应用插桩 越早,应用其他部分尚未加载的可能性就越大。

卸载也许根本不会发生,可能是因为应用不会这样做,也可能是动态加载器不支持;但它仍是你 可能需要处理的一个方面。

过去,处理这一切需要挂钩操作系统专用的内部机制,而维护用于跨平台 Agent 的这类代码会 带来所有相关复杂性。

我非常高兴地告诉大家,现在我们也为此提供了 API:

const observer = Process.attachModuleObserver({
  onAdded(module) {
    …
  },
  onRemoved(module) {
    …
  }
});

与 Process.attachThreadObserver() 一样,onAdded 回调会立即接收所有现有模块,因此无需 担心竞态条件,就能轻松处理初始状态与后续更新。如果参数是一个全新模块,此调用会在模块 加载完成后、应用有机会使用它之前同步发生。这是使用 Interceptor 等工具应用插桩的好时机。

相应地,onRemoved 回调会在模块消失时通知你。

两个回调都是可选的,但必须至少提供一个。

之后如果想停止观察,与线程观察器 API 一样,只需执行:

observer.detach();

分析代码性能

Frida 核心 C 库 Gum 中有一项鲜为人知的功能:名为 gum-prof 的库。它为代码性能分析提供 了一些轻量构件。从本次发布开始,我们终于将其开放给 JavaScript。

先从主要组件 Profiler API 开始。它是一个基于 Interceptor 构建的简单最坏情况分析器:

const profiler = new Profiler();
const sampler = new BusyCycleSampler();
for (const e of Process.getModuleByName('app-core.so')
      .enumerateExports()
      .filter(e => e.type === 'function')) {
  profiler.instrument(e.address, sampler);
}

传统分析器会按一定频率对调用栈采样,而在这里,你可以精确决定希望分析哪些函数。这正是 事情变得有趣的地方。

这些函数中的任何一个被调用时,分析器都会在进入时获取一个样本,在返回时再获取一个。 然后两者相减,计算本次调用的开销。如果结果大于此前为该函数看到的值,它就会成为新的 最坏情况。

发现新的最坏情况时,只知道大部分时间/周期等花在某个函数上不一定足够。例如,该函数 可能只在接收某些输入参数时才变慢。

在这种情况下,调用 instrument() 时可以为特定函数传入 describe() 回调。回调应从 参数列表和/或其他状态中捕获相关上下文,并返回描述刚刚发现的新最坏情况的字符串。

之后调用 generateReport() 时,会发现计算出的描述嵌入在每条最坏情况记录中。

Sampler

你可能已经在刚刚介绍的 Profiler 示例代码中注意到,我们现在还引入了“sampler”的概念。 实际上共有六种不同实现。它们都实现同一个 sample() 方法,返回表示最新测量值的 bigint。 具体表示什么取决于 sampler,但 Profiler 并不关心,因为它只关注两个时间点之间的变化量。

不过,这些 sampler 也可以直接用于其他目的。

以下是全新的 sampler:

  • CycleSampler:测量 CPU 周期,例如在 x86 上使用 RDTSC 指令
  • BusyCycleSampler:只测量当前线程消耗的 CPU 周期,例如在 Windows 上使用 QueryThreadCycleTime()
  • WallClockSampler:测量经过的时间
  • UserTimeSampler:测量特定线程在用户空间中花费的时间
  • MallocCountSampler:统计 malloc()、calloc() 和 realloc() 的调用次数
  • CallCountSampler:统计你所选函数的调用次数

UserTimeSampler 的一个有趣用法是使用线程 ID 构造它,让它测量该特定线程在用户空间中 花费的时间。为每个线程构造一个这样的 sampler,并分别采集一个样本后,可以用某种特定 方式操作应用,例如确保它收到某个特定网络数据包。然后从每个 sampler 采集第二个样本, 减去之前的样本,计算变化量/增量。由此可知哪个线程在用户空间中花费的时间最多,也就知道 接下来可能应该对哪个线程调用 Stalker.follow() 进行深入研究。

结语

此外还有一系列令人兴奋的变更,请务必查看下面的变更日志。

感谢 @hsorbo 与我一起对线程和模块观察功能的各个随机部分进行了愉快而高效的结对 编程!🙌 也感谢 @mrmacete 和 @as0ler 帮助测试和排查错误 🥳

尽情使用吧!

变更日志

  • 引入 Process.attachThreadObserver() 和 ThreadRegistry,用于监视线程创建、终止和重命名。
  • 引入 Process.attachModuleObserver() 和 ModuleRegistry,用于监视模块加载和卸载。
  • gumjs:向 JavaScript 公开 Gum 的 Profiler 和 Sampler API。
  • gumjs:添加 NativePointer#writeVolatile() API。感谢 @DoranekoSystems!
  • fruity:修复 Linux getifaddrs() 逻辑中的崩溃,该逻辑未正确处理没有地址的接口。
  • memory-access-monitor:提供对线程 ID 和寄存器的访问。
  • darwin:修复拆卸期间存在竞态的内存泄漏。
  • linux:避免注入期间出现虚假的 .so 范围。
  • linux:处理注入期间的兼容范围。
  • server:添加 –device,用于提供指定设备。
  • compiler:将 @types/frida-gum 升级到 18.8.0。

Frida 16.6.6 发布

本次发布带来了重要的错误修复,并优化了 Linux 和 Android 上的易失内存写入。 非常感谢 @DoranekoSystems 的贡献。

  • fruity:修复上一版本引入的通过 CoreDevice 执行 lockdown 时的回归;为了支持 com.apple.crashreportmover 等服务的网络 lockdown,RSDCheckin 现在包含 EscrowBag。 事实证明,这会破坏某些无权与 AppleKeyStoreUserClient 通信的服务。现在我们维护一份 此类服务的列表,对它们省略 EscrowBag。感谢 @as0ler 报告并协助排查问题。

  • darwin:修复 Apple Silicon 上的 sysroot 检测,使我们能够正确解析模拟器进程中的模块。 感谢 @stacksmashing 报告问题。

  • linux:针对 Linux/Android 优化 NativePointer#writeVolatile()(JS)/ gum_memory_write()(C)(感谢 @DoranekoSystems)。如果内核支持,便使用 process_vm_writev(),从而避免解析内存映射。这意味着它现在快了数千倍。

Frida 16.6.5 发布

本次发布带来一系列 Linux 和 Android 支持方面的改进与修复,其中包含 @kaftejiman 和 @DoranekoSystems 的贡献。我们还改进了通过网络与 Apple 设备通信的方式。

新增内容如下:

  • linux:改进注入器,避免对 memfd 区域进行有风险的代码交换(感谢 @kaftejiman)。 Memfd 区域可能不可写,而且与常规区域不同,缺少可写位时 ptrace() 也帮不上忙。

  • linux:放宽注入器对 Android libc 的匹配条件(感谢 @kaftejiman)。 这意味着即使 APEX 被绑定挂载,我们仍然可以匹配它们。

  • linux:针对 Linux/Android 优化 NativePointer#readVolatile()(JS)/ gum_memory_read()(C)(感谢 @DoranekoSystems)。如果内核支持,便使用 process_vm_readv(),从而避免解析内存映射。这意味着,与直接访问相比, 它不再慢 1000 多倍,而是只慢约 1.45 倍。

  • fruity:支持 CoreDevice 的网络 lockdown。我们需要在 RSDCheckin 中提供远程解锁主机密钥。 感谢 @as0ler 和 @mrmacete 报告问题并协助查明根本原因。

Frida 16.6.4 发布

此版本带来重要修复与改进:

  • objc:处理扩展的 block 类型编码(感谢 @mrmacete)。
  • module:撤销此前对 NativeModule 生命周期的优化,因为 GLib 补丁中的底层性能问题已经解决。
  • darwin:修复使用别名时 Module.load() 可能失败的问题。在 macOS >= 13 上,现在使用 _dyld_get_dlopen_image_header() 按地址解析模块。
  • linux:恢复 ARM BE8 支持,重新兼容大端 ARM 系统。

Frida 16.6.3 发布

此版本的主要变化是恢复 Windows 注入器;近期的 Gum.Module 重构曾破坏它。此外,我们还提升了各平台底层 GLib 原语的性能,重点改进实现静态分配清理的补丁。之所以需要这样做,是因为 Frida 注入的载荷寿命可能短于其所在进程。

尽情体验吧!

Frida 16.6.2 发布

新一轮改进与修复进一步提升了 Frida 的稳定性和性能,感谢 @mrmacete 提供宝贵反馈。本次更新如下:

  • gumjs:通过 idle source 延迟 unref,修复 Module 终结器中的崩溃。这既避免了 QuickJS 挂起/恢复补丁不支持从终结器调用所导致的问题,也省去了大量模块销毁期间反复挂起和恢复 JS 执行的开销。更好的长期方案是引入 ModuleObserver 管理 Module 生命周期,并在模块添加或移除时发出信号。

  • module:为所有 Module 对象使用同一把锁,加快 NativeModule 生命周期处理。此更改提升了性能;待 GLib 静态分配清理补丁改用更适合跟踪互斥锁的数据结构后,我们会再次审视这一方案。

Frida 16.6.1 发布

这是一个包含若干重要修复和改进的新版本:

  • gumjs:在减少模块引用计数时放弃 JS 锁。这可避免 dispose() 释放缓存句柄时发生死锁。这类操作通常需要获取运行时链接器锁。另一个线程可能已持有该锁,同时等待 JS 锁。发生这种情况的常见场景是,agent 向运行时链接器注册了一个回调,每当加载或卸载模块时就会调用。

    感谢 @mrmacete 报告。

  • agent:在版本脚本中排除特定于操作系统/体系结构的符号。FreeBSD 14.2 的默认工具链等较新的工具链,不接受对不存在符号的引用。我们不再列出只为 Android 构建定义的 JNI_OnLoad,而是为 Android 使用单独的版本脚本。

  • ci:将 CI 从已经结束生命周期的 FreeBSD 14.0 迁移到 FreeBSD 14.2。我们的 FreeBSD CI 在过去几周的某个时候坏了,一直没被发现,直到它导致上一个版本未能发布。糟糕!

Frida 16.6.0 发布

很高兴宣布 Frida 16.6.0 发布,它显著改进了模块符号处理和性能,并修复了一些错误。

以下是主要亮点:

  • android:改善 ART 兼容性:
    • 当缺少导出项时查找符号,因为 Frida 现已支持解析 .gnu_debugdata。
    • 处理 runFlip 签名的变化(感谢 @matbrik)。
  • android:修复 enumerateLoadedClasses() 中的溢出(感谢 @123edi10)。 现在会逐步创建和清理全局引用,而不是在开始和结束时一次性处理全部引用。
  • android:在 registerClass() 中支持静态方法(感谢 @5andr0)。
  • java:修复 32 位系统上由 JVMTI 驱动的 Java.choose()。
  • module:将 Module API 改为实例方法,以便高效执行多次查询。之前只在 JavaScript(GumJS)层以这种方式建模,其中这类 JS 对象会将模块路径作为字符串传给 enumerateExports() 等每次查询。底层 C API 现在也以相同方式建模。
  • gumjs:添加 findSymbolByName() 和 getSymbolByName() 方法。 直接以原生方式按名称查找符号,而不是枚举所有符号后再在 JavaScript 中过滤。
  • module:优化 find_symbol_by_name() 的回退路径。当 Module 实现缺少优化的符号查找方法时, 构建排序索引并对其进行二分搜索。
  • elf-module:未找到符号时使用 MiniDebugInfo。当 enumerate_symbols() 遇到内存中 没有符号的 ELF 时,实例化一个离线 ElfModule 实例并解析 .gnu_debugdata 节。 解压其中嵌入的 ELF,并将其符号作为回退。
  • ncm:将每次传输的数据报上限设为 16,改善用户空间 USB CDC-NCM 驱动的性能 (感谢 @hsorbo 与我结对编程!)。
  • 移植到新的 Gum.Module API。已转为实例方法,以便高效执行多次查询。
  • 停止支持在无 GObject 的情况下运行。节省的体积很小,不足以抵消增加的复杂性和降低的代码可读性。
  • gumjs:修复 V8 NativeCallback 释放后使用问题(非 Interceptor),其中 CpuContext 的作用域过窄。

一如既往,祝大家黑客愉快!

Frida 16.5.9 发布

糟糕,软件开发真难!这里又有一个快速发布,用于解决我们今天早些时候遗漏的问题。

我们修复了 Meson 构建脚本中的一个问题:在 frida-core 最近的变更之后,modulemap 依赖项 没有被正确指定。具体而言,core_public_h 现在是一个自定义目标索引,因此不能再直接使用。 我们现在改为依赖它的父目标 core_api。

特别感谢 @hsorbo 与我共同完成此项修复。

Frida 16.5.8 发布

这个令人兴奋的新版本为多个组件带来性能提升和错误修复,尤其是 Fruity 后端。@hsorbo 与我合作完成了以下改进:

  • fruity: 通过多重传输提升 NCM 性能和数据传输效率。
  • fruity: 改进用户空间 NCM 驱动以执行批处理,减少突发流量时的丢包。
  • fruity: 启用 lwIP TCP 时间戳和 SACK,与 Linux IP 栈默认值保持一致并提升网络性能。
  • fruity: 将 lwIP TCP 最大报文段长度(MSS)提升到 4036,改善 TCP 隧道性能。
  • fruity: 考虑 frida-server 的 bind() 延迟,提高连接建立可靠性。
  • fruity: 修复拆卸期间创建 USB 操作时的崩溃。
  • fruity: 在内核 NCM 可用时避免不必要的 USB 访问,改进非 macOS 系统上的 USB 设备处理。
  • fruity: 确保即使存在冲突服务也能正确建立连接,修复直连通道可靠性。感谢 @mrmacete 协助定位。
  • fruity: 改进 TcpTunnelConnection 拆卸,确保远端关闭连接时正确清理。

  • api: 生成正确的 GObject Introspection Repository(GIR),包含必要类型并省略内部类型。
  • api: 避免在 API 中公开内部类型。
  • api: 省略涉及 HostSession 的 API。

  • build: 修改输出逻辑,避免重复写入输出文件,加快增量构建。
  • build: 利用 Meson 的 custom_target() 多输出支持,避免多次解析 API。
  • compat: 创建相对子项目符号链接,使源码树移动后仍可构建。
  • compat: 修复 compat.symlink_to() 对子项目的错误处理。

  • windows: 修复 PID 不存在时的 cpu_type_from_pid()。
  • windows: 在 Windows 11+ 上使用 GetProcessInformation(),确保正确使用 ProcessMachineTypeInfo。

一如既往,非常感谢 @hsorbo 和 @mrmacete 为本次发布作出的宝贵贡献。

Frida 16.5.7 发布

这是一个令人兴奋的新版本,包含跨平台的改进和新功能。以下是新内容:

Fruity 后端改进

@hsorbo 和我一直在努力增强 Fruity 后端,我们很高兴分享以下改进:

  • 添加对 TCP 隧道协议的支持,并将其设为默认值,以匹配 Apple 的新行为。 可以使用 FRIDA_FRUITY_TUNNEL_PROTOCOL 环境变量切回 QUIC。
  • 修复旧版 OS 的隧道逻辑边界情况,即使 usbmuxd 不可用也能确保可靠运行。
  • 优雅关闭 TunnelConnection,以提高稳定性。
  • 修复拆除期间启动 USB 操作时可能出现的挂起,防止传输卡住。
  • 修复 QuicTunnelConnection 拆除逻辑,正确处理关闭操作期间的错误。
  • 放宽 NCM 接口存在性检查,只需一个可用的网络接口。
  • 调整为始终先尝试 USB 传输,因为网络传输可能更慢或不可用。
  • 改进跳过受限回退时对超时情况的处理。
  • 现在预期网络设备会快速响应与配对服务的连接,从而在设备已休眠时改善用户体验。
  • 修复新式设备的 CoreDevice UDID 逻辑。

Android

  • 当 extractNativeLibs 设为 false 时,Gadget 现在支持从 APK 加载资产, 改善了对现代 Android 应用的兼容性(感谢 @gergesh)。
  • 恢复注入器对共享 libc 区间的处理,当目标进程最低的 libc.so 区间是共享映射时, 确保行为正确(感谢 @lx866)。

Linux

  • 改善注入器与 MUSL 的兼容性,处理 loader 字符串的差异(感谢 @luckycat889)。
  • 支持在构建 helper 时覆盖配置,为构建提供更大灵活性(感谢 @luckycat889)。
  • 为注入器的远程调用分配栈,改善与 Go 应用等使用小栈的程序的兼容性(感谢 @ajwerner)。
  • 添加重建 helper 二进制文件的 CI,确保源码与已检入的二进制文件保持一致(感谢 @ajwerner)。
  • 当 $TMPDIR 为 noexec 时选择其他临时目录

跨平台

  • 在构建系统中添加对非 UTF-8 locale 的支持,确保更好地兼容使用各种 locale 设置的系统 (感谢 @JunGe-Y)。
  • 在构建系统中添加对 PowerPC 架构的支持。
  • 在 frida-inject 和 RpcClient 内部添加对二进制数据处理的支持。

祝大家黑客愉快!


Frida 16.5.6 发布

这是一个快速错误修复版本,进一步改进 Fruity 后端。@hsorbo 和我给咖啡杯续满咖啡,集中完成了以下修复:

  • fruity:修复 TcpConnection 中的释放后使用。错误回调可能在 PCB 已被释放后才调用,因此清除其用户数据会造成释放后使用,把 NULL 指针写入未知位置。
  • fruity:修复 DTXArgumentList.parse() 的 GValue 初始化;遇到对象时我们使用了错误的 setter。GLib 的运行时检查捕获了此问题,但由于我们通常不启用这些检查进行构建,它一直未被发现。
  • payload:修复 AddressSanitizer 构建回归。

Frida 16.5.5 发布

原来 Frida 16.5.3 中混入了一项严重的稳定性回归:当收到不是来自 CoreDevice 隧道的 入站连接时,frida-server 会崩溃。感谢 @mrmacete 在有问题的版本发布后仅几小时 就完成调查和修复。🎉 尽情享用!

Frida 16.5.4 发布

上一版本的二进制文件未能发布,原因是一个本不应升级 frida-node NAN 依赖的脚本将其升级,而最新代码又破坏了 Electron 支持。此版本回滚了该变更,同时将 frida.Compiler 的 @types/frida-gum 升级到 18.7.1。

Frida 16.5.3 发布

很高兴为大家带来又一个错误修复版本,进一步改进 Fruity 后端和 iOS 稳定性, 并修复使用正则表达式扫描内存时的问题。

下文未特别注明作者的改动,均由 [@hsorbo][] 和我在一系列愉快的结对编程中完成。

长话短说,改动如下:

  • memory:将内存扫描的正则表达式模式设为原始模式,使搜索在并非有效 UTF-8 的二进制区域中 也能可靠工作。感谢 @mrmacete!
  • web-service:关闭已移除动态接口的连接,避免它们一直残留,直至耗尽文件描述符。
  • network-stack:处理 TcpConnection 被突然销毁的情况。此前我们会释放 TCP PCB, 却未能通知任何仍然存活的 TcpIOSource 实例和被阻塞的 TcpInputStream.read() 调用。
  • network-stack:修复对等端关闭时竞争条件导致的 TCP 数据丢失。关闭操作会让我们释放 PCB, 随后 recv() 逻辑因为 PCB 已不存在而提前返回。此时 RX 缓冲区中可能仍有数据, 但应用无法看到它们。
  • network-stack:修复 TcpInputStream.read() 中的竞争条件:notify::pending-io 信号在调用 is_readable() 之后、连接信号处理程序之前触发。
  • fruity:使用 USB 产品字符串作为传输名称。
  • fruity:修复 iOS < 16 上的 USB 模式解析;此时模式是一个 3 字节 blob。
  • fruity:向上传递 USB 权限错误。
  • fruity:遇到 17 之前版本的 iOS 隧道服务时退出,而不是崩溃。
  • control-service:修复 CoreDevice 系统上的可靠性问题。在所有接口上监听的单个传输代理, 可能会在尝试从隧道内部与其通信时导致过早的 TCP RST。具体原因尚不清楚, 但我们已经确认,为每个动态接口/隧道设置一个代理可以解决问题。我们还观察到, 监听所有接口但仅限 IPv6 也能避免该问题。
  • meson:修复以 GLib 作为子项目时的 i/tvOS 编译。
  • meson:在 FreeBSD 上禁用 Fruity 及相关组件,因为我们现在依赖一个仅存在于自有 libusb 中的 API。如果有人希望在 FreeBSD 上使用这些后端,修复起来应该不会太难,非常欢迎提交 PR。

Frida 16.5.2 发布

这是一个进一步改善 Fruity 后端的快速错误修复版本。@hsorbo 和我倒满咖啡, 一起敲定了以下修复和调整:

  • fruity:隧道设置失败时复用 NCM 对端。
  • fruity:处理 iDevice 尚未与任何主机配对的情况。
  • fruity:处理 USB TunnelConnection 断开。
  • fruity:修复不可靠的模式切换激活。
  • fruity:修复使用我们的 NCM 驱动时的拆除逻辑。
  • fruity:修复非 macOS 平台上 find_tunnel() 的错误编组。
  • fruity:广播我们对 RemoteXPC 协议的支持。

Frida 16.5.1 发布

由于 watchOS 上的一项构建回归,上一个版本的二进制文件未能发布;本版本迅速修复了 这个问题。

Frida 16.5.0 发布

有些人可能遇到过这种情况:内存中的某段数据看起来很有意思,你想定位负责处理它的代码。你或许尝试过 Frida 的 MemoryAccessMonitor API,却发现页面粒度很难使用。也就是说,可能必须收集大量样本,才有机会捕获访问该页面上特定字节的代码。在使用 4K 页面的系统上已经很困难,在使用 16K 页面的现代 Apple 系统上则更糟。

为解决这个问题,@hsorbo 和我倒满咖啡开始工作,实现了硬件断点和观察点支持。简而言之,Process.enumerateThreads() 返回的线程对象现在提供 setHardwareBreakpoint()、setHardwareWatchpoint(),以及之后用于取消它们的对应方法。将这些方法与 Process.setExceptionHandler() 结合使用:在异常处理器中调用取消方法并返回 true,表示异常已处理,应恢复执行。

演示时间

来实际试用这些新 API。目标选择 id Software 在 2024 年全新再版的 DOOM + DOOM II。

DOOM

首先要弄清子弹数量存储在内存中的什么位置。编写一个小型 Agent 来帮助完成:

let matches = [];

function scan(pattern) {
  const locations = new Set();
  for (const r of Process.enumerateMallocRanges()) {
    for (const match of Memory.scanSync(r.base, r.size, pattern)) {
      locations.add(match.address.toString());
    }
  }
  matches = Array.from(locations).map(ptr);
  console.log('Found', matches.length, 'matches');
}

function reduce(val) {
  matches = matches.filter(location => location.readU32() === val);
  console.log('Filtered down to:');
  console.log(JSON.stringify(matches));
}

function patternFromU32(val) {
  return new MatchPattern(ptr(val).toMatchPattern().substr(0, 11));
}

然后把它加载到游戏中:

$ frida -n doom.exe -l demo.js
…
[Local::doom.exe ]->

已知当前有 50 发子弹,因此查找所有包含数值 50 的堆分配;该值以原生 uint32 编码:

[Local::doom.exe ]-> scan(patternFromU32(50))
Found 6947 matches

结果相当多。发射一发子弹,再检查哪些位置现在包含数值 49,以此缩小范围:

[Local::doom.exe ]-> reduce(49)
Filtered down to:
["0x1fbf5191884"]

找到了!既然知道子弹数量存储在何处,下一步就是找到开火时更新子弹数量的代码。为 Agent 再添加一个辅助函数:

function installWatchpoint(address, size, conditions) {
  const thread = Process.enumerateThreads()[0];

  Process.setExceptionHandler(e => {
    console.log(`\n=== Handler got ${e.type} exception at ${e.context.pc}`);

    if (Process.getCurrentThreadId() === thread.id &&
        ['breakpoint', 'single-step'].includes(e.type)) {
      thread.unsetHardwareWatchpoint(0);
      console.log('\tDisabled hardware watchpoint');
      return true;
    }

    console.log('\tPassing to application');
    return false;
  });

  thread.setHardwareWatchpoint(0, address, size, conditions);

  console.log('Ready');
}

调用它:

[Local::doom.exe ]-> installWatchpoint(ptr('0x1fbf5191884'), 4, 'w')
Ready

接着切回游戏,再发射一发子弹:

[Local::doom.exe ]->
=== Handler got system exception at 0x7ffc2bc2fabc
        Passing to application

=== Handler got single-step exception at 0x7ff6f0a21010
        Disabled hardware watchpoint

很好,看起来很有希望。来解析该地址的符号:

[Local::doom.exe ]-> ammoCode = ptr('0x7ff6f0a21010')
"0x7ff6f0a21010"
[Local::doom.exe ]-> ammoModule = Process.getModuleByAddress(ammoCode)
{
    "base": "0x7ff6f0730000",
    "name": "DOOM.exe",
    "path": "C:\\Program Files (x86)\\Steam\\steamapps\\common\\Ultimate Doom\\rerelease\\DOOM.exe",
    "size": 15495168
}
[Local::doom.exe ]-> offset = ammoCode.sub(ammoModule.base)
"0x2f1010"

使用 r2 仔细查看:

DOOM

可以看到,异常处理器中观察到的程序计数器位于触发观察点的 sub 指令之后一条指令上。

因此可以设置一个内联 Hook,每次开火时都会触发:

Interceptor.attach(Module.getBaseAddress('doom.exe').add(0x2f1010), function () {
  const ammoLeft = this.context.rax.add(4).readU32();
  console.log(`Shots fired! Ammo left: ${ammoLeft}`);
});
[Local::doom.exe ]-> Shots fired! Ammo left: 42
Shots fired! Ammo left: 41
Shots fired! Ammo left: 40
Shots fired! Ammo left: 39
Shots fired! Ammo left: 38

同样可以轻松制作无限弹药作弊功能:

Interceptor.attach(Module.getBaseAddress('doom.exe').add(0x2f100d), function () {
  this.context.rbx = ptr(0);
  console.log(`Shots fired! Pretending no ammo was actually used`);
});
[Local::doom.exe ]-> Shots fired! Pretending no ammo was actually used
Shots fired! Pretending no ammo was actually used

看,无限弹药!

注意,也可以用 Memory.patchCode() 把 sub 替换为 3 字节 nop 来实现,X86Writer 可通过 putNopPadding(3) 完成。Interceptor Hook 的优势是脚本卸载时会自动回滚,而且便于执行任意代码。

ARM 上的 Windows

此版本另一项亮点是支持 ARM 上的 Windows。这意味着 arm64 版 Frida 可以注入原生 arm64 进程,也可注入模拟的 x86_64 和 x86 进程。

不过我们尚未提供二进制文件,因为仍在等待 GitHub 向开源项目提供 arm64 runner;目前只有 Team 和 Enterprise Cloud 客户可以使用。技术上可以从 x86_64 构建机交叉编译,但我们很快遇到 Meson 的 MSVC 支持问题,因此决定暂缓。

结语

此外还有许多令人兴奋的变化,请务必查看下面的变更日志。

尽情体验吧!

变更日志

  • thread:支持硬件断点和观察点。
  • fruity:修复 perform_on_lwip_thread() 中的死锁。
  • windows:新增 arm64 支持。
  • windows:将 Exceptor 迁移到 Microsoft 的 VEH API。
  • linux:分离时处理进程已退出的情况。感谢 @ajwerner!
  • linux:修复 MIPS 上的 clone() 包装器。
  • java:处理 Android GC 周期处理器未导出的情况。感谢 @thinhbuzz!
  • java:初步支持 Windows 上的 OpenJDK 17。感谢 @FrankSpierings!
  • meson:将 frida-netif 加入公共 frida-core,使 frida-core devkit 包含所有所需符号。
  • node:新增便利工厂函数 Cancellable.withTimeout()。感谢 @hsorbo!
  • node:新增便利方法 Cancellable.combine()。感谢 @hsorbo!

Frida 16.4.10 发布

这是一个进一步改进 Fruity 后端的快速错误修复版本;@hsorbo 和我装满咖啡杯, 一鼓作气完成了以下修复:

  • tunnel-connection:接通缺失的流关闭逻辑。
  • tunnel-connection:确保 JSON 请求独占一个 UDP 数据包。打开隧道时,如果一个 数据报和流数据落在同一个 UDP 数据包中,似乎会出现问题。我们增大了虚拟数据报 以避免这种情况。
  • tunnel-connection:连接断开后始终避免写入,否则会导致崩溃。
  • network-stack:从 lwIP 线程调用 perform_on_lwip_thread() 时直接处理, 而不是发生死锁。

Frida 16.4.9 发布

这是一个解决若干问题的快速错误修复版本:

  • tunnel-interface-observer:修复 SCDynamicStoreCopyKeyList() 失败时 i/tvOS 上的 start() 崩溃。感谢 @mrmacete!
  • darwin-mapper:在构造函数之前初始化 TLV。感谢 @jiska!
  • darwin-mapper:修复 arm64 的 TLV 初始化运行时代码。感谢 @jiska!
  • arm64-writer:修复 UBFM 和 LS{L,R} 的编码。感谢 @jiska!

Frida 16.4.8 发布

这是一个进一步改进 Fruity 后端的快速错误修复版本:

  • lockdown-client:向上传播 CONNECTION_CLOSED 错误。感谢 @hsorbo!
  • fruity:使 find_usbmux_device() 不再抛出异常。感谢 @hsorbo!
  • fruity:防止 lockdown 发生 open.- ->close 循环。
  • fruity:修复已关闭 lockdown client 的失效处理。感谢 @hsorbo!

Frida 16.4.7 发布

这是一个解决 Windows 崩溃的快速错误修复版本:

  • fruity:修复在 Windows 上枚举网络接口时的崩溃。部分接口没有单播地址, 因此需要忽略。感谢 @xiofee!

Frida 16.4.6 发布

此版本包含大量改进:

  • fruity:如果存在,则使用 USB 传输层的 UsbmuxDevice,以便访问环回接口并 获得更好的性能。
  • fruity:在非 macOS 平台上处理不支持隧道的设备。
  • fruity:如果存在,则公开 USB 传输层中的名称。使用 UsbmuxTransport 时, 它提供的名称描述性更强。
  • gumjs:确保在构建 devkit 前先构建 Gum .a。感谢 @Hexploitable!
  • gumjs:生成更简单的枚举值查找代码。
  • spinlock:整合为单一实现。
  • java:修复 Android >= 15 的 art::Thread::DecodeJObject。感谢 @esauvisky!

Frida 16.4.5 发布

这是一次快速的错误修复版本,解决了几个问题:

  • xpc-client:在 request() 中接入 cancellable,以支持取消 Fruity macOS CoreDevice 后端中的 remotepairingd 请求。
  • java:正确处理 Android ART CMC GC 策略。感谢 @mbricchi!
  • java:修复较新 ART APEX 上的 Java.choose()。感谢 @mbricchi!

Frida 16.4.4 发布

此版本包含大量改进:

  • darwin:处理 macOS Sequoia 和 iOS 18 上的 dyld 重启。
  • darwin:在 macOS Sequoia 和 iOS 18 上等待 ObjC 初始化;如果可用,则使用 notifyObjCInit()。
  • fruity:改进 CoreDevice 配对支持:
    • 修复多组配对关系支持。
    • 及时更新内存中的对等端存储,使新增配对关系无需重启进程即可与网络上的配对服务匹配。
  • ncm:更改配置前分离所有驱动。
  • ncm:避免使用损坏的内核 NCM 驱动。
  • darwin:修复模拟器上的 sysroot。感谢 @CodeColorist!
  • darwin-mapper:在本地解析共享缓存符号,尽可能避免解析器函数,并绕过现有问题:生成的构造函数会尝试把结果写入只读页面。
  • gumjs:修复应用线程上 recv().wait() 的竞态。感谢 @HexKitchen!
  • python:消除对不稳定引用计数 API 的使用,使采用较新 Python 头文件构建的扩展仍可在较旧 Python 运行时上工作。

Frida 16.4.3 发布

本次发布包含一系列改进:

  • fruity:添加对 Windows 和 Linux 上网络设备的支持。
  • ncm:在需要时切换 USB 设备配置。
  • network-stack:修复 TcpConnection 的释放后使用问题。
  • fruity:修复 LWIP.NetworkInterface 绑定。
  • fruity:移除被遗忘的 .pcap 调试输出。
  • dtx:修复 DTXConnection 与 DTXChannel 的清理。
  • buffer:为 read_string() 添加内容验证。
  • buffer:为 read_fixed_string() 添加内容验证。
  • java:修复 Android >= 14 上的 Java.choose()。感谢 @mbricchi!
  • java:处理 CMC GC 策略。感谢 @mbricchi!

Frida 16.4.2 发布

这是一个包含两项 Fruity 后端改进的快速错误修复版本:

  • fruity:处理 libusb 初始化失败的情况。
  • fruity:清理操作系统专用部分。

Frida 16.4.1 发布

这是一个快速错误修复版本,解决了以下几个问题:

  • device:修复 id 和 name 的属性 getter。
  • socket:修复 negotiate_connection() 中的 Host 请求头逻辑。

Frida 16.4.0 发布

这个版本带来了一些令人兴奋的新功能。让我们直接开始吧。

CoreDevice

正如 16.3.0 发布说明中提到的那样,@hsorbo 和我一直在为 Linux 内核的 CDC-NCM 驱动提交补丁,使其与 Apple 的私有网络接口兼容。该补丁现已进入 上游,并将成为 Linux 6.11 的一部分。

与此同时,针对在 Windows 上使用 Frida 的用户,我们刚刚实现了一个 最小化的用户态驱动;当 Frida 检测到内核没有提供驱动时, 现在就会使用它。我们还利用 lwIP 在用户空间中完整实现了以太网和 IPv6。 最终,Frida 可以在 libusb 支持的任何平台上支持 CoreDevice。

结语

此外还有许多令人兴奋的变更,务必查看下面的变更日志。

祝你使用愉快!

变更日志

  • fruity:重新设计以支持用户空间 CDC-NCM。
  • fruity:支持 iOS >= 18 上的 dyld 重启。
  • fruity:在 iOS >= 18 上等待 ObjC 运行时初始化。
  • fruity:修复没有可用 usbmux 连接时的 gadget 上传。
  • fruity:改进 open_channel() 以支持 tcp:service-name。
  • fruity:RSD 端口查找失败时重试。
  • fruity:恢复 HostChannelProvider 实现。
  • fruity:如果 libSystem 已初始化,则跳过获取 dyld 符号。
  • fruity:接通 MacOSCoreDeviceTransport 事件处理。
  • fruity:修复 macOS CoreDevice 连接类型逻辑。
  • fruity:向公开的系统参数添加 os.build 和 hardware。感谢 @as0ler!
  • server 和 gadget:在 iOS 和 tvOS 上监听 Apple 的 CoreDevice 隧道网络接口。
  • xpc-service:修复 request() 对数组的处理。感谢 @hsorbo!
  • xpc-service:支持为 request 参数添加类型注解。
  • python:支持将元组反序列化为 GVariant。
  • python:修复将 bool 反序列化为 GVariant。
  • node:封送至 GVariant 时支持类型注解。
  • node:将 Node.js 要求提升至 >=16 || 14 >=14.17,以匹配 minimatch。
  • java:修复 Android 上 registerClass() 字段条目的顺序。感谢 @eybisi!

Frida 16.3.3 发布

上一个版本因 CI 问题未能发布。此版本唯一的变更就是所需的 CI 修复。 (CI 提供商刚刚移除了一个 FreeBSD runner 镜像,因此我们必须升级到较新的镜像。)

Frida 16.3.2 发布

又到了错误修复版本的发布时间。本次包含不少改进:

  • darwin:注入期间避免调用 thread_set_state(),从而不会在 macOS >= 14.5 等系统上被系统终止。感谢 @_saagarjha 提供第一版修复!
  • fruity:对需要的服务执行 RSDCheckin。这样,在 CoreDevice 隧道可用时,仍能保持 lockdown 服务 open_channel() 的向后兼容性。
  • fruity:停止缓存 LockdownClient,避免多个使用方引发问题。连接未越狱 iOS 设备后使用 frida-ps 即可复现。
  • python:修复 open_service() plist 示例。
  • node:修复值为 undefined 时的 spawn() 选项逻辑。感谢 @as0ler 报告并协助定位!
  • node:将 aux 选项封送到 GVariant 时跳过 undefined。
  • node:将对象封送到 GVariant 时跳过 undefined。
  • node:处理封送到 GVariant 时的错误。
  • node:修复 openService() plist 示例。

感谢 @hsorbo 与我通过愉快而高效的结对编程完成上述所有工作!🙌

注意:由于 CI 问题,此版本最终未发布;该问题已在 16.3.3 中解决。

Frida 16.3.1 发布

这是一个快速错误修复版本,用于解决 Node.js 绑定的打包问题。上传的预构建文件没有剥离符号,导出了一些本不应导出的符号。感谢 0xDC00 报告此问题。

祝使用愉快!

Frida 16.3.0 发布

此版本带来了一些令人兴奋的新功能。让我们直接开始。

CoreDevice

从 iOS 17 开始,Apple 改用了一种与 iDevice 端服务通信的新方式, 其中包括开发者磁盘镜像(DDI)服务。这套新机制统一了 Apple 软件与 其他 Apple 设备的通信方式,称为 CoreDevice。它似乎起源于 Apple 推出 T2 协处理器的时期。Cisco 的 DUO 团队早在 2019 年就发布了一些出色的 research。

与 T2 一样,iOS 使用的新协议栈也通过 RemoteXPC 与服务通信。 不过情况更复杂一些,因为移动设备不像 T2 那样始终与 macOS 保持连接, 并且还有配对概念。幸运的是,@doronz88 已经出色地逆向并 documenting了我们实现新协议所需的大部分内容,为我们节省了大量时间。

即便如此,这仍是一项巨大的工程,但过程非常有趣——@hsorbo 和我很享受 结对编程。其中涉及不少环节,下面快速走读一遍。

当 iDevice 插入后,它会暴露一个 USB CDC-NCM 网络接口,称为“私有”接口。 它也会像过去一样暴露一个用于网络共享的接口——只不过以前使用的是 Apple 的专有协议,而不是 CDC-NCM。

这也是我们尝试从 Linux 主机与它通信时遇到的第一批挑战。首先,iOS 设备 需要一个 USB 厂商请求,才能切换模式并暴露新接口。这部分很简单:只要将 环境变量 USBMUXD_DEFAULT_DEVICE_MODE 设为 3,usbmuxd 守护进程 就能为我们完成。到这里一切顺利。

下一个挑战是 Linux 内核的 CDC-NCM 驱动无法绑定该设备。经过一番调试, 我们发现原因是私有网络接口缺少状态端点。驱动通过状态端点得知 网线是否已插入。Apple 的网络共享接口具有这样的端点,这很合理——如果 禁用网络共享,就像拔掉网线一样。但私有接口始终存在,因此 Apple 没有为它 添加状态端点也完全可以理解。

我们很快开发了一个kernel driver patch,取消了必须有状态端点的要求, 这让它成功工作。后来我们意识到,网络共享接口仍然应当要求状态端点, 因此又进一步完善了补丁。计划是在接下来几天内提交它。

言归正传,网络接口启动后,主机端使用 mDNS 定位 RemoteServiceDiscovery(RSD) 服务监听的 IPv6 地址。主机连接到它,使用 HTTP/2 并来回传递 RemoteXPC 消息。 这个特定的 RSD 服务会告诉主机:私有接口上有哪些服务可用、它们监听的端口号, 以及各自使用的通信协议等详细信息。

知道哪些服务监听哪些端口后,主机会查找 Tunnel 服务。该服务允许主机与设备 建立隧道,像 VPN 一样让主机能够与隧道内的服务通信。由于建立这种隧道 需要主机与设备之间存在配对关系,因此隧道内的服务允许主机完成比隧道外 多得多的操作。

基础协议与 RSD 相同。经过若干轮涉及配对参数二进制大块和密码学的往返后, 配对关系会被创建或验证。此时两个端点已在使用加密通信,主机随后要求 Tunnel 服务设置一个隧道监听器。

现在,假设主机请求的是默认传输方式 QUIC,它便会连接过去。需要说明的是, Tunnel 服务也支持普通 TCP。这大概是为不自带 QUIC 协议栈的旧版 macOS 准备的。 另一件值得一提的事是,Tunnel 服务会向主机提供一对密钥,主机会将其用于连接建立过程。

连接建立后,设备会通过可靠流向主机发送一些数据。数据以 8 字节的魔数 “CDTunnel”开头,后面是一个大端序 uint16,用来指定随后负载的大小。负载是 JSON, 它会告诉主机:主机在隧道内的端点使用哪个 IPv6 地址,以及网络掩码和 MTU。 它还会告诉主机设备自己在隧道内的 IPv6 地址,以及 RSD 服务监听的端口。

然后,主机会按刚才收到的信息配置一个 TUN 设备,并开始将从 QUIC 连接收到的 不可靠数据报送入其中。反方向上,每当 TUN 设备产生新数据包时,主机就会把它 送入 QUIC 连接。

到这一步,主机会连接到隧道内的 RSD 端点,从那里访问设备提供的所有服务。 这种新方案的妙处在于,与设备端服务通信的客户端无需操心密码学,也无需 提供配对关系证明。它们只需在隧道接口上建立明文 TCP 连接,剩下的由 QUIC 透明处理。

更酷的是,主机可以通过 USB 和 WiFi 建立隧道;由于 QUIC 原生支持多路径, 设备可在有线和无线之间无缝切换,而不会中断与隧道内服务的连接。

因此,实现完所有这些之后,我们既兴奋又乐观。剩下的只是完成各平台集成。 然而,嗯……事情就在这里变得困难得多。我们在 macOS 上卡了一阵子,因为意识到 必须借用 Apple 现有的隧道。我们发现,已经打开一条隧道时,Tunnel 服务会拒绝与我们通信, 因此无法简单地在 Apple 的隧道旁再开一条。

虽然我们可以请用户向 remoted 发送 SIGSTOP,好让我们建立自己的隧道, 但这样的用户体验不会太好。特别是任何想与设备通信的 Apple 软件届时都无法工作, 会让 Xcode、Console 等工具的用处大打折扣。

我们很快就找到了可用于确定 Apple 隧道内设备端地址的私有 API,也能创建 所谓的“assertion”,以便在我们需要期间一直保持隧道开启。但我们无法解决的部分是, 如何发现隧道内设备端的 RSD 端口。

我们知道,以本地用户身份运行的 remotepairingd 知道 RSD 端口, 但找不到让它告诉我们的方法。经过大量头脑风暴,我们只想到了一些不切实际的方案:

  • 对设备端地址进行端口扫描:可能很慢,而更快的实现需要 root 权限才能访问原始套接字。
  • 在 remotepairingd 的地址空间中扫描设备端的隧道地址,并定位附近存储的端口: 启用 SIP 时不可行。
  • 依赖设备端 frida-server 帮我们弄清状况:在受限 iOS 上不可行,而且实现复杂、可能很脆弱。
  • 从 syslog 中获取:可能需要等很久或要求用户手动操作, 而通过杀死系统守护进程来强制重连会带来中断。
  • 放弃使用隧道,转向更高层的抽象,例如每次需要打开服务时使用 MobileDevice.framework:这要求我们拥有 entitlement。具体需要哪些取决于特定服务。 例如,如果想与 com.apple.coredevice.appservice 通信,就需要 com.apple.private.CoreDevice.canInstallCustomerContent entitlement。但试图给自己添加 com.apple.private.* entitlement 根本行不通,因为系统会杀死我们:只有 Apple 签名的程序 才能使用这类 entitlement。

我们在这里决定先休息一下,暂时关注其他事情,直到最终找到一种办法: remoted 进程持有一条与隧道内 RSD 服务的连接。我们最终借助与 Apple netstat 相同的 API,得到了一个简单方案:

foreach (var item in XNU.query_active_tcp_connections ()) {
	if (item.family != IPV6)
		continue;
	if (!item.foreign_address.equal (tunnel_device_address))
		continue;
	if (Darwin.XNU.proc_pidpath (item.effective_pid, path_buf) <= 0)
		continue;
	if (path != "/usr/libexec/remoted")
		continue;

	try {
		var connectable = new InetSocketAddress (tunnel_device_address, item.foreign_port);

		var sc = new SocketClient ();
		SocketConnection connection = yield sc.connect_async (connectable, cancellable);
		Tcp.enable_nodelay (connection.socket);

		return yield DiscoveryService.open (connection, cancellable);
	} catch (GLib.Error e) {
	}
}

不过 Linux 这边的情况要简单得多,因为一切尽在掌控,可以自行建立隧道。 但还是有一个挑战:我们不想要求提升权限才能创建 tun 设备。我们想出的解决方案是 使用 lwIP 在用户模式下处理 IPv6。由于其他构件在设计时就面向 GLib.IOStream, 与套接字和网络解耦,我们所要做的只是实现一个使用 lwIP 承担繁重工作的 IOStream。 来自 QUIC 连接的数据报会被送入 lwIP 网络接口,而该网络接口发出的数据包又会作为 数据报送入 QUIC 连接。

接下来是 Windows 端。我们做了一些调查,很快意识到 Apple 软件目前并不建立隧道。 官方驱动似乎也会一直占用 USB 设备,这意味着我们无法轻松触发模式切换并自行处理。 Windows 这块拼图可能存在一个优雅的解法,但我们意识到自己已经在这个兔子洞里钻得太深, 最明智的做法是留到以后再解决。所以,如果有读者愿意帮忙,请与我们联系。

另一个未来需要改进的领域是,我们在 macOS 上只支持有线连接。一旦更新 frida-server 和 frida-gadget,使它们在隧道接口出现时就开始监听,这应该很容易改善。

受限的 iOS 17

借助新的 CoreDevice 基础设施,我们也恢复了在受限 iOS 17 上的插桩支持。 这意味着我们又可以在最新 iOS(写作本文时为 17.5.1)上启动(可调试)应用。 目前仍有一个问题:不先调用 spawn() 就执行 attach() 仍然无法工作,因为我们的受限注入器 在附加到已运行应用时尚不支持可重启的 dyld 情况。这将在未来版本中解决。

Device.open_service() 和 Service API

由于 Frida 需要使用相当多的协议与 Apple 的设备端服务交互,而应用程序有时 也需要其他这类服务,这就带来了一个挑战。应用程序可以自行实现这些协议, 例如先使用 Device.open_channel() API 打开指向特定服务的 IOStream。但这意味着 它们必须重复实现和维护协议栈的工作;对于 DTX 这类协议,它们还可能浪费时间去建立 Frida 为自身需求已经建立的连接。

一个可能的解决方案是把这些服务客户端变成公开 API,并在语言绑定中暴露它们。 我们还必须为应用程序可能想要通信的所有 Apple 服务实现客户端。这些服务数量不少, 会让 Frida API 变得无比庞大。这也会让 Frida 变成什么都包的大杂烩,显然不是我们想走的方向。

思考了一阵子后,我意识到可以提供一个通用抽象,让应用程序能与任意想要的服务通信。 所以上周,@hsorbo 和我倒满咖啡,开始实现这个想法。

在 Python 中与 RemoteXPC 服务通信就是这么简单:

import frida
import pprint

device = frida.get_usb_device()

appservice = device.open_service("xpc:com.apple.coredevice.appservice")
response = appservice.request({
    "CoreDevice.featureIdentifier": "com.apple.coredevice.feature.listprocesses",
    "CoreDevice.action": {},
    "CoreDevice.input": {},
})
pprint.pp(response)

下面是 Node.js 中的同一个示例:

import frida from 'frida';
import util from 'util';

const device = await frida.getUsbDevice();

const appservice = await device.openService('xpc:com.apple.coredevice.appservice');
const response = await appservice.request({
  'CoreDevice.featureIdentifier': 'com.apple.coredevice.feature.listprocesses',
  'CoreDevice.action': {},
  'CoreDevice.input': {},
});
console.log(util.inspect(response, {
  colors: true,
  depth: Infinity,
  maxArrayLength: Infinity
}));

结果如下:

open-service-xpc.png

既然我们已经看过如何从 Python 和 Node.js 使用新的 open_service() API, 也应该提一下:从 C 中使用这个 API 也(几乎)同样简单:

#include <frida-core.h>

int
main (int argc,
      char * argv[])
{
  GCancellable * cancellable = NULL;
  GError * error = NULL;

  frida_init ();

  FridaDeviceManager * manager = frida_device_manager_new ();

  FridaDevice * device = frida_device_manager_get_device_by_type_sync (manager, FRIDA_DEVICE_TYPE_USB, -1, cancellable, &error);
  FridaService * service = frida_device_open_service_sync (device, "xpc:com.apple.coredevice.appservice", cancellable, &error);

  GVariant * parameters = g_variant_new_parsed ("{"
    "'CoreDevice.featureIdentifier': <'com.apple.coredevice.feature.listprocesses'>,"
    "'CoreDevice.action': <@a{sv} {}>,"
    "'CoreDevice.input': <@a{sv} {}>"
  "}");
  GVariant * response = frida_service_request_sync (service, parameters, cancellable, &error);

  gchar * str = g_variant_print (response, FALSE);
  g_printerr ("%s\n", str);

  return 0;
}

(为了简洁,省略了错误处理和清理。)

传给 open_service() 的字符串是服务可访问的地址,它以协议标识符开头, 后面跟着冒号和服务名。该方法返回 Service 接口的一个实现,其外观如下:

public interface Service : Object {
	public signal void close ();
	public signal void message (Variant message);

	public abstract bool is_closed ();
	public abstract async void activate (Cancellable? cancellable = null) throws Error, IOError;
	public abstract async void cancel (Cancellable? cancellable = null) throws IOError;
	public abstract async Variant request (Variant parameters, Cancellable? cancellable = null) throws Error, IOError;
}

(为了简洁,省略了同步方法。)

在这里,request() 是一个接收 Variant 的调用,它可以是“任何东西”: 字典、数组、字符串等。具体期望什么取决于特定协议。我们的语言绑定会负责将原生值, 例如 Python 中的 dict,转换为 Variant。request() 返回后,你会得到一个包含响应的 Variant。 它随后被转换成原生值,例如 Python dict。

对于支持通知的协议,每当收到通知时都会发出 message 信号。 由于 Frida API 还为所有方法提供同步版本,使其能从任意线程调用,这就带来了一个挑战: 如果打开特定服务后立即发出消息,你可能来不及注册处理器。这正是 activate() 的用武之地。 服务对象初始处于非活动状态,允许注册信号处理器。准备好接收事件后,可以调用 activate(), 也可以发起 request(),这两者都会让服务对象进入活动状态。

之后,需要关闭时可以调用 cancel()。close 信号可用于得知 Service 何时不再可用, 例如设备被拔出,或者你发送了无效消息,导致它关闭连接。

与 DTX 服务通信也很容易。DTX 是 RemoteXPC 的前身,许多 DDI 服务仍在使用它。

例如,要获取屏幕截图:

import frida

device = frida.get_usb_device()

screenshot = device.open_service("dtx:com.apple.instruments.server.services.screenshot")
png = screenshot.request({"method": "takeScreenshot"})
with open("/path/to/outfile.png", "wb") as f:
    f.write(png)

但还不止如此。我们也支持与旧式 plist 服务通信,你可以发送 plist 作为请求, 并接收一个或多个 plist 响应:

import frida

device = frida.get_usb_device()

diag = device.open_service("plist:com.apple.mobile.diagnostics_relay")
diag.request({"type": "query", "payload": {"Request": "Sleep", "WaitForDisconnect": True}})
diag.request({"type": "query", "payload": {"Request": "Goodbye"}})

你可能已经猜到,这个示例会让连接的 iDevice 进入睡眠。

RPC 二进制数据传递

使用 Gum JavaScript 绑定的读者可能熟悉我们的 RPC API,它让应用程序可以方便地 调用 agent 上的函数。

该功能长期存在一个限制:无法将二进制数据传入已导出函数——你必须以某种方式对其序列化。 现在终于支持了。

例如,假设有以下 agent:

rpc.exports.hello = (name, icon) => {
  console.log(`Name: "${name}"`);
  console.log('Icon:');
  console.log(hexdump(icon, { ansi: true }));
};

现在可以像这样从 Python 调用 hello():

script.exports_sync.hello("Joe", b"\x13\x37")

输出如下:

rpc-binary-parameter.png

请注意,只能传递一个二进制参数,且它必须是最后一个参数。

同一领域的另一项改进是,现在可以在返回二进制数据的同时返回可用 JSON 序列化的 JavaScript 值。之前只支持二选一。现在也终于支持了。

例如,假设有以下 agent:

rpc.exports.peek = name => {
  const module = Process.getModuleByName(name);
  const header = module.base.readByteArray(64);
  return [module, header];
};

可以像这样从 Python 调用 peek():

module, header = script.exports_sync.peek("libSystem.B.dylib")
print("module:", module)
print("header:", header)

如果在存在 libSystem.B.dylib 的平台上运行,可能会输出如下内容:

module: {'name': 'libSystem.B.dylib', 'base': '0x18ec70000', 'size': 8192, 'path': '/usr/lib/libSystem.B.dylib'}
header: b'\xcf\xfa\xed\xfe\x0c\x00\x00\x01\x02\x00\x00\x80\x06\x00\x00\x006\x00\x00\x00\x10\x10\x00\x00\x85\x00\x00\x82\x00\x00\x00\x00\x19\x00\x00\x00(\x02\x00\x00__TEXT\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00@\x0c\x8d\x01\x00\x00\x00'

文末

还有一些其他令人兴奋的变化,请一定查看下面的更改日志。

尽情享用!

更改日志

  • 添加 device.open_service(address),它提供 Service 实现,通过统一接口暴露设备特定服务。
  • fruity:添加 RemoteXPC 支持,并为三种协议 ID 实现 open_service():plist、dtx、xpc。
  • fruity:修复受限 iOS 17 上的 spawn()。
  • fruity:改进 DTX 协议支持。
  • python:添加 open_service() 和 Service API。
  • python:添加对新 RPC 二进制数据传递的支持。
  • python:改进 GVariant 编组支持。
  • node:添加 openService() 和 Service API。
  • node:添加对新 RPC 二进制数据传递的支持。
  • node:改进 GVariant 编组支持。
  • exceptor:在 POSIX 后端添加 SA_ONSTACK 标志。感谢 @asabil!
  • gumjs:支持在 RPC 方法中接收二进制数据。
  • gumjs:支持从 RPC 方法返回值和二进制数据。
  • gumjs:向 CModule 暴露更多 Memory API。感谢 @hillelpinto!
  • plist:修复写出包含 float 和 double 值的二进制 plist 时的支持。

感谢 @hsorbo 在上述所有未单独注明归属的改动中,与我进行了有趣且高效的结对编程!🙌

Frida 16.2.5 发布

这是一个包含三项改进的快速错误修复版本:

  • ci:修复 macOS 上的 frida-node 预构建循环,从而为所有目标生成预构建,而不只是第一个。
  • node:避免依赖 package-lock.json,以便在缺少预构建时支持回退构建。
  • android:在 Java.registerClass() 中将 DexFile 设为只读。从 Android 14 开始, targetSdk >= 34 的应用不得对动态加载的 Dex 文件授予可写权限。感谢 @pandasauce!

尽情享用!

Frida 16.2.4 发布

这是一个快速错误修复版本,用于修复 Windows 上 DebugSymbol API 的回归问题:我们未能打包 DbgHelp 和 SymSrv 库。感谢 0xDC00 如此迅速地报告此问题。

祝使用愉快!

Frida 16.2.2 发布

又到发布时间了,这个版本塞满了各种改进!🎉

构建系统

多年来,我一直对我们的构建系统状况不满意,现在终于鼓起勇气对它进行了大幅重构。

用户体验

让我困扰的一点是,我们的构建系统感觉非常古怪而复杂。运行 make 后会看到一个可构建项目的菜单,但菜单会随操作系统而不同。更改构建选项要么编辑 config.mk,要么在命令行中覆盖它们。如果使用 Windows,还必须使用 Visual Studio(MSVS)。

MSVS 构建系统现已移除,你可以像构建许多其他开源项目一样构建 Frida:

$ ./configure
$ make

如果不需要传入 –prefix 等选项,可以跳过 configure 步骤。该脚本其实只是 Meson setup 命令的薄封装;在 -- 后添加选项,即可直接传给 Meson。也可以运行 make install 安装,它支持用 DESTDIR 环境变量更改输出位置。

交叉编译也很简单。例如要为 iOS/arm64 构建,可以使用 –host=ios-arm64 调用 configure。如果有嵌入式系统的工具链,请传入 –host=$triplet,它会在 PATH 中查找 $triplet-gcc、$triplet-g++ 等。你也可以像在其他构建系统中一样,在环境中添加 CFLAGS、LDFLAGS 等以传入额外标志。

很酷的是,我们的各个仓库现在可以独立构建。你可以克隆 frida-gum 仓库并构建,frida-python、frida-tools 等也一样。frida 仓库不再那么重要;保留它只是为了对一组仓库进行版本管理,并托管发布新版本所用的 CI。

每个仓库都包含所需的 subprojects/*.wrap 文件,用于告诉 Meson 在哪里找到依赖项。这意味着,如果你获取 frida-core 并尝试构建,而 PKG_CONFIG_PATH 中尚无 frida-gum,它将自动获取并构建 frida-gum。另一件很棒的事是,我们的 Python 和 Node.js 绑定现在也会利用此机制,在找不到或无法下载 .whl 或预构建时从源码构建。

既然各个组件现在可以作为子项目良好工作,任何人也都可以轻松地将 Frida 组件集成到自己的项目中。只需向项目顶层源码目录的 subprojects/ 添加 .wrap 文件,并在 meson.build 中调用 dependency()。Meson 会先在系统中查找;如果找不到依赖,它会将 git 仓库克隆到 subprojects/ 中,作为项目的一部分进行构建。也可以告诉 Meson 强制使用这种回退,不在系统中查找。

Gum 的 .wrap 文件可以是这样:

[wrap-git]
url = https://github.com/frida/frida-gum.git
revision = 16.2.4
depth = 1

[provide]
dependency_names = frida-gum-1.0, frida-gum-heap-1.0, frida-gum-prof-1.0, frida-gumjs-1.0, frida-gumjs-inspector-1.0

frida-core 则可以是:

[wrap-git]
url = https://github.com/frida/frida-core.git
revision = 16.2.4
depth = 1

[provide]
dependency_names = frida-core-1.0

我们的 Meson 薄封装也很容易上手,可在这里详细了解。

一点历史

我之所以选择为 Windows 维护独立的构建系统,是因为以前与不少经验丰富的 Windows 开发者合作过,并注意到如果能使用他们喜爱的 IDE,他们会对开源项目兴趣大增。对他们而言,重要的是能在调试器中查看崩溃,跳到属于开源库的栈帧,添加一些临时日志代码,然后按下“Run”快捷键,让 IDE 增量编译并重新链接一切,形成简短畅快的反馈循环。

当时 Frida 的非 Windows 构建系统是 autotools,后来我们迁移到 Meson。虽然 Meson 有 MSVS 后端,可以为我们生成 MSVS 项目文件,但有一个问题阻碍了这么做。MSVS 可在同一个“solution”(工作区)中混合针对不同机器的项目,而 Meson 除构建机外,一次只支持为一种机器编译。由于 Frida 在 Windows 上需要支持向 32 位和 64 位目标注入代码,移除 MSVS 构建系统会导致可用性倒退。因此我一直对放弃 MSVS 构建系统犹豫不决。

非 Windows 平台也有同样的挑战。我最终写了一个为每种架构调用 Meson 的 Makefile,把它们粘合起来。虽然这能工作,但我始终没能让增量构建也可靠运行。不过,今年 3 月下旬,我终于在 frida-core 内部确定了一种本地解法——它是我们唯一需要这种多架构“疯狂操作”的组件。通过在 custom_target() 中递归调用 Meson,我们可以为其他架构构建所需组件。

要让它正确工作耗费了大量精力,但完成后,其余技术栈的开发体验变得好得多。frida 仓库的 Makefile 和 shell 脚本可以删除并换成 Meson。CI 变得更简单、更统一。任何人只需克隆 frida-core 并运行 make,生成的二进制文件就会支持跨架构。(除非通过 –disable-compat / -Dfrida-core:compat=disabled 显式禁用。)

你可能会想:既然现在只使用 Meson,为什么还要运行 make?我最终编写了一层 Meson 薄封装,用于自动下载预构建依赖项、选择合理的链接器标志以生成更小的二进制文件等。各仓库中新的 configure 和 Makefile 文件负责调用 releng/meson_configure.py 和 releng/meson_make.py,它们共同构成 Meson 薄封装。releng 目录是 Frida 各仓库共享的子模块。在调用封装之前,还会确保 releng 子模块已初始化并更新。

维护

在此版本之前,我们维护着七种不同的构建系统:

  1. Meson(非 Windows 上的主要组件)
  2. Visual Studio(Windows 上的主要组件)
  3. GNU Make(非 Windows 上的主要组件元构建系统)
  4. setuptools(Python 绑定)
  5. GYP(Node.js 绑定)
  6. Xcode(Swift 绑定)
  7. QMake(QML 绑定)

自此版本起,我很高兴宣布,我们现在只剩一个构建系统:Meson。

旧状况的主要痛点是必须同时处理 1)和 2),因为所有主要组件都涉及这两者。这意味着,像添加一个源文件这么简单的事,都需要了解两种不同的构建系统。不仅如此,例如 Linux 上的贡献者通常很难测试自己对 Visual Studio 构建系统的改动。

另一个问题是,如果只是添加一个新文件都要处理两个构建系统,开发者就更不愿意重构代码。长期后果是它滋生了坏习惯。“嗯,我应该把这部分拆到单独文件里,但是……不,那太痛苦了,我暂时还是把代码加在这里吧。”

至于剩余那些只用于绑定的构建系统,维护它们似乎没那么糟——毕竟修改这些代码的人通常熟悉它们。这里的挑战在于,除 QMake 外它们都缺少 pkg-config 集成。这意味着 include 路径、库路径和要链接的库会在多个地方重复。当链接内部又使用其他库的静态库时,情况尤其棘手;而我们的语言绑定通常就是这样使用 frida-core。

新功能

此版本有不少令人兴奋的新内容:

  • gumjs:添加 Process.runOnThread(),便于在特定线程上运行任意代码。必须谨慎使用,以避免死锁/重入问题。
  • gumjs:向 Thread.backtrace() 添加 limit 选项。感谢 @davinci-tech!
  • gumjs:用已弃用 API 的替代品扩展 CModule glib.h。
  • stalker:添加 StalkerIterator.put_chaining_return()。感谢 @s1341!
  • stalker:添加 run_on_thread() 和 run_on_thread_sync()。
  • interceptor:添加对 x86 影子栈的支持。感谢 @yjugl!
  • cpu-features:添加 CET_SS 标志和检测逻辑。感谢 @yjugl!
  • x86-writer:添加 cpu_features 字段。感谢 @yjugl!
  • spinlock:添加 try_acquire()。感谢 @mrmacete!
  • cloak:添加 with_lock_held() 和 is_locked()。感谢 @mrmacete!
  • interceptor:添加 with_lock_held() 和 is_locked()。感谢 @mrmacete!
  • darwin:当 helper 崩溃时提示 macOS 启动参数。
  • java:支持在不调用构造函数的情况下实例化类。感谢 @AeonLucid!
  • java:添加对数组的数组的支持。感谢 @histausse!
  • python:让源码发行包可完全从源码构建,而不是只支持使用 devkit 构建。
  • python:移除 MSVS 构建系统。
  • node:添加 Meson 构建系统,移除 prebuild 和 node-gyp 部分。
  • node:找不到预构建时,支持完全从源码构建。
  • clr:添加 Meson 构建系统,移除 MSVS 构建系统。
  • qml:添加 Meson 构建系统,移除 qmake 构建系统。
  • qml:添加对 Qt 6 的支持。感谢 @zaxo7!
  • qml:停止支持 Qt 5。

错误修复

最后但同样重要的是,我们还带来了一长串质量改进:

  • gumjs:在 NativeCallback 调用前后保留线程的系统错误。感谢 @HexKitchen!
  • gumjs:始终向 NativeCallback 暴露线程的系统错误。
  • gumjs:修复 Stalker 实例泄漏。
  • stalker:修复 arm64 上块事件干扰独占访问的问题。感谢 @saicao!
  • memory:修复 RWX 系统上 patch_code() 的保护翻转。
  • swift-api-resolver:修复对间接类型条目的处理。
  • swift:规避 iOS Simulator 上的 Module.load() 问题。感谢 @zydeco!
  • base:修复自定义 GSource 实现中的竞态崩溃。
  • base:修复 p2p AgentSession 注册逻辑。
  • buffer:修复 read_string() 的大小逻辑。感谢 @hsorbo!
  • linux:修复某些 32 位系统上的早期插桩。
  • linux:修复现代 Android 上的 inject_library_blob()。
  • linux:修复不可靠的 exec 转换逻辑。
  • linux:修复不存在 libc 时不可靠的注入。
  • agent:修复 child-gating fork() 场景中的挂起。当 pidfd_getfd() 可用但不允许使用时,例如 Docker 容器内,可复现此问题。
  • windows:为注入使用 RW/RX 权限。这使 Frida 注入与更多软件兼容。特别是 Mozilla Firefox 会在启动地址为 RWX 时拒绝线程启动。感谢 @yjugl!
  • darwin:在 Frida 钩子周围调整 libunwind,以避免破坏使用异常的代码,例如 Objective-C 中通过 @try/@catch 使用异常的代码。感谢 @mrmacete!
  • darwin:在 ThreadSuspendMonitor 中获取 Interceptor 和 Cloak 锁,扩展其作用范围,防止持有 Cloak 或 Interceptor 锁的线程被暂停时出现死锁。感谢 @mrmacete!
  • darwin:修复 InjectInstance dispatch source 拆除时的竞态。
  • darwin:修复 SpawnInstance dispatch source 拆除时的竞态。
  • android:修复 execl() 及相关函数的 child-gating。
  • compiler:升级 @types/frida-gum。感谢 @s1341!
  • modulate:在缺少符号时优雅处理。感谢 @hsorbo!
  • python:将 _frida 包移到 frida 包内。

文末

以上差不多就是全部内容。尽情享用!

Frida 16.2.1 发布

这是一个快速错误修复版本,用于解决影响 palera1n(rootless)和 Dopamine 用户的 iOS 打包错误。感谢 @miticollo 如此迅速地报告此问题。

祝你使用愉快!

Frida 16.2.0 发布

本次带来了许多令人兴奋的新功能。下面直接进入正题。

线程名称

Process.enumerateThreads() API 现在会在可用时一并公开线程名称:

$ frida -U -F
[Pixel 6 Pro::com.google.android.calculator ]-> Process.enumerateThreads()[1]
{
    "id": 9579,
    "name": "Signal Catcher",
    "state": "waiting",
    "context": { … }
}
[Pixel 6 Pro::com.google.android.calculator ]->

感谢 @Hexploitable 提交出色的拉取请求,推动了这项工作 🙌

内存保护属性查询

有时必须快速确定内存页当前的保护属性。感谢 @mrmacete,现在可以这样做:

$ frida -p 0
[Local::SystemSession ]-> Memory.queryProtection(Module.getExportByName(null, 'open'))
"r-x"
[Local::SystemSession ]->

QuickJS 2024-01-13

本版本还包含上个月发布的最新版 QuickJS。这意味着几乎完整支持 ES2023,甚至支持即将 到来的 ES2024 规范中的部分功能,并包含不少错误修复。值得一提的是,现在支持顶层 await, 更容易编写可在两种 JavaScript 运行时上工作的可移植脚本。

隐匿

Frida 会跟踪自身的内存范围、线程等资源,避免进程自省时看到自己。 Process.enumerateThreads() 等自省 API 会确保隐藏 Frida 自身资源,使结果看起来如同 Frida 并不在被插桩进程内部。

使用 Stalker 或其他会暴露原始内存位置的功能时,你可能看到不属于任何已加载模块的代码, 并疑惑其来源。例如,用 Stalker.follow() 跟踪进入或离开被挂钩函数的执行过程时,会执行 一些由 Interceptor 生成的跳板代码。

使用 Gum C API 的 agent 早已能查询给定内存地址、线程等是否归 Frida 所有,但此功能 此前尚未公开给 JavaScript 绑定。得益于 @mrmacete 的又一项出色贡献,现在已经支持。 例如:

$ frida -p 0
[Local::SystemSession ]-> open = Module.getExportByName(null, 'open')
"0x7f929a325840"
[Local::SystemSession ]-> Interceptor.attach(open, () => {})
{}
[Local::SystemSession ]-> Instruction.parse(open).toString()
"jmp 0x7f928940c408"
[Local::SystemSession ]-> Cloak.hasRangeContaining(ptr('0x7f928940c408'))
true
[Local::SystemSession ]-> pointInsideOpen = open.add(16)
"0x7f929a325850"
[Local::SystemSession ]-> Instruction.parse(pointInsideOpen).toString()
"push rbx"
[Local::SystemSession ]-> Cloak.hasRangeContaining(pointInsideOpen)
false
[Local::SystemSession ]->

快速 Interceptor

一个鲜为人知且较新的功能 Interceptor.replaceFast() 现在也可从 JavaScript 使用。 它的不同之处在于,目标会被修改为直接跳转到替换实现,因此比 Interceptor.replace() 开销更低。这也意味着,如需调用原始实现,必须使用返回的指针;同一目标也不能同时搭配 Interceptor.attach()。不过,如果处理的是高频目标,这绝对是值得收入工具箱的功能, 尤其适合与 CModule 结合使用。

ELF 导出回归

我们很晚才发现 Frida 16.1.0 破坏了部分 ELF 二进制文件上的 Module#enumerateExports(),现在终于修复。问题源于我将 Gum.ElfModule 改造成跨平台 API、为 Barebone 后端等离线场景添加支持时引入的边界检查错误。(在这类场景中,我们 用它将 Rust 代码动态注入操作系统内核和裸机目标。)

ELF 导入槽

在 Apple 平台使用 Frida 的用户可能已经注意到,Module#enumerateImports() 提供的导入 对象始终带有 slot 属性。可以向该地址写入新指针,从而按模块重新绑定导入。当 Interceptor 无法挂钩函数,或希望避免内联 hook 时,这非常实用。

从本版本开始,基于 ELF 的平台也会提供 slot 属性,因此 Linux、Android、FreeBSD 和 QNX 上也能使用此功能。太棒了!

Android 稳定性

新版 Android 的重度用户可能遇到过“软循环”:Frida 随机导致 Zygote 崩溃,使大量用户 空间组件重启。原因是运行时在准备 fork() 时轮询 /proc/self/stat,等待线程数降为一, 也就是等待进程变成单线程。

现在通过扣除 Frida 自身拥有的线程解决了问题;这些线程通过本文前面提到的 Cloak API 在内部确定。我们还使用新的 ELF 导入槽功能,只为 libart.so 中的调用者挂钩 read()。 在 libc.so 的 read() 中插入内联 hook 并不合适,因为所在进程可能用它执行无限阻塞的 读取。卸载时会因此陷入等待,无法获得回滚内联 hook 的机会。

总之,这是一个相当有趣的问题。感谢 @enovella_ 报告并协助定位 🙌

说到 Android,本版本还改进了 Android 14 上的 Java hook;启用 –enable-optimizations 时,系统会使用新的 ART quick 入口点。感谢 @cr4zyserb 提供这项精彩贡献。

更好的 iOS 16 支持

如果你曾在 iOS 上安装 Frida 时遇到 Service cannot load in requested session, 这个问题现在终于修复。感谢 @as0ler 协助修复。

已越狱 tvOS

另一个令人兴奋的进展是现在支持已越狱 tvOS,可直接从我们的仓库获取 .deb: https://build.frida.re/. 特别感谢 @tmm1 提交拉取请求促成此事。

其他

本版本还有更多内容,其余变更如下:

  • symbolutil-libdwarf:修复 DWARF 5 中 DW_AT_ranges 的处理,使 DebugSymbol API 能在新版工具链构建的二进制文件上正常工作。
  • elf-module:修复在线模式下的重定位地址。
  • interceptor:在 arm64 上认领 graft 时检查模块前缀,以兼容 Xcode 在 iOS 17 上新增的 libLogRedirect.dylib interpose。感谢 @mrmacete!
  • interceptor:在 arm64 上隐藏 thunk。感谢 @mrmacete!
  • windows:确保 MSVC source-charset 设为 UTF-8,使嵌入式 JavaScript 能在运行时正确 解析。感谢 @Qfrost911!
  • freebsd:改进近处分配策略。
  • gumjs:修复 QJS 使用 ESM 执行 load() 时的泄漏。
  • objc:确保 implementation setter 中的 block 结构可写。感谢 @mrmacete!
  • compiler:将 @types/frida-gum 升级到 18.6.0。

尽情享用吧!

Frida 16.1.11 发布

这次有许多好东西:

  • stalker:从多个方面提高稳定性。感谢 @as0ler、@hsorbo 和 @mrmacete 参与愉快而富有成效的集体编程,促成了这些精彩改进:
    • stalker:在 arm64 上直接复制被排除调用的 BLR,而不是用功能等价的指令替换, 从而确保任何指针认证上下文都按预期使用。感谢 @mrmacete!
    • stalker:在 arm64 上 allocate_near() 失败时中止,而不是因随后解引用 NULL 指针而崩溃。
    • gumjs:修复在已停止的 sink 上调用 Stalker.flush() 时的崩溃。 如果刚刚调用过 Stalker.garbageCollect(),就会发生这种情况。
    • gumjs:修复 Stalker QuickJS 回调逻辑中的释放后使用问题。如果执行到一半时发生 Stalker.garbageCollect() 并释放回调值,我们需要让这些值继续存活。
  • darwin:改进符号解析器缓存失效逻辑。感谢 @mrmacete!
  • swift-api-resolver:处理已签名指针。
  • linux:改进 spawn(),以处理不完整的链接映射。
  • linux:改进注入器,以处理 XOM 页面。
  • linux:改进注入器的 RTLD API 检测。
  • linux:修复注入器的 ELF SYMTAB 名称解析。
  • node:在 UNIX 上链接 inspector 库,修复调用 Script#enableDebugger() 时的 RTLD panic。 感谢 @pandasauce!
  • ci:发布适用于 Node.js 20 和 Electron 27 的 FreeBSD 预构建版本。

Frida 16.1.10 发布

赶在圣诞节前带来几项精巧的小修复:

  • server:补充 iOS 16 所需的 entitlement,用于在内存中重新映射二进制文件。 感谢 @as0ler!
  • android:修复 Android 14 上由解释器运行的方法的 Java Hook。
  • 修复 frida-server 和 frida-inject 等 CLI 工具中显示的 argv[0]。感谢 @bet4it!

Frida 16.1.9 发布

此版本包含许多改进:

  • interceptor:同时暂停隐藏线程。当 Interceptor Hook 的函数与内部可能使用的函数位于同一页面时,可避免我们自己的线程随机发生 SIGBUS 崩溃。感谢 @mrmacete!
  • darwin:迁移到 POSIX Exceptor 后端。新版 Apple 操作系统对 Mach 异常处理 API 的限制日益严格。
  • darwin:在 arm64 上解析导入跳板,从而可以 Hook sigaction() 等目标。
  • linux:改进 spawn(),处理再次命中 r_brk 的情况。
  • linker:改进 spawn(),查找 RTLD 符号时考虑磁盘上的 ELF,例如可在更多 Android 系统上找到 r_debug。
  • linux:修复 DT_INIT_ARRAY 包含哨兵值时的 spawn()。
  • linux:如果存在 DT_PREINIT_ARRAY,spawn() 会使用它。
  • android:在 RTLD 后备逻辑中处理符号链接。

Frida 16.1.8 发布

这次带来了三项令人兴奋的变更:

  • process:添加 get_main_module(),在 JavaScript 中公开为 Process.mainModule。当需要知道哪个模块代表进程的主可执行文件时,这会很有用。 过去通常通过枚举已加载模块并假定列表中的第一个模块就是主模块来实现。 在最新的 Apple 操作系统上,情况已不再如此,因此我们现在通过这个新 API 提供了一种高效且可移植的解决方案。感谢 @mrmacete!
  • compiler:将 @types/frida-gum 升级到 18.5.0,现在包含近期新增 API 的类型定义。
  • barebone:修复与最新版 Corellium 的兼容性。

Frida 16.1.7 发布

本次带来一些不错的改进:

  • stalker:允许 transformer 在 x86 上跳过 call。感谢 @s1341!
  • objc:容忍经过名称修饰的 Swift 类名。感谢 @hsorbo!
  • cpu-features:改进 AVX2 检测。感谢 @smx-smx 的协助!
  • windows:新增 MinGW 支持。感谢 @smx-smx 的协助!
  • openssl:升级到 openssl-3.0.12+quic@b81f0ae。

Frida 16.1.6 发布

这是一个快速错误修复版本,用于回滚上一版中的两项 Interceptor/Relocator arm64 变更。 事实证明,这些变更在合入前还需进一步打磨,因此我们暂时将它们回滚。

更改日志

  • 回滚“relocator: Improve scratch register strategy on arm64”。
  • 回滚“interceptor: Relocate tiny targets on arm64”。
  • stalker:允许 transformer 在 arm64 上跳过调用。

Frida 16.1.5 发布

自上次发布以来,@hsorbo 和我在众多令人兴奋的技术上进行了非常愉快的结对编程。让我们直接开始。

Swift

我们为 Swift 引入了一个全新的 ApiResolver,可以像这样使用:

const r = new ApiResolver('swift');
r.enumerateMatches('functions:*CoreDevice!*RemoteDevice*')
.forEach(({ name, address }) => {
  console.log('Found:', name, 'at:', address);
});

另外还有一个令人兴奋的新版 frida-tools 12.3.0,它利用新 ApiResolver 为 frida-trace 添加了 Swift 跟踪支持:

$ frida-trace Xcode -y '*CoreDevice!*RemoteDevice*'

模块

我们的 Module API 现在还提供 enumerateSections() 和 enumerateDependencies()。当你希望在已加载模块中扫描特定节名时,现有的 module ApiResolver 现在能让你轻松做到:

const r = new ApiResolver('module');
r.enumerateMatches('sections:*!*text*/i')
.forEach(({ name, address }) => {
  console.log('Found:', name, 'at:', address);
});

结束语

还有许多其他令人兴奋的变更,请务必查看下方的变更日志。

祝使用愉快!

变更日志

  • swift-api-resolver:添加全新的 Swift API Resolver。
  • module-api-resolver:支持解析节。
  • api-resolver:向匹配结果添加可选 size 字段。
  • module:添加 enumerate_sections()。
  • module:添加 enumerate_dependencies()。
  • device:添加 unpair()。目前只为 iOS 设备实现。
  • compiler:将 frida-compile 升级到 16.4.1,将 @types/frida-gum 升级到 18.4.5。
  • gdb:处理空响应数据包。
  • gdb:处理对功能文档请求的错误回复。
  • darwin-mapper:加载时初始化 TLV 描述符。感谢 @fabianfreyer!
  • darwin-module:添加线程局部变量 API。感谢 @fabianfreyer!
  • darwin-module:小幅优化导出项枚举。
  • elf-module:改进节 ID 的生成。
  • x86-writer:添加基于寄存器到寄存器的 {fs,gs} MOV 指令。感谢 @fabianfreyer!
  • arm64-writer:添加 MRS 指令。感谢 @fabianfreyer!
  • arm64-writer:添加 UBFM、LSL 和 LSR 指令。感谢 @fabianfreyer!
  • relocator:改进 arm64 上的临时寄存器策略。
  • interceptor:使用计算出的临时寄存器分支到 trampoline。
  • interceptor:在 arm64 上重定位微小目标。
  • linux:处理被禁用的 process_vm_{read,write}v()。感谢 @Pyraun!
  • server:在无 root iOS 上使用 sysroot 存放临时文件。感谢 @fabianfreyer!
  • gumjs:修复 Interceptor 不存在时 File 和 Database 中的崩溃。感谢 @mrmacete!
  • gumjs:修复 32 位大端系统上从数字构造 NativePointer 的问题(#752)。感谢 @forky2!
  • gumjs:将 frida-swift-bridge 升级到 2.0.7。
  • ci:发布 Node.js 20 和 21 以及 Electron 27 的预构建版本。
  • ci:暂时不发布 Swift 绑定。有一个长期存在的海森堡错误,会导致 x86_64 slice 随机损坏,进而使 CI 发布作业失败。考虑到使用下载的 core devkit 在本地构建这些绑定非常容易,而我短期内也不想在这上面投入时间,因此只是删除该发布资产似乎是最佳方案。

Frida 16.1.4 发布

这次有一些令人兴奋的改进:

  • ios:修复 iOS 17 上的 spawn()。感谢 @hsorbo!
  • ios:添加对 rootless 系统的支持。感谢 @hsorbo 与我结对编程!
  • android:修复动态链接器兼容性回归。感谢 @hsorbo 与我结对编程!也感谢 @getorix 报告。
  • gumjs:添加 Worker API,因此可以将繁重处理移到后台线程,从而及时处理钩子。 目前只在 QuickJS 运行时中实现。感谢 @mrmacete 追查并修复了实现中的最后一批错误。
  • linux:改进尝试附加到即将终止的进程时的错误处理。

Frida 16.1.3 发布

新版本来了,正好赶上周末:

  • server:添加 iOS >= 17 缺失的 entitlement。感谢 @alexhude 帮助查明这个问题。
  • stalker:改进 arm 和 arm64 上的独占存储处理。我们不再可能扩展当前块、使其包含超出该块自然结束位置的指令,而是改用更安全的方法:遇到独占存储后,我们回看先前生成的块,查找其中是否有包含独占加载的块。如果找到,就将这一范围的块标记为使用独占访问。我们还会使这些块失效,以便重新编译时省略有问题的插桩。为了让自定义 transformer 也能调整生成的代码,我们引入了 StalkerIterator.get_memory_access()。感谢 @hsorbo 参与有趣且高效的结对编程!
  • gumjs:添加 StalkerIterator.memoryAccess,允许自定义 transformer 在不干扰独占存储操作的情况下,确定可安全添加何种插桩。其值可设为 ‘open’,表示 callout 等“噪声较大”的插桩是安全的;或设为 ‘exclusive’,表示这类插桩有风险,可能导致无限循环。(这是因为独占存储失败,而后续每次重试也都失败。)
  • gumjs:修复 arm 上 Stalker 的 CModule 绑定。
  • stalker:修复在新增 slab 中执行失效操作时的崩溃。
  • arm64-writer:添加 put_eor_reg_reg_reg()。感谢 @hsorbo 参与有趣且高效的结对编程!

Frida 16.1.2 发布

又到了发布新版本、完善若干细节的时候:

  • darwin:修复 Stalker.follow() 的回归问题,其会粗暴地中断正在进行的系统调用, 通常导致目标崩溃。感谢 @hsorbo 与我结对编程!
  • gumjs:为 QuickJS 实现 WeakRef API。
  • compiler:将 @types/frida-gum 升级到 18.4.0。

Frida 16.1.1 发布

这次只有少量变更:

  • compiler:将 frida-compile 升级到 16.3.0,现在使用 TypeScript 5.1.5,并包含其他改进。其中包括 @hsorbo 提供的一项修复,将默认 moduleResolution 改为 Node16。
  • stalker:添加 Iterator.get_capstone(),使 transformer 可以使用需要 Capstone 句柄的 Capstone API。
  • node:修复 RPC 消息数组检查。感谢 @ZachQin!

Frida 16.1.0 发布

多年来,我一直梦想着让 Frida 超越用户空间软件,把插桩能力扩展到操作系统内核和裸机系统,甚至微控制器……

微控制器

今年早些时候,我家的猫门坏了。与零售商沟通并反复检查安装等问题后,它每次只能正常工作一小会儿,最终还是会再次故障。

这显然让家里的猫很不开心:

cat-door-fail

它们自然会闹出很大动静,而我不得不起床手动放它们进来,也就很难睡个好觉。

最后我又买了一扇猫门,果然再也没出问题。旧猫门吃灰了一阵子,但我一直在想:能不能调试它,甚至扩展它的软件,让它做更多有用的事情。

我越来越想拆开它研究里面的电子元件,最终还是动手了:

cat-door-pcb

看起来这是 STM32F030C6T6,一款基于 ARM Cortex M0 的 MCU。我的第一个念头是能否转储闪存,再做静态分析。

快速浏览 MCU 文档并用万用表做了一番探测后,我弄清了 JP12 焊盘的定义:

PAD 1/2     PAD 7/8
BOOT0 USART1 RX SWDIO GND
VDD USART1 TX   SWCLK

这样就能轻松将 BOOT0 拉高,让 MCU 启动其内部引导程序,而不是用户代码。

将 USB 转 3.3V TTL 设备接到 USART1 焊盘后,我就能转储闪存:

$ ./stm32flash -r firmware.bin /dev/ttyUSB0
stm32flash 0.7

http://stm32flash.sourceforge.net/

Interface serial_posix: 57600 8E1
Version      : 0x31
Option 1     : 0x00
Option 2     : 0x00
Device ID    : 0x0444 (STM32F03xx4/6)
- RAM        : Up to 4KiB  (2048b reserved by bootloader)
- Flash      : Up to 32KiB (size first sector: 4x1024)
- Option bytes  : 16b
- System memory : 3KiB
Memory read
Read address 0x08008000 (100.00%) Done.

然后进行一些静态分析: cat-door-firmware

另外两个焊盘连接到串行线调试(SWD)所用的 SWDIO 和 SWCLK,所以下一步自然是接上 Raspberry Pi Debug Probe。配置完成后,我启动了 OpenOCD:

$ openocd -f interface/cmsis-dap.cfg -f target/stm32f0x.cfg
Open On-Chip Debugger 0.11.0-g8e3c38f7-dirty (2023-05-05-14:25)
Licensed under GNU GPL v2
For bug reports, read
	http://openocd.org/doc/doxygen/bugs.html
Info : auto-selecting first available session transport "swd". To override use 'transport select <transport>'.
Info : Listening on port 6666 for tcl connections
Info : Listening on port 4444 for telnet connections
Info : Using CMSIS-DAPv2 interface with VID:PID=0x2e8a:0x000c, serial=E6614103E78B482F
Info : CMSIS-DAP: SWD  Supported
Info : CMSIS-DAP: FW Version = 2.0.0
Info : CMSIS-DAP: Interface Initialised (SWD)
Info : SWCLK/TCK = 0 SWDIO/TMS = 0 TDI = 0 TDO = 0 nTRST = 0 nRESET = 0
Info : CMSIS-DAP: Interface ready
Info : clock speed 1000 kHz
Info : SWD DPIDR 0x0bb11477
Info : stm32f0x.cpu: hardware has 4 breakpoints, 2 watchpoints
Info : starting gdb server for stm32f0x.cpu on 3333
Info : Listening on port 3333 for gdb connections

我酝酿已久的想法是为 Frida 增加一个新后端,其中唯一可附加的进程是 PID 0。加载到其中的脚本实际上在本地运行,并实现大家熟悉的 JavaScript API。任何访问内存的 API,例如用 ptr(‘0x80000’).readInt() 解引用 int *,最终都会查询目标;在上述场景中就是通过 SWD 完成。

起初我设想让后端通过 telnet 接口与 OpenOCD 守护进程通信,但很快意识到,与其兼容 GDB 的远程桩通信更好。这样,Frida 就能对任何提供远程桩的目标进行插桩,无论是 OpenOCD、Corellium(iOS 内核插桩!)、QEMU,还是其他环境。

至于 Interceptor,我计划用断点实现基础功能,但仅在用户提供 JavaScript 回调时如此。如果提供的是函数指针,则可以执行内联 Hook,使目标运行时无需与主机之间反复触发陷阱和往返通信。这意味着它甚至可用于观察和修改操作系统内核或 MCU 固件中的热点代码。

完成初步实现后,我已经能运行下面的脚本:

Interceptor.breakpointKind = 'hard';

const THUMB_BIT = 1;

const initRest = ptr('0x0800306a').or(THUMB_BIT);
Interceptor.attach(initRest, {
  onEnter(args) {
    console.log('>>> init_rest()',
        JSON.stringify(this.context, null, 2));
  },
  onLeave(retval) {
    console.log(`<<< init_rest() retval=${retval}`);
  }
});

通过 Frida REPL 运行:

$ frida -D barebone -p 0 -l demo.js
     ____
    / _  |   Frida 16.1.0 - A world-class dynamic instrumentation toolkit
   | (_| |
    > _  |   Commands:
   /_/ |_|       help      -> Displays the help system
   . . . .       object?   -> Display information about 'object'
   . . . .       exit/quit -> Exit
   . . . .
   . . . .   More info at https://frida.re/docs/home/
   . . . .
   . . . .   Connected to GDB Remote Stub (id=barebone)

[Remote::SystemSession ]-> $gdb.continue()
[Remote::SystemSession ]-> >>> init_rest() {
  "r7": "0xffffffff",
  "pc": "0x800306a",
  "r8": "0xffffffff",
  "xPSR": "0x41000000",
  "r9": "0xffffffff",
  "sp": "0x20000578",
  "r0": "0x0",
  "r10": "0xffffffff",
  "lr": "0x8003069",
  "r1": "0x40021008",
  "r11": "0xffffffff",
  "r2": "0xffffffff",
  "r12": "0xffffffff",
  "r3": "0xffffffff",
  "r4": "0xffffffff",
  "r5": "0xffffffff",
  "r6": "0xffffffff"
}
<<< init_rest() retval=0x1

这里有几点需要注意:

  • 我们将 Interceptor.breakpointKind 设为 hard,因为目标代码位于闪存中,软件断点无法工作。如果使用 J-Link 或类似 SWD 接口,则不必这样做;它们会在添加软件断点时透明地重新刷写闪存。
  • 后端尚不会自动恢复运行,因此我们通过 $gdb.continue() 手动恢复。它属于这个内部 API,将 GDB.Client 的大部分能力暴露给 JavaScript。随着新后端逐渐成熟,这会成为内部实现细节;目前不应把它视为稳定 API。
  • 我们设置最低有效位,告诉 Interceptor 目标函数采用 Thumb 指令编码。若你曾在 32 位 ARM 上使用 Frida 的传统后端,应该已经熟悉这一点。
  • 新的 Barebone 后端默认连接 127.0.0.1:3333 上兼容 GDB 的远程桩,这与 OpenOCD 的常见默认值一致;也可通过 FRIDA_BAREBONE_ADDRESS 环境变量覆盖。

操作系统内核

有趣的猫门支线任务很适合测试规模较小的一端,但支持更大型系统同样潜力巨大。

其中最酷的用例之一无疑是 Corellium,因为这意味着我们可以对 iOS 内核插桩。借助 Tamarin Cable,甚至应该能在可利用 checkm8 的实体设备上实现。

不过在讨论它之前,先看看能否在 QEMU 和运行中的 Linux 内核上把功能跑起来。

Linux

首先启动一台可供实验的虚拟机:

$ pip install arm_now
$ arm_now start aarch64 --add-qemu-options='-gdb tcp::9000'
...
Welcome to arm_now
buildroot login:

接着用 Frida REPL 四处查看:

$ export FRIDA_BAREBONE_ADDRESS=127.0.0.1:9000
$ frida -D barebone -p 0
     ____
    / _  |   Frida 16.1.0 - A world-class dynamic instrumentation toolkit
   | (_| |
    > _  |   Commands:
   /_/ |_|       help      -> Displays the help system
   . . . .       object?   -> Display information about 'object'
   . . . .       exit/quit -> Exit
   . . . .
   . . . .   More info at https://frida.re/docs/home/
   . . . .
   . . . .   Connected to GDB Remote Stub (id=barebone)

[Remote::SystemSession ]-> Process.arch
"arm64"
[Remote::SystemSession ]-> Process.enumerateRanges('r-x')
[
    {
        "base": "0xffffff8008080000",
        "protection": "r-x",
        "size": 4259840
    }
]
[Remote::SystemSession ]-> $gdb.state
"stopped"
[Remote::SystemSession ]-> $gdb.exception
{
    "breakpoint": null,
    "signum": 2,
    "thread": {}
}
[Remote::SystemSession ]-> $gdb.exception.thread.readRegisters()
{
    "cpsr": 1610613189,
    "pc": "0xffffff8008096648",
    "sp": "0xffffff80085f3f10",
    "x0": "0x0",
    "x1": "0xffffff80085e6b78",
    "x10": "0x880",
    "x11": "0xffffffc00e877180",
    "x12": "0x0",
    "x13": "0xffffffc00ffe1f30",
    "x14": "0x0",
    "x15": "0xfffffff8",
    "x16": "0xffffffbeff000000",
    "x17": "0x0",
    "x18": "0xffffffc00ffe17e0",
    "x19": "0xffffff80085e0000",
    "x2": "0x40079f5000",
    "x20": "0xffffff80085f892c",
    "x21": "0xffffff80085f88a0",
    "x22": "0xffffff80085ffe80",
    "x23": "0xffffff80085ffe80",
    "x24": "0xffffff80085d5028",
    "x25": "0x0",
    "x26": "0x0",
    "x27": "0x0",
    "x28": "0x405a0018",
    "x29": "0xffffff80085f3f10",
    "x3": "0x30c",
    "x30": "0xffffff800808492c",
    "x4": "0x0",
    "x5": "0x40079f5000",
    "x6": "0x1",
    "x7": "0x1c0",
    "x8": "0x2",
    "x9": "0xffffff80085f3e80"
}
[Remote::SystemSession ]->

你可能想知道我们如何实现 Process.enumerateRanges()。目前这部分仅在 arm64 上实现,方式是解析页表。(如果连接 Corellium 的远程桩,我们会使用厂商特定的 monitor 命令,从而省去大量网络往返。)

既然已经能窥探运行中的内核,我们可能会想查找内部函数和数据结构。这正是内存扫描 API 的用武之地:

for (const r of Process.enumerateRanges('r-x')) {
  console.log(JSON.stringify(r, null, 2));
  const matches = Memory.scanSync(r.base, r.size,
      '7b2000f0 fa03082a 992480d2 : 1f00009f ffffffff 1f00e0ff');
  console.log('Matches:', JSON.stringify(matches, null, 2));
}

这里通过匹配前三条指令来寻找 Linux 内核的 arm64 系统调用处理程序。我们使用掩码功能忽略 ADRP 和 MOV 指令(第一条和第三条指令)的立即数。

来实际运行一下:

$ frida -D barebone -p 0 -l scan.js
     ____
    / _  |   Frida 16.1.0 - A world-class dynamic instrumentation toolkit
   | (_| |
    > _  |   Commands:
   /_/ |_|       help      -> Displays the help system
   . . . .       object?   -> Display information about 'object'
   . . . .       exit/quit -> Exit
   . . . .
   . . . .   More info at https://frida.re/docs/home/
   . . . .
   . . . .   Connected to GDB Remote Stub (id=barebone)
Attaching...
{
  "base": "0xffffff8008080000",
  "size": 4259840,
  "protection": "r-x"
}
Matches: [
  {
    "address": "0xffffff8008082f00",
    "size": 12
  }
]
[Remote::SystemSession ]->

现在我们已经动态检测到了内核内部的系统调用处理程序!🚀

重新实现内存扫描是我个人最喜欢的部分之一,@hsorbo 和我通过结对编程完成它,过程非常愉快。其思路与我们面向未越狱 iOS 的 Fruity 后端以及新的 Linux 注入器非常相似:无需把数据传回主机再搜索,只需传输搜索算法,让它在目标上运行。

内存扫描器实现使用 Rust 编写,也为本文稍后介绍的一项新功能奠定了基础。

现在知道 Linux 内核系统调用处理程序的位置后,就能用 Interceptor 安装指令级 Hook:

const el0Svc = ptr('0xffffff8008082f00');
Interceptor.attach(el0Svc, function (args) {
  const { context } = this;
  const scno = context.x8.toUInt32();
  console.log(`syscall! scno=${scno}`);
});

在运行中的虚拟机上试一试:

$ frida -D barebone -p 0 -l kernhook.js
     ____
    / _  |   Frida 16.1.0 - A world-class dynamic instrumentation toolkit
   | (_| |
    > _  |   Commands:
   /_/ |_|       help      -> Displays the help system
   . . . .       object?   -> Display information about 'object'
   . . . .       exit/quit -> Exit
   . . . .
   . . . .   More info at https://frida.re/docs/home/
   . . . .
   . . . .   Connected to GDB Remote Stub (id=barebone)

[Remote::SystemSession ]-> $gdb.continue()
[Remote::SystemSession ]-> syscall! scno=63
syscall! scno=64
syscall! scno=73
syscall! scno=63
syscall! scno=64
syscall! scno=73
syscall! scno=63
syscall! scno=64
syscall! scno=56
syscall! scno=62
syscall! scno=64
syscall! scno=57
syscall! scno=29
syscall! scno=134
...

就是这样——我们正在监控整个系统的系统调用!💥

Rust

尝试上面的示例时,你首先可能会注意到系统明显变慢。这是因为指定 JavaScript 函数作为回调时,Interceptor 会使用断点。

不过无需担心。如果用机器码编写回调并传入 NativePointer,Interceptor 会采用另一种策略:修改目标机器码,将执行流重定向到跳板,再由跳板调用我们指定地址处的函数。

这样很好,我们只需把机器码放进内存。有些人可能熟悉 CModule API。新的 Barebone 后端尚未实现它(最终会实现!),但我们有更棒的方案:RustModule:

const kernBase = ptr('0xffffff8008080000');
const procPidStatus = kernBase.add(0x15e600);

const m = new RustModule(`
#[no_mangle]
pub unsafe extern "C" fn hook(ic: &mut gum::InvocationContext) -> () {
    let regs = &mut ic.cpu_context;
    println!("proc_pid_status() was called with x0={:#x} x1={:#x}",
        regs.x[0],
        regs.x[1],
    );
}
`);

Interceptor.attach(procPidStatus, m.hook);

RustModule 使用假定已位于 PATH 中的本地 Rust 工具链,把提供的代码编译成自包含的 no_std ELF。它会重定位 ELF 并写入目标内存,同时解析 MMU 页表并插入新条目,使上传的代码成为虚拟地址空间的一部分,相关页面具有读、写、执行权限。

本例会在运行中的 Linux 内核里 Hook proc_pid_status()。

注意,可使用 File.readAllText(),避免在 JavaScript 中内联 Rust 代码。这里为了简洁采用内联代码。

现在来运行这个由 Rust 驱动的 Agent:

$ frida -D barebone -p 0 -l kernhook2.js
     ____
    / _  |   Frida 16.1.0 - A world-class dynamic instrumentation toolkit
   | (_| |
    > _  |   Commands:
   /_/ |_|       help      -> Displays the help system
   . . . .       object?   -> Display information about 'object'
   . . . .       exit/quit -> Exit
   . . . .
   . . . .   More info at https://frida.re/docs/home/
   . . . .
   . . . .   Connected to GDB Remote Stub (id=barebone)

Error: to enable this feature, set FRIDA_BAREBONE_HEAP_BASE to the physical base address to use, e.g. 0x48000000
    at <eval> (/home/oleavr/src/demo/kernhook2.js:13)
    at evaluate (native)
    at <anonymous> (/frida/repl-2.js:1)

[Remote::SystemSession ]->

糟糕!还没成功。新后端仍缺少一块拼图:我们还没有“内核桥接器”来自动识别已知内核的内部结构,以找到可用的合适内存分配器。实现 Process.enumerateModules() 等 API 也需要它,这样才能列出已加载的内核模块或 kext。我们还可以定位内核进程列表并实现 enumerate_processes(),让 frida-ps 工作。这些只是少数例子……还可以把 frida-gadget 注入用户空间进程;对于不想修改闪存的嵌入式系统,这会非常有用。话题扯远了 😊

因此,在 MCU 和未知内核上,如果要使用 RustModule、Interceptor 内联 Hook 模式、Memory.alloc() 等侵入式功能,就必须告诉 Frida 哪一段物理内存可以覆盖使用。

了解这一点后,再次尝试示例;这次设置 FRIDA_BAREBONE_HEAP_BASE 环境变量:

$ export FRIDA_BAREBONE_HEAP_BASE=0x48000000
$ frida -D barebone -p 0 -l kernhook2.js
     ____
    / _  |   Frida 16.1.0 - A world-class dynamic instrumentation toolkit
   | (_| |
    > _  |   Commands:
   /_/ |_|       help      -> Displays the help system
   . . . .       object?   -> Display information about 'object'
   . . . .       exit/quit -> Exit
   . . . .
   . . . .   More info at https://frida.re/docs/home/
   . . . .
   . . . .   Connected to GDB Remote Stub (id=barebone)

[Remote::SystemSession ]-> m
{
    "hook": "0xffffff80080103e0"
}
[Remote::SystemSession ]-> $gdb.continue()

成功了!🎉 现在在运行 QEMU 的终端中访问三次 /proc/$pid/status,让被 Hook 的函数得到调用:

# head -3 /proc/self/status
Name:	head
Umask:	0022
State:	R (running)
# head -3 /proc/self/status
Name:	head
Umask:	0022
State:	R (running)
# head -3 /proc/self/status
Name:	head
Umask:	0022
State:	R (running)

回到 REPL,应该能看到 hook() 被命中三次:

proc_pid_status() was called with x0=0xffffffc00d4bca00 x1=0xffffff8008608758
proc_pid_status() was called with x0=0xffffffc00d4bc780 x1=0xffffff8008608758

成功了!🥳

不过有一点很重要:示例使用了 println!(),它实际上会让目标命中断点,以便主机读出传递的消息,并像 JavaScript 的 console.log() 一样向上传递。因此这个功能只应临时用于调试;若处在热点代码路径上,还应限制调用频率。

接下来你可能想把外部符号传入 RustModule,例如从 Rust 代码调用内核内部函数。可按下面的方式声明:

extern "C" {
    fn frobnicate(data: *const u8, len: usize);
}

然后在构造 RustModule 时通过第二个参数传入:

const m = new RustModule(source, {
  frobnicate: ptr('0xffffff8008084320'),
});

熟悉 CModule API 的读者会发现,这部分完全相同。还可使用 NativeCallback 在主机端用 JavaScript 实现部分逻辑,但需要谨慎处理,以免形成性能瓶颈。反过来,也可使用 NativeFunction 从 JavaScript 调用 Rust 代码。

最后,你可能还想从 crates.io 导入现有 Rust crate。这同样受支持:

const m = new RustModule(source, {}, {
  dependencies: [
    'cstr_core = { version = "0.2.6", default-features = false }',
  ]
});

Corellium

令人兴奋的是,上述所有 Linux 功能在 Corellium 上也能直接工作。只需将 FRIDA_BAREBONE_ADDRESS 指向 Corellium 界面中“Advanced Options”→“gdb”显示的端点。

感谢 Corellium 团队在此过程中的支持。他们甚至实现了新的协议功能来提升互操作性 🔥

未来

目前这个新后端仍应视为 alpha 质量,但它已经能完成许多有用的事情,继续让它留在分支里实在可惜。

你可能会注意到,目前实现的 JS API 只是一个子集,而且非 arm64 目标还不能使用所有功能。随着后端成熟,这些都会逐步改善。(非常欢迎提交 Pull Request!)

再分享一个有趣的例子:这是 Frida 附加到 BeOS 内核的画面:

beos-kernel

结语

此外还有许多令人兴奋的变化,请务必查看下面的变更日志。

尽情体验吧!

变更日志

  • 新增 Barebone 后端。(上文已详细介绍。)
  • objc:处理修饰符,使类型解析更可靠,特别是在处理经常带有“atomic”修饰符的 ivar 时;此前修饰符会被视为未知类型并抛出异常。感谢 @mrmacete!
  • android:修复 Android 14 支持。感谢 @gsingh93!也感谢 @jayluxferro 修复我合并 @gsingh93 的 PR 时犯下的错误。
  • gum-graft:新增链式导入支持。感谢 @mrmacete!
  • gumjs:新增 NativePointer#readVolatile(),可安全读取可能在途中被取消映射或改变内存保护的内存。感谢 @hsorbo!
  • darwin:改进 tvOS 支持,使其覆盖 frida-server。感谢 @tmm1!
  • darwin:修复后备 kill() 逻辑中的内存泄漏。感谢 @tmm1!
  • fruity:处理获取 dyld 符号失败的情况。
  • compiler:将 frida-compile 升级到 16.2.2;现在也会打包依赖项的 source map。感谢 @vfsfitvnm!
  • compiler:将 @types/frida-gum 升级到 18.3.2,并改进 hexdump() 的类型定义。
  • gdb:从 Fruity 的 LLDB.Client 中提取核心实现,新增 GDB.Client,并加入多项协议增强和互操作性修复。
  • elf-module:改进 API 并实现跨平台;支持从 blob 加载、公开重定位信息,并提升整体稳健性。
  • capstone:修复使用 MSVC 构建时 x86 上的崩溃。

Frida 16.0.19 发布

这次带来了一些令人兴奋的稳定性改进:

  • darwin:让 spawn() 感知 iOS >= 15 使用的 prewarm 功能。具体情况是, dasd 会提前启动最常用的应用,并将其保持在暂停状态,直到用户尝试启动, 以节省一些启动时间。这会妨碍 Frida 的 spawn 机制,因为:
    • 以这种方式启动的应用不会在预期时间经过 launchd,导致“timeout was reached”错误, 或更复杂的竞态条件
    • Frida 需要启动全新进程,以确保能够进行早期插桩

    我们通过以下方式解决这些问题:

    • 忽略 launchd agent 中的 prewarm spawn(但如果启用了 spawn gating,它们仍会作为 spawn 发出)
    • 尝试启动应用前,先终止已存在的预热应用 感谢 @mrmacete!
  • glib:确保 {Input,Output}Stream 仅在可轮询时才调用 g_poll()。这对 Apple 操作系统和 BSD 至关重要,因为 GLib 在这些系统上使用 kqueue 实现 GMainContext;否则,当文件描述符代表普通文件时, 它可能永远等待下去。感谢 @hsorbo!
  • android:通过改进 libffi 以避免有问题的重定位,修复 x86 devkit。
  • gadget:修复 Windows 进程终止期间的死锁。感谢 @Palacee-hun 报告!

Frida 16.0.18 发布

这是一次快速的错误修复版本,恢复了对带 ARM 模拟的 Android x86/x86_64 系统的支持。这仍是 CI 的盲区,而我在开发新的 Linux 注入器时把它完全忘了。感谢 @stopmosk 迅速报告并协助分析这项回归。

Frida 16.0.17 发布

是时候发布一个只包含一项改动的错误修复版本了:事实证明,16.0.14 中引入的 ARMv8 BTI 互操作在 Apple A12+ SoC 上以 arm64e 模式运行时会出现问题, 也就是启用指针认证时。

感谢 @miticollo 报告问题并协助分析原因,也感谢 @mrmacete 进一步深入研究、 集思广益寻找可能的解决方案,并实现了这项修复。你们太棒了!❤️

Frida 16.0.16 发布

鉴于 TypeScript 5.0 已于上个月发布,而 frida.Compiler 仍停留在 4.9,我们认为 是时候升级了。因此,此版本开始提供 5.0.4。此次升级还暴露了基于 V8 的运行时中的 几个错误,以及嵌入式 frida-gum 类型定义略显陈旧的问题。

祝你使用愉快!

变更日志

  • gumjs:修复 V8 Isolate 清理期间的任务死锁。
  • gumjs:修复创建 V8 snapshot 期间的未定义行为。
  • compiler:升级 frida-compile。
  • compiler:使用正确的 @types/frida-gum。

Frida 16.0.15 发布

这个版本修复了影响 Apple 平台用户的两个稳定性问题:

  • interceptor:在 Darwin 上暂停与恢复之间保持线程端口存活。我们借用了 enumerate_threads() 返回的 Mach 线程端口权限名称,并假设存在另一个引用让每个端口保持存活。当事实并非如此时,最好的情况是把无效的 Mach 端口权限名称传给 thread_resume(),最坏的情况则是使用一个完全无关的端口。无论如何,我们都会让这些线程永久保持暂停。感谢 @mrmacete!
  • agent:在独立事务中释放 ThreadSuspendMonitor。由于 Interceptor 依赖 ThreadSuspendMonitor 直通,在独立事务中、并且在销毁时使用 Interceptor 的所有其他组件之后释放它,可以确保没有 Frida 线程会在销毁阶段尝试执行不可执行页面上的代码。感谢 @mrmacete!

Frida 16.0.14 发布

更多令人兴奋的错误修复:

  • linux:修复 ProcMapsEntry 主/次设备号的解析。感谢 @chouex!
  • interceptor:修复 ARMv8 BTI 互操作性。感谢 @zjw88282740!
  • arm64-writer:添加 put_ret_reg()。感谢 @zjw88282740!
  • compiler:修复某些 Linux 系统(例如 Ubuntu 20.04)上的文件系统访问。感谢 @pancake 报告并协助定位此问题!

Frida 16.0.13 发布

这次只有几项错误修复:

  • android:修复旧系统上的动态链接器探测。
  • android:将优雅注入限制在 arm 和 arm64。
  • linux:修复 x86 和 x86_64 上的系统调用等待逻辑。

Frida 16.0.12 发布

这次带来了许多好东西,其中之一便是全新的 Linux 注入器。 开发过程非常有趣,尤其是其中包含了大量与 @hsorbo 的结对编程。

我们对它相当兴奋。Frida 现在支持注入 Linux 容器,例如 Flatpak 应用。 不仅如此,它终于还能把代码注入没有动态链接器的进程。

另一项很棒的改进是,如果你在 Linux >= 3.17 上运行 Frida,可能会注意到 它不再写出任何临时文件。这是通过 memfd 和重新设计的注入器信号机制实现的。

新的 Linux 注入器采用完全异步的设计,没有任何可能导致死锁的危险阻塞操作。 它也是第一个支持为注入载荷提供控制通道的注入器。

未来我们计划在其他后端中也实现这一能力,并使其成为跨平台 Injector API 的一部分。这样做是为了让自定义载荷更容易实现。

这个版本还包含许多其他好东西,务必查看下面的变更日志。

祝你使用愉快!

变更日志

  • linux:重新设计注入器。感谢 @hsorbo 富有成效的结对编程!
  • linux:修复基于 libc 的模块枚举。
  • linux:修复 musl 上的 query_libc_name()。
  • linux:修复 musl 上的模块句柄解析器逻辑。
  • linux:修复 musl 上的 Module.ensure_initialized()。
  • darwin:如果 ThreadSuspendMonitor 由 Frida 调用,则使其直接放行, 以避免死锁场景。感谢 @mrmacete!
  • darwin:在 spawn() 期间始终为管道 stdio 使用 PTY,并启用 close-on-exec。
  • windows:如果已有 DbgHelp 实例,则使用它。感谢 @fesily!
  • windows:实现 Module.enumerate_symbols()。感谢 @fesily!
  • process:在 enumerate_modules() 中跳过被隐藏的模块。
  • cloak:添加 has_range_containing()。
  • elf-module:用 get_interpreter() 替换 has_interp()。
  • gumjs:修复运行时序列化的无符号编码。
  • objc:为方法添加 symbol 属性,使方法对象能够以人类可读的方式完整描述自身。 感谢 @mrmacete!
  • java:用符号作为唯一属性名。感谢 @yotamN!
  • java:为重载添加 toString() 方法。感谢 @oriori1703!
  • java:为类型和字段添加 toString() 方法。感谢 @yotamN!
  • java:修复重载方法的 toString()。感谢 @yotamN!
  • server:支持作为共享库加载。感谢 @Yannayli!

Frida 16.0.11 发布

这次只有几项错误修复:

  • darwin:修复在非 RWX 系统上暂停线程时的死锁。感谢 @mrmacete!
  • darwin:修复映射零大小的段。感谢 @comex!
  • linux:改进 Gum,以支持没有运行时链接器的程序。
  • linux:修复 Gum.Linux API 的错误传播。

Frida 16.0.10 发布

这次我们带来了更多 iOS 15 改进、更出色的 frida.Compiler、全新的 musl libc 支持等内容。 请查看下面的变更日志了解更多详情。

尽情享用吧!

变更日志

  • ios:修复较低版本 iOS 15 上的 spawn()。感谢 @as0ler 和 @mrmacete!
  • ios:确保 launchd 优先运行我们的守护进程。感谢 @getorix 调查并提出此修复方案。
  • compiler:升级 frida-compile、frida-fs 和 Gum 类型定义。这意味着 frida.Compiler 现在也能在 linux-arm64 和 linux-x86 上正常工作。
  • linux:添加对 musl libc 的支持,包括发布 x86_64 和 arm64 发行资源的 CI。
  • gumjs:添加 console.debug() 和 console.info()。感谢 @oriori1703!
  • gumjs:修复上级目录存在 node_modules/@types 时的构建。
  • gumjs:生成运行时时忽略 tcclib.h 符号。感谢 @milahu!
  • build:改进对共享构建的支持。感谢 @milahu!

Frida 16.0.9 发布

此版本的主题是改进对越狱 iOS 的支持。我们现在支持 iOS 16.3,包括应用列举和 启动。此版本还改进了对 iOS 15 的支持,并修复了一些影响旧版 iOS 的回归问题。

此版本还包含其他一些好东西,务必查看下面的变更日志。

祝你使用愉快!

变更日志

  • darwin:修复 iOS >= 16 上的应用列举和启动。感谢 @hsorbo 富有成效的结对编程!
  • darwin:修复对现代 dyld 进行早期插桩时的崩溃。
  • darwin:修复早期插桩中的断点冲突;这是 16.0.8 为提升 spawn() 性能而引入的 回归问题。感谢 @mrmacete!
  • package-server-ios:强制使用 xz 压缩。
  • darwin-grafter:在需要时创建多个段。感谢 @mrmacete!
  • interceptor:激活 Darwin grafted import 时切换页面保护。 感谢 @mrmacete!
  • stalker:修复对不带回写的 ARM LDMIA 的处理。
  • darwin:添加 query_protection()。感谢 @mrmacete!
  • darwin:避免在加固进程中探测内核任务端口。感谢 @as0ler!
  • darwin:修复 Process.modify_thread() 的可靠性。
  • darwin:修复启用 tweak 时 iOS 上的 query_hardened()。感谢 @as0ler!
  • darwin:降低 Process.modify_thread() 的干扰。
  • darwin:优化 Process.modify_thread()。
  • darwin:添加 modify_thread()。
  • arm-writer:添加 put_ldmia_reg_mask_wb()。
  • gumjs:修复运行时序列化不处理 Unicode 的问题。感谢 @milahu!
  • python:为 RPC 调用添加异步变体。感谢 @yotamN!
  • python:为 core 添加具体的信号类型提示。感谢 @yotamN!

Frida 16.0.8 发布

这次我们专注于打磨 macOS 和 iOS 支持。对于使用 spawn() 和 spawn-gating 进行早期插桩的读者,现在的情况已经好得多。

i/macOS spawn() 性能

此版本最令人兴奋的变化全部围绕性能。以前通过 Frida 启动时需要较长时间才能开始的程序, 现在应当能更快启动。这个长期瓶颈曾非常严重:库很多的应用可能因为 Frida 大幅拖慢启动 而无法成功运行。

i/macOS 与 SIGPIPE

接下来是一项针对长期可靠性问题的修复。原来我们用于 IPC 的文件描述符没有设置 SO_NOSIGPIPE, 因此有时 Frida 或目标进程中的一方会突然终止,另一方在尝试 write() 时就会被 SIGPIPE 击中。

沙箱环境,第二部分

上一个版本引入了一些大胆的新变化,以支持注入加固目标。此后,@hsorbo 和我 重新深入检查了最近的 GLib kqueue() 补丁,并修复了一些粗糙之处。我们还修复了一项回归: 通过 usbmuxd 附加到加固进程会因“connection closed”而失败。

Linux

在 Linux 和 Android 端,一些读者可能注意到线程枚举会随机失败,尤其是在繁忙的进程内。 这个问题现在终于解决了。

此外,感谢 @drosseau,我们还改进了错误处理,应当能避免在 32/64 位跨架构构建失败时引起一些困惑。

文末

这次就是这些。尽情享用!

Frida 16.0.7 发布

这是忙碌的一周。一起来看看。

沙箱环境

本周,@hsorbo 和我花了几天时间改进 Frida 在沙箱环境中的运行。目标是让 Frida 进入 iOS 上 Apple 的 SpringBoard 进程。不过为了增加一点挑战,我们决定先从处理 iMessage 协议的守护进程 imagent 入手。新版操作系统对它进行了大量加固,Frida 已无法附加。

为了方便调试,我们先研究 macOS 上的这个守护进程。找到其沙箱配置 /System/Library/Sandbox/Profiles/com.apple.imagent.sb 后,系统调用策略非常醒目:默认禁止全部系统调用,再谨慎启用若干组以及个别必需调用。

随后发现,第一个障碍是 Frida 使用了 pipe() 系统调用。这段代码并不在 Frida 本身,而是在 GLib 中;Frida 使用这个优秀的库提供数据结构、跨平台线程原语、事件循环等。GLib 用 pipe() 实现事件循环所需的原语,更准确地说,用它唤醒阻塞在 poll() 类系统调用中的事件循环线程。

我们注意到 kqueue() 属于明确允许的系统调用组。Apple 的 kqueue() 可同时轮询文件描述符和 Mach 端口等对象,许多地方都可能需要它,因此大量沙箱配置会允许它。它也非常适合我们:EVFILT_USER 提供了唤醒事件循环线程的方法,而且一个文件描述符也不占用。

经过大量咖啡和愉快的结对编程,我们完成了一个补丁,在支持的操作系统上把 GLib 事件循环切换到 kqueue()。接下来的障碍是 Frida 使用 socket API 传递文件描述符,这是用于对当前进程子进程插桩的 child-gating 功能的一部分。不过,加固的系统服务通常不允许 fork() 和 execve() 等操作,因此可以安全地让这部分功能降级。随后我们也解决了它,于是 Frida 终于能附加到 imagent。🎉

接着转到 iOS 进行测试。令我们惊喜的是,Frida 一开始就能附加到 SpringBoard。之后尝试 notifyd 和 profiled,也都成功,甚至在最新版 iOS 16 上也一样。不过仍有工作要做:Frida 尚无法在 iOS 上附加到 imagent 和 WebContent。尽管如此,这仍是令人兴奋的进展。

iOS >= 15 上的注入

在此过程中,我们还定位到 iOS 上的一个崩溃:在 iOS >= 15 上注入期间,frida-server 会因 EXC_GUARD 被终止。该问题也及时在发布前得到修复!

DebugSymbol API

另一项好消息是 @mrmacete 改进了 DebugSymbol API,使其始终提供完整路径,而非仅文件名。这解决了各平台后端长期存在的不一致。他还公开了 column,因此除行号外也能获得列号。

更快的 Interceptor.replace()

最后还要介绍 Interceptor 的一项新改进。对从 C 使用它的用户,现在新增 replace_fast() 作为 replace() 的补充。这个快速变体会生成直接跳转到替换函数的内联 Hook。仍可调用原函数,但必须通过 Interceptor 以可选输出参数提供的函数指针调用;它也不能与同一目标上的 attach() 组合使用。不过速度快得多,需要 Hook 热点代码路径中的函数时值得留意。

结语

本次内容就是这些。尽情体验吧!

变更日志

  • darwin:在加固进程中禁用高级功能。
  • darwin:将 GLib 的 MainContext 移植为使用 kqueue() 而不是 poll()。
  • darwin:修复 iOS >= 15 注入期间的 EXC_GUARD。
  • package-server-ios:将 launchd plist 移植到 iOS 16。
  • gadget:加载期间不隐藏主线程。
  • debug-symbol:确保路径为绝对路径并新增 column 字段。感谢 @mrmacete!
  • darwin:新增 query_hardened()。
  • interceptor:新增 replace_fast()。
  • interceptor:减少每个目标的内存用量。

Frida 16.0.6 发布

事实证明,Frida 16.0.3 中混入了一项严重的稳定性回归:Apple 操作系统使用的进程外动态链接器可能最终导致目标进程崩溃。目标进程是 launchd 时尤其灾难性,因为这会引发内核恐慌。得益于 @mrmacete 的出色工作,这项令人尴尬的回归现已修复。🎉 祝使用愉快!

Frida 16.0.5 发布

这次是一个快速错误修复版本:针对 Android system_server 插桩所作的调整现在应该能在所有系统上可靠运行。

Frida 16.0.4 发布

赶在周末前,全新版本发布了!🎉 这次包含几项关键的稳定性修复。

尽情使用吧!

变更日志

  • gumjs:修复 V8 JobState 逻辑中的释放后使用。感谢 @pancake 报告并协助追踪此问题!
  • android:修复存在竞态的 Zygote 和 system_server 插桩。感谢 @hsorbo 与我进行愉快且高效的结对编程!
  • submodules:添加 frida-go。感谢 @lateralusd!

Frida 16.0.3 发布

这次有一些很酷的新功能。直接进入正题吧。

tvOS 和 watchOS

本次令人兴奋的贡献之一来自 @tmm1,他提交了大量 pull request,为 tvOS 添加支持。太棒了!在合并这些改动时,我也借此机会添加了 watchOS 支持。

这也是简化构建系统的绝佳时机,我们移除了为支持 autotools 等非 Meson 构建系统而引入的复杂性。作为这次清理的一部分,现在针对 iOS Simulator、tvOS Simulator 等模拟器目标提供独立二进制文件。此前只支持 x86_64 iOS Simulator,现在 arm64 也已覆盖。

macOS 13 和 iOS 16

本周早些时候,@hsorbo 和我进行了一次愉快且高效的结对编程,着手处理 Apple 最新操作系统中的动态链接器变更。在 i/macOS 上使用 Frida 的用户可能已经注意到,spawn() 在 macOS 13 和 iOS 16 上无法工作了。

这个问题很有意思。事实证明,文件系统中的 dyld 二进制文件现在会在 dyld_shared_cache 中查找 UUID 与自身相同的 dyld;如果找到,就会把执行流转到那里。不过,要解释这为什么会破坏 Frida 的 spawn() 功能,还需要一点背景,请耐心听我说。

调用 attach() 时,如果 Frida 尚未注入 agent,它所做的工作之一就是注入 agent。但在执行注入前,我们会检查进程是否已充分初始化,也就是 libSystem 是否已经初始化。

如果尚未初始化,例如在 spawn() 之后目标停在 dyld 入口点时,Frida 基本上会推进主线程执行,直至到达 libSystem 已就绪的位置。这通常通过硬件断点完成。

由于新版 dyld 会链接到 dyld_shared_cache 中自身的另一个副本,Frida 此前把断点设置在从文件系统映射进来的版本中,而不是缓存中的版本。显然,这个断点永远不会命中,因此我们最终会在等待它发生时超时。

不过,修复相当直接,因此我们赶在最后一刻把它纳入了这个版本。

编译器改进

frida.Compiler 刚刚获得大幅改进,现在支持通过 tsconfig.json 进行更多配置,也支持使用本地 frida-gum 类型定义。

V8 调试器

改为每个脚本使用一个 V8 Isolate 后,V8 调试器集成失效了;这是一项为支持 V8 快照而必须进行的精细重构。现在该功能已恢复正常。

依赖项升级

本次工作量较大的部分显然是依赖项升级。目前,我们的大多数依赖项均已升级,例如从支持 ARMv9.2 的 Capstone 到使用 PCRE2 的最新版 GLib,等等。

迁移到 PCRE2 意味着 Memory.scan() 的正则表达式支持也随之升级,因为 GLib 此前使用的是 PCRE1。不过,我们目前还没有在任何平台上启用 PCRE2 的 JIT;以后要改进这一点并不困难。

交叉发布:frida-tools 12.0.2

我们还发布了全新的 frida-tools 版本。感谢 @tmm1,其中包含一项令人兴奋的新功能。frida-ls-devices 工具现在会显示信息更丰富的设备名称,并在第四列显示操作系统名称和版本:

frida-ls-devices

升级方式:

$ pip3 install -U frida frida-tools

EOF

这个版本还包含其他一些好东西,建议查看下方的变更日志。

尽情使用吧!

变更日志

  • darwin:添加 watchOS 和 tvOS 支持。感谢 @tmm1!
  • darwin:修复 macOS 13 和 iOS 16 上的早期插桩。(感谢 @hsorbo 与我结对完成这个问题!)
  • interceptor:在 iOS 等 W^X 系统上修改页面时暂停线程。这提高了对繁忙进程进行插桩时的稳定性。
  • system-session:暂时重新启用 Exceptor。
  • compiler:允许配置 target、lib 和 strict。
  • compiler:修复对本地 frida-gum 类型定义的支持。
  • compiler:使用 git 中最新的 @types/frida-gum。
  • ci:停止为 Node.js 10 提供预构建版本。
  • ci:发布 Node.js 19 的预构建版本。
  • ci:发布 Electron 21 而非 20 的预构建版本。
  • unw-backtracer:提高 32 位 ARM 上的准确性。
  • thread:向 Gum C API 添加 suspend() 和 resume()。
  • darwin:改进 chained fixup 的处理。
  • darwin:修复 arm64e 上的 Objective-C 符号合成。
  • linux:检测 Linux 上的 noxsave。
  • linux:改进注入器以处理伪 .so 映射。感谢 @lx866!
  • module-map:支持查找带有 ptrauth 位的地址。
  • gumjs:添加 NativeFunction traps: ‘none’ 选项。感谢 @mrmacete!
  • gumjs:防止 File 和 SQLite API 触发 Interceptor。感谢 @mrmacete!
  • gumjs:执行 V8 作业时持有 Isolate 锁。
  • gumjs:修复销毁 V8 脚本时的死锁。
  • gumjs:修复 V8 调试器无法看到已加载脚本的问题。
  • gumjs:修复 Darwin/arm64e 上对 CModule 外部工具链的支持。
  • gumjs:当 V8 MAP_JIT 在 Darwin 上失败时使用后备方案。
  • gumjs:初始化后不再冻结 V8 标志,以避免在 Darwin 上的强化进程中出现问题。
  • socket:升级到 libsoup 3.x,以支持 HTTP/2。
  • devkit:向 frida-core kit 添加 .gir。感谢 @lateralusd!
  • devkit:更新示例以使用当前的 Device API。
  • python:在所有平台上支持 UNIX socket 地址。
  • node:修复 Node.js v19 兼容性。
  • deps:将大多数依赖项升级到最新最佳版本。
  • build:重构并移除非 Meson 遗留代码。

Frida 16.0.2 发布

星期五到了!这里有一个包含大量改进的全新版本:

  • macOS:修复在 macOS >= 12 上附加 arm64e 系统应用和服务的支持。
  • i/macOS:升级对 chained fixup 的支持。
  • iOS:修复运行 iOS < 14 的 arm64e 设备上的系统会话。
  • system-session:禁用 Exceptor 和监视器。
    • Exceptor 会干扰宿主进程的信号处理,既有风险又容易发生冲突。
    • 监视器对系统会话并没有实际用途。
  • interceptor:修复 iOS/arm64 上 grafted 模式使用的 trampoline。感谢 @mrmacete!
  • compiler:修复多个平台上的稳定性问题。
  • compiler:修复 @frida/path shim。
  • compiler:在非 x86/64 Linux 上也使用 snapshot,从而提升速度。
  • devkit:修复 Windows、macOS 和 Linux devkit 中的回归问题。
  • v8:修复由 libc-shim 未能实现 V8 所依赖的 malloc_usable_size() API 而导致的堆损坏。
  • v8:修复使用不同 snapshot 的脚本支持。此前 V8 被配置为在 isolate 之间共享 只读空间,导致该支持失效;这一选项与多个 snapshot 冲突。
  • v8:改进清理流程。
  • v8:修复违反 v8::External API 契约的问题。
  • v8:升级到 10.9.42。
  • zlib:升级到 1.2.13。
  • gum:修复基于 ELF 的操作系统上的子项目构建。
  • python:修复已发布 Linux wheel 的标签。
    • 添加旧版平台标签,使旧版 pip 能识别它们。
    • 将部分 wheel 标记为需要 glibc >= 2.17,因为某些架构无法识别更低版本。

Frida 16.0.1 发布

这次有两项虽小却重要的错误修复:

  • python:修复计算得出的 sdist 版本元数据。
  • python:在 macOS 上假定 devkit 构建不是通用构建。

Frida 16.0.0 发布

希望你们当中已经有人开始享受 frida.Compiler 了!如果你完全不知道它是什么,请查看 15.2.0 版本说明。

性能

回到 15.2.0,当时 frida.Compiler 有一点让我很困扰:即便在我的 i9-12900K Linux 工作站上,仅仅编译一个很小的“Hello World”也需要几秒钟:

$ time frida-compile explore.ts -o _agent.js

real	0m1.491s
user	0m3.016s
sys	0m0.115s

经过大量性能剖析和难以想象的繁琐打磨后,我终于得到了这样的结果:

$ time frida-compile explore.ts -o _agent.js

real	0m0.325s
user	0m0.244s
sys	0m0.109s

差别相当大!这意味着 frida -l explore.ts 这类即时编译场景现在顺畅了很多。更关键的是,基于 Frida 的工具可以用这种方式加载用户脚本,而不会让用户忍受数秒的启动延迟。

快照

你或许想知道我们是如何让编译器如此快速启动的。查看内部实现会发现,它使用 TypeScript 编译器。启动时需要解析并运行的代码相当多。而且,加载和处理定义所有相关类型的 .d.ts 文件,开销其实还要更高。

我们在 15.2 中实现的第一项优化,是在 V8 运行时可用时直接使用它。仅这一项就带来了可观的提速。不过,稍加性能剖析便能看出,当我们开始处理 .d.ts 文件时,V8 意识到自己面对的是繁重工作负载,因此花费了大量时间来优化 TypeScript 编译器的代码。

这让我想起很久以前注意到的一个非常酷的 V8 功能:自定义启动快照。简单来说,如果我们能够预先预热 TypeScript 编译器,并在构建 Frida 时提前创建所有 .d.ts 源文件,就可以在那个时间点为虚拟机状态制作快照,并嵌入生成的启动快照。之后在运行时,我们便可以从快照启动,立即进入工作状态。

在实现这项功能的过程中,我扩展了 GumJS,使 create_script() 可以同时接收快照和 agent 源代码。另有 snapshot_script(),用于首先创建快照。

例如:

import frida

session = frida.attach(0)

snapshot = session.snapshot_script("const example = { magic: 42 };",
                                   warmup_script="true",
                                   runtime="v8")
print("Snapshot created! Size:", len(snapshot))

随后可以将该快照保存到文件,并像这样在以后加载:

script = session.create_script("console.log(JSON.stringify(example));",
                               snapshot=snapshot,
                               runtime="v8")
script.load()

请注意,创建快照时使用的操作系统、架构和 V8 版本必须与之后加载快照时相同。

V8 10.x

另一个令人兴奋的消息是,我们已将 V8 升级到 10.x,这意味着可以享用最新的虚拟机改进和 JavaScript 语言特性。考虑到上一次升级已经是两年多以前,这次无疑是一次相当扎实的升级。

多构建系统的诅咒,第二部分

你或许还记得 15.1.15 版本说明 中提到,我们前所未有地接近“整个 Frida 都能使用单一构建系统完成构建”这一里程碑。当时唯一剩下的组件是 V8,我们过去使用 Google 的 GN 构建系统来构建它。很高兴地告诉大家,我们终于到达了这个里程碑。现在,我们为 V8 配备了一套全新的 Meson 构建系统。太棒了!

结语(EOF)

此外还有许多令人兴奋的变化,务必查看下面的更改日志。

用得开心!

更改日志

  • compiler:使用快照缩短启动时间。
  • compiler:升级 frida-compile 和其他依赖项。
  • 增加对 JavaScript 虚拟机快照的支持。目前只有 V8 后端实现了该功能,因为 QuickJS 暂不支持。
  • 将调试器 API 从 Session 移至 Script。这是必需的,因为 V8 的调试器按 Isolate 工作,而为了支持快照,现在每个 Script 都需要一个 Isolate。
  • server+portal:修复守护进程父进程就绪失败时的退出问题。感谢 @pachoo!
  • resource-compiler:增加压缩支持。我们将其用于 frida.Compiler 的堆快照。
  • ipc:增大 UNIX 套接字缓冲区以提高吞吐量。
  • meson:将 frida-payload 提升为公共 API。这样就能为 frida-agent 和 frida-gadget 不适用的场景实现自定义 payload。
  • windows:迁移到 Visual Studio 2022。
  • windows:将工具链/SDK 逻辑改为使用细粒度 SDK。
  • windows:不再依赖 .py 文件关联。
  • darwin:修复与 macOS 13 和 iOS >= 15.6.1 的兼容性。
  • darwin:如果存在 Apple 的 libffi-trampolines.dylib,则使用它,从而支持 iOS 15 及更高版本。感谢 @hsorbo 带来的愉快结对编程时光!
  • fruity:修复 USBMUXD_SOCKET_ADDRESS 的处理。感谢 @0x3c3e!
  • fruity:停止支持 USBMUXD_SERVER_* 环境变量。感谢 @as0ler!
  • droidy:改进 ADB 环境变量的处理。感谢 @0x3c3e!
  • java:(android) 修复 Android 11 和 12 上 ClassLinker 偏移量的检测(#264)。感谢 @sh4dowb!
  • java:(android) 修复 Android 13 上的早期插桩。
  • java:处理以 $ 为前缀的方法和字段。感谢 @eybisi!
  • android:迁移到 NDK r25。
  • arm64:优化内存复制实现。
  • stalker:确保 EventSink 在拆卸时停止。
  • stalker:修复分支涉及移位时 ARM 栈遭破坏的问题。
  • stalker:处理涉及移位寄存器的 ARM PC 加载。
  • stalker:应用回填补丁时通知 ARM observer。
  • stalker:收到通知时应用 ARM 回填补丁。
  • stalker:为 switch block 回调增加 ARM 支持。
  • arm-reader:公开 disassemble_instruction_at()。
  • thumb-reader:公开 disassemble_instruction_at()。
  • memory:重新调整 API,使其与当前 V8 语义一致。
  • gumjs:将 V8 后端改为每个脚本使用一个 Isolate。
  • gumjs:支持通过环境变量传递 V8 标志:FRIDA_V8_EXTRA_FLAGS。
  • gumjs:在 Darwin/arm* 上使用 V8 写保护。
  • gumjs:增加对动态定义脚本的支持。
  • prof:支持 Linux/MIPS 上的旧系统头文件。
  • devkit:改进示例在 UNIX 上的编译文档。
  • ci:将其余旧版 CI 迁移到 GitHub Actions。
  • quickjs:修复模块求值期间出错时的释放后使用问题。
  • v8:升级到最新的 V8 10.x。
  • v8:增加 Meson 构建系统。
  • usrsctp:将 Windows 要求降低到 XP,与其他组件保持一致。
  • xz:避免使用 ANSI 时代的 Windows API。
  • libc-shim:支持 Linux/MIPS 上的旧系统头文件。
  • glib:为 MIPS 增加 Linux libc 回退实现。
  • 增加 config.mk 选项,以便在 Android 上禁用模拟 agent,从而构建更小的二进制文件。感谢 @muhzii!
  • python:停止支持 Python 2,现代化代码,增加文档字符串和类型标注,使用现代工具增加 CI,以及其他许多改进。感谢 @yotamN!
  • python:构建 Python wheel,而不是 egg。感谢 @oriori1703!
  • python:修复 Device.get_bus()。此前的实现调用了并不存在的 _Device.get_bus()。感谢 @oriori1703!
  • python:迁移到稳定版 Python C API。
  • python:增加使用 frida-core devkit 从源代码构建的支持。
  • python:增加对新快照 API 的支持。
  • node:增加对新快照 API 的支持。
  • node:修复与 Electron v20 的兼容性。

Frida 15.2.2 发布

周末前再带来两项改进:

  • darwin:始终在本地承载系统会话。这样,仅为使用系统会话(PID 0)时,无需把 frida-helper 写入临时文件再启动它。
  • darwin:重构 frida-helper IPC,避免使用 Mach 端口,从而避免在新版 macOS 上崩溃。感谢共同作者 @hsorbo 高效的结对编程!

Frida 15.2.1 发布

这次有两个虽小但很重要的错误修复:

  • compiler:在 watch() 期间忽略无关变更。
  • darwin:提高内存范围文件信息的准确性。在可用时使用 PROC_PIDREGIONPATHINFO2,使查询仅限于由 vnode 支持的映射。感谢 @i0n1c 发现并追踪这个长期存在的问题。

Frida 15.2.0 发布

这次发布让我格外兴奋。多年来我一直想简化 Frida 的 JavaScript 开发体验。作为开发者,我可能从一个非常简单的 agent 起步,但随着它不断增长,痛苦也逐渐显现。

早期可能会想把 agent 拆分为多个文件,也可能想使用 npm 上的现成软件包,例如 frida-remote-stream。之后又会需要代码补全、内联文档、类型检查等,于是把 agent 迁移到 TypeScript 并启动 VS Code。

由于我们一直借助现有的优秀 Web 前端工具,拼图的各个部分其实都已具备。可以使用 Rollup 等打包器将源文件合并为单个 .js,可以使用 @frida/rollup-plugin-node-polyfills 与 npm 软件包互操作,也可以接入 @rollup/plugin-typescript 来支持 TypeScript。

不过,每次都重新搭建这么多基础设施很麻烦,所以我最终创建了 frida-compile:一个替你完成这些接线工作的简单工具,其默认配置针对 Frida 场景进行了优化。但它仍需要 package.json、tsconfig.json 等样板文件。

为解决这个问题,我发布了 frida-agent-example,这个仓库可以克隆后作为起点。但这仍有些麻烦,因此后来 frida-tools 又加入了名为 frida-create 的 CLI 工具。即便如此,我们仍要求用户安装 Node.js、处理 npm,并可能面对那些摆在那里的 .json 文件而感到困惑。

这时我突然想到:如果能用 frida-compile 把 frida-compile 本身编译成一个自包含的 .js,并在 Frida 的系统会话中运行,会怎么样?系统会话是一个不太为人熟知的功能,可以在托管 frida-core 的进程中加载脚本。例如使用 Python 绑定时,该进程就是 Python 解释器。

一旦能在 GumJS 内运行这个 frida-compile agent,就可以与它通信并将其转化为 API。随后可通过语言绑定公开该 API,frida-tools 也能使用它,为用户提供无需安装 Node.js/npm 的 frida-compile CLI 工具。当用户要求加载扩展名为 .ts 的脚本时,REPL 等工具也可以无缝使用该 API。

而这一切正是我们已经完成的工作!🥳

build()

在 Python 中使用它非常简单:

import frida

compiler = frida.Compiler()
bundle = compiler.build("agent.ts")

bundle 变量是一个字符串,可以传给 create_script(),也可以写入文件。

运行该示例时,可能会看到类似下面的内容:

Traceback (most recent call last):
  File "/home/oleavr/src/explore.py", line 4, in <module>
    bundle = compiler.build("agent.ts")
  File "/home/oleavr/.local/lib/python3.10/site-packages/frida/core.py", line 76, in wrapper
    return f(*args, **kwargs)
  File "/home/oleavr/.local/lib/python3.10/site-packages/frida/core.py", line 1150, in build
    return self._impl.build(entrypoint, **kwargs)
frida.NotSupportedError: compilation failed

这会让我们想知道它为什么失败,因此为 diagnostics 信号添加一个处理程序:

import frida

def on_diagnostics(diag):
    print("on_diagnostics:", diag)

compiler = frida.Compiler()
compiler.on("diagnostics", on_diagnostics)
bundle = compiler.build("agent.ts")

于是问题突然变得一目了然:

on_diagnostics: [{'category': 'error', 'code': 6053,
    'text': "File '/home/oleavr/src/agent.ts' not "
            "found.\n  The file is in the program "
            "because:\n    Root file specified for"
             " compilation"}]
…

我们忘记真正创建文件了!好,先创建 agent.ts:

console.log("Hello from Frida:", Frida.version);

再把该脚本写入文件:

import frida

def on_diagnostics(diag):
    print("on_diagnostics:", diag)

compiler = frida.Compiler()
compiler.on("diagnostics", on_diagnostics)
bundle = compiler.build("agent.ts")
with open("_agent.js", "w", newline="\n") as f:
    f.write(bundle)

现在运行它,就会得到一个可直接使用的 _agent.js:

$ cat _agent.js
📦
175 /explore.js.map
39 /explore.js
✄
{"version":3,"file":"explore.js","sourceRoot":"/home/oleavr/src/","sources":["explore.ts"],"names":[],"mappings":"AAAA,OAAO,CAAC,GAAG,CAAC,SAAS,KAAK,CAAC,OAAO,GAAG,CAAC,CAAC"}
✄
console.log(`Hello ${Frida.version}!`);

这种看起来很奇怪的格式,是 GumJS 让我们选择使用新 ECMAScript Module(ESM)格式的方式。在这种格式中,代码被限制在其所属模块内,而不会在全局作用域中求值。这也意味着可以加载多个导入/导出值的模块。.map 文件是可选的,可以省略;如果保留,GumJS 就能在堆栈跟踪中将生成的 JavaScript 行号映射回 TypeScript。

总之,来试运行一下 _agent.js:

$ frida -p 0 -l _agent.js
     ____
    / _  |   Frida 15.2.0 - A world-class dynamic instrumentation toolkit
   | (_| |
    > _  |   Commands:
   /_/ |_|       help      -> Displays the help system
   . . . .       object?   -> Display information about 'object'
   . . . .       exit/quit -> Exit
   . . . .
   . . . .   More info at https://frida.re/docs/home/
   . . . .
   . . . .   Connected to Local System (id=local)
Attaching...
Hello 15.2.0!
[Local::SystemSession ]->

成功了!现在重构一下,把代码拆分为两个文件:

agent.ts

import { log } from "./log.js";

log("Hello from Frida:", Frida.version);

log.ts

export function log(...args: any[]) {
    console.log(...args);
}

现在再次运行示例编译器脚本,它应生成一个看起来更有意思的 _agent.js:

📦
204 /agent.js.map
72 /agent.js
199 /log.js.map
58 /log.js
✄
{"version":3,"file":"agent.js","sourceRoot":"/home/oleavr/src/","sources":["agent.ts"],"names":[],"mappings":"AAAA,OAAO,EAAE,GAAG,EAAE,MAAM,UAAU,CAAC;AAE/B,GAAG,CAAC,mBAAmB,EAAE,KAAK,CAAC,OAAO,CAAC,CAAC"}
✄
import { log } from "./log.js";
log("Hello from Frida:", Frida.version);
✄
{"version":3,"file":"log.js","sourceRoot":"/home/oleavr/src/","sources":["log.ts"],"names":[],"mappings":"AAAA,MAAM,UAAU,GAAG,CAAC,GAAG,IAAW;IAC9B,OAAO,CAAC,GAAG,CAAC,GAAG,IAAI,CAAC,CAAC;AACzB,CAAC"}
✄
export function log(...args) {
    console.log(...args);
}

把它加载到 REPL 中,应得到与之前完全相同的结果。

watch()

把这个玩具编译器变成一个工具:它加载编译后的脚本,并在磁盘上的源文件发生变化时重新编译:

import frida
import sys

session = frida.attach(0)
script = None

def on_output(bundle):
    global script
    if script is not None:
        print("Unloading old bundle...")
        script.unload()
        script = None
    print("Loading bundle...")
    script = session.create_script(bundle)
    script.on("message", on_message)
    script.load()

def on_diagnostics(diag):
    print("on_diagnostics:", diag)

def on_message(message, data):
    print("on_message:", message)

compiler = frida.Compiler()
compiler.on("output", on_output)
compiler.on("diagnostics", on_diagnostics)
compiler.watch("agent.ts")

sys.stdin.read()

开始运行:

$ python3 explore.py
Loading bundle...
Hello from Frida: 15.2.0

让它持续运行,再编辑磁盘上的源代码,应看到一些新输出:

Unloading old bundle...
Loading bundle...
Hello from Frida version: 15.2.0

太棒了!

frida-compile

还可以使用 frida-tools 新增的 frida-compile CLI 工具:

$ frida-compile agent.ts -o _agent.js

它也支持监视模式:

$ frida-compile agent.ts -o _agent.js -w

REPL

REPL 也由新的 frida.Compiler 提供支持:

$ frida -p 0 -l agent.ts
     ____
    / _  |   Frida 15.2.0 - A world-class dynamic instrumentation toolkit
   | (_| |
    > _  |   Commands:
   /_/ |_|       help      -> Displays the help system
   . . . .       object?   -> Display information about 'object'
   . . . .       exit/quit -> Exit
   . . . .
   . . . .   More info at https://frida.re/docs/home/
   . . . .
   . . . .   Connected to Local System (id=local)
Compiled agent.ts (1428 ms)
Hello from Frida version: 15.2.0
[Local::SystemSession ]->

致谢

感谢 @hsorbo!我们一起开发 frida.Compiler 的结对编程过程既有趣又高效!🙌

EOF

此版本还有不少其他精彩改进,请务必查看下面的变更日志。

祝使用愉快!

变更日志

  • core:添加 Compiler API。目前只通过 Python 绑定公开,但可从 C/Vala 使用。
  • interceptor:改进 replace(),支持返回原始实现。感谢 @aviramha!
  • gumjs:修复 writer 选项中 pc 的类型。
  • gumjs:修复存在循环依赖时 V8 ESM 崩溃的问题。
  • gumjs:处理每个模块具有多个别名的 ESM bundle。
  • gumjs:收紧 Checksum 数据参数的解析。
  • android:修复崩溃传递中的空指针解引用。感谢 @muhzii!
  • fruity:使用环境变量查找 usbmuxd。感谢 @0x3c3e!
  • ios:提高 Substrate 检测逻辑的韧性。感谢 @lemon4ex!
  • meson:仅在 V8 可用时才尝试使用。感谢 @muhzii!
  • windows:增加无 V8 构建支持。
  • devkit:修复 Windows 上的库依赖提示。感谢 @nblog!

Frida 15.1.28 发布

此版本带来了几项令人兴奋的新功能。

File API

使用我们 JavaScript File API 的读者可能已经注意到,它支持写入指定文件,但之前无法读取。 现在已经支持了。

例如,将文本文件的每一行作为字符串读取:

const f = new File('/etc/passwd', 'r');
let line;
while ((line = f.readLine()) !== '') {
  console.log(`Read line: ${line.trimEnd()}`);
}

(请注意,这里假定文本文件使用 UTF-8 编码。目前不支持其他编码。)

你也可以从某个偏移处读取指定数量的字节:

const f = new File('/var/run/utmp', 'rb');
f.seek(0x2c);
const data = f.readBytes(3);
const str = f.readText(3);

也可以省略参数,以读取文件的剩余部分。但如果只想一次读取整个文本文件,还有一种更简单的方式:

const text = File.readAllText('/etc/passwd');

读取二进制文件也同样简单:

const bytes = File.readAllBytes('/var/run/utmp');

(其中 bytes 是 ArrayBuffer。)

有时你可能还想将字符串写入文本文件:

File.writeAllText('/tmp/secret.txt', 'so secret');

或者写入 ArrayBuffer:

const data = args[0].readByteArray(256);
File.writeAllBytes('/tmp/mystery.bin', data);

回到前面的示例,seek() 也支持相对偏移:

f.seek(7, File.SEEK_CUR);
f.seek(-3, File.SEEK_END);

获取当前文件偏移也同样简单:

const offset = f.tell();

Checksum API

这次添加的另一项 JavaScript API 用于计算校验和。虽然这完全可以用“用户空间”JavaScript 实现, 但由于 Frida 依赖 GLib,而 GLib 已经开箱即用地提供了 Checksum API,我们几乎可以零成本获得该功能。 我们所需要做的只是将其暴露出来。

将这些组合起来,就意味着我们可以读取文件并计算其 SHA-256:

const utmp = File.readAllBytes('/var/run/utmp');
const str = Checksum.compute('sha256', utmp);

或者进行更精细的控制:

const checksum = new Checksum('sha256');
checksum.update(File.readAllText('/etc/hosts'));
checksum.update(File.readAllBytes('/var/run/utmp'));
console.log('Result:', checksum.getString());
console.log(hexdump(checksum.getDigest(), { ansi: true }));

(可以通过我们的 TypeScript bindings 详细了解此 API。)

文末

此版本还有几项其他好东西,请一定查看下面的更改日志。

尽情享用!

更改日志

  • gumjs:扩展 File API。
  • gumjs:添加 Checksum API。
  • gumjs:修复从根目录进行相对 ESM 导入时的处理。
  • glib:(win32) 为普通文件添加 Input/OutputStream 支持。
  • build:在 Windows 上将 XP SDK 设为可选。
  • node:目标改为 Electron 19.0.0,而不是 19.0.0-alpha.1。
  • node:定义 openssl_fips 以规避 node-gyp 问题。

Frida 15.1.27 发布

看来我今早应该多喝点咖啡,所以这里又有一个新版本,真正修复 15.1.25 中 这个坏掉的修复:

  • java: (android) 防止 ART 编译已替换的方法

原来 kAccCompileDontBother 常量在 Android 8.1 中发生了变化,并且在 7.0 之前 根本不存在。糟糕!此版本修复了它,这次是真的 😊

Frida 15.1.26 发布

这次只有一项变更,与上一版本中的这个修复有关:

  • java:(android) 阻止 ART 编译已替换的方法

事实证明,kAccCompileDontBother 常量是错误的。本版本修复了它。(来自未来的剧透:其实并没有。)

Frida 15.1.25 发布

本次发布包含不少令人兴奋的内容。让我们直接开始吧。

访问 FPU/向量寄存器

对于在 32 位和 64 位 ARM 上使用 Frida 的用户来说,这里有个好消息。到目前为止, 我们只公开了 CPU 的整数寄存器;从这个版本开始,FPU/向量寄存器也可以使用了!🎉

对于 32 位 ARM,这意味着 q0 到 q15、d0 到 d31,以及 s0 到 s31。 对于 64 位 ARM,则是 q0 到 q31、d0 到 d31,以及 s0 到 s31。 如果从 JavaScript 访问这些寄存器,向量属性使用 ArrayBuffer 表示,其他寄存器则使用 number 类型。

Java.backtrace()

现有的 Java.backtrace() API 现在会在返回的 frames 中提供两个新属性: 其中还会公开 methodFlags 和 origin。

质量

我终于堵住了 RPC 服务器端代码中的一个内存泄漏。这个问题是我在 15.1.10 中实现 Vala 编译器针对 DBus 回复处理的代码生成优化时引入的。 感谢 @rev1si0n 报告并协助定位这一回归!

结束

本次发布还包含其他一些好东西,请务必查看下面的变更日志。

尽情享用吧!

变更日志

  • vala:堵住服务器端 GDBus 回复处理中的泄漏。这影响了 Frida 中所有服务器端实现。
  • glib:禁用对“charset.alias”的支持。这意味着我们不再尝试打开此文件;在 iOS 等某些系统上, 打开它可能导致违反沙箱规则。
  • java:(android) 向 Java.backtrace() 帧添加 methodFlags。
  • java:(android) 向 Java.backtrace() 帧添加 origin。
  • java:(android) 阻止 ART 编译被替换的方法。感谢 @s1341 找到解决办法!
  • cpu-context:添加 ARM FPU/向量寄存器和 NZCV。
  • cpu-features:添加 VFPD32 标志及检测逻辑。
  • stalker:修复 arm 后端中的 VFP D32 检测。
  • gumjs:向 arm_reg 绑定添加向量寄存器。
  • x86-writer:添加 put_fx{save,rstor}_reg_ptr()。
  • arm-writer:添加不带偏移量的加载/存储变体。
  • arm-writer:添加 put_v{push,pop}_range()。
  • arm-writer:从 put_ands_reg_reg_imm() 中移除空操作检查。
  • arm-writer:将 *_registers() 重命名为 *_regs()。
  • arm-writer:支持使用 Q 寄存器进行向量压栈/出栈。
  • thumb-writer:添加 put_v{push,pop}_range()。
  • thumb-writer:支持使用 Q 寄存器进行向量压栈/出栈。
  • arm64-writer:添加不带偏移量的加载/存储变体。
  • arm64-writer:添加 put_mov_{reg_nzcv,nzcv_reg}()。
  • libc-shim:支持 Linux/ARM 上的旧系统头文件。
  • node:升级依赖项。
  • node:发布 Electron 19 而不是 18 的预构建版本。

Frida 15.1.24 发布

这次只有一项改动,但对在 Android 上使用 Frida 的用户非常重要:我们的 Java 方法 Hook 实现在某些情况下会选择与生成代码冲突的暂存寄存器,从而引发崩溃。该问题现已修复。

尽情体验吧!

Frida 15.1.23 发布

本版本的主要主题是操作系统支持:我们修复了 Android 12 上的一些粗糙之处,并引入对 Android 13 的初步支持。在开发 frida-java-bridge 时,我还发现自己需要 JVM 专用后端中的一些 JVMTI 代码。这些部分现在已经共享,JVM 专用代码也更加完善,并全新支持 JDK 17。

我们还提高了多处的稳定性,并让 CodeWriter API 更容易安全使用。可移植性也得到改善:基于 QuickJS 的 JavaScript 运行时终于能在小端构建机器上交叉编译为大端目标,反之亦然。

要了解更多信息,请务必查看下方的变更日志。

祝使用愉快!

变更日志

  • linux:处理 ptrace() 期间的伪信号。
  • android:添加 Android 12+ 上 system_server 缺失的 SELinux 规则。
  • android:修复真实设备上的 Android 13 检测。
  • android:处理 Android 13 中新的链接器内部实现。
  • java:改进 Java.enumerateMethods() 的错误消息。感谢 @jpstotz!
  • java:(android) 处理内联的 GetOatQuickMethodHeader()。
  • java:(android) 改进对非 Google Android 12+ ROM 的支持。
  • java:(android) 修复 Android >= 12 上的 Java.choose()。
  • java:(android) 添加 Android 13 支持。
  • java:(android) 修复 x64 重编译逻辑中 threadReg 被破坏的问题。
  • java:(android) 解释 Java.deoptimizeBootImage() 不可用的原因。
  • java:(android) 通过 api.jvmti 公开 JVMTI。
  • java:(android) 改进操作系统功能相关的错误消息。
  • java:(jvm) 添加 JDK 17 的基本支持。
  • java:(jvm) 为 thread_from_jni_environment() 添加后备方案。
  • java:(jvm) 修复 withJvmThread() 前序/后序逻辑中的释放后使用。
  • java:(jvm) 改进 InstanceKlass 偏移检测。
  • code-writer:添加 flush_on_destroy 选项。
  • gumjs:禁用 CodeWriter 的 flush_on_destroy 选项。这样一来,writer 在被垃圾回收时不会再向内存写入,因此使用更安全。到那时,目标内存可能已不可写,或可能已归其他代码所有。
  • gumjs:必要时嵌入字节序交换后的 QuickJS 字节码。这意味着 GumJS 可以跨大小端交叉编译。
  • gumjs:修复 Instruction 复制逻辑中的二次释放。
  • gumjs:修复 Relocator 指令访问器。
  • gumjs:在 reset() 和 dispose() 时刷新 CodeWriter。
  • gumjs:改进 NativePointer#strip() 以支持 ARM TBI。
  • gumjs:让 Instruction 包装器在零拷贝模式下更安全。
  • gumjs:修复 QuickJS 运行时中的 Relocator 泄漏。
  • quickjs:修复对字节序交换输出的支持。同时将 QuickJS 升级到最新上游版本,并包含 Unicode 14 更新。

Frida 15.1.22 发布

事实证明,Gum 在 15.1.15 中经历的大规模改造引入了一些错误处理回归。 实际抛出的错误与 frida-core 中 Vala 代码所预期的错误不匹配,结果导致进程崩溃, 而不是将友好的错误向上传递给 Python 绑定等调用方。现在终于解决了这个问题。 不过,我希望我们能更早发现它——显然这一领域的测试覆盖仍然不足。

除错误处理修复之外,我们还包含一项解决增量构建问题的构建系统修复。 感谢 Londek 做出的精彩贡献。

尽情享用吧!

Frida 15.1.20 发布

我们发现 15.1.10 破坏了 Android/x86_64 上 frida-java-bridge 的内联 Hook。 此版本已将其修复。

这次我们还改为提供面向 Node.js v18 而非 v17 的预构建版本。(唉,真该把 frida-node 移植到 Node-API,这样就能结束这场疯狂了!)

祝你使用愉快!

Frida 15.1.19 发布

事实证明,15.1.18 的发布自动化存在错误,导致上传了过期的 Python 绑定产物。

为了让这次发布更令人愉快,我还加入了一项针对 x86/64 的 Stalker 改进:现在也会处理 clone3 系统调用。这个问题由 Stalker 测试套件在部分系统上发现。

尽情体验吧!

Frida 15.1.18 发布

这次各处都有大量改进,其中包括许多稳定性提升。

我一直在继续改进我们的 CI 和构建系统基础设施。长期回归之后,QNX 和 MIPS 支持已经起死回生。 这些问题此前因为缺少 CI 覆盖而未被发现。现在我们已经部署 CI,确保这种情况不会再次发生。

请查看下面的变更日志,全面了解新增内容。

尽情享用吧!

变更日志

  • gadget:修复死锁。当 Gadget 在持有内部锁的情况下阻塞动态链接器并等待 resume() 时, 就会发生这个问题。在这种情况下,我们会在阻塞期间处理 JS MainContext,网络 I/O 则由 Gadget 线程处理。由于 Stalker 在其 class_init() 期间可能与动态链接器交互,必须确保该操作 从 JS 线程而不是网络 I/O 线程发生。
  • exit-monitor:修复 fork() 未被察觉时的死锁。
  • darwin:在 Corellium 上运行时跳过伪签名。
  • darwin:修复与较旧 iOS SDK 的兼容性。
  • darwin-backtracer:修复循环变量回绕问题。
  • darwin-mapper:修复使用链式修复时的占用空间预算。
  • linux:修复 Process.modify_thread() 的等待逻辑。
  • linux:在现代 glibc 系统上完整解析 libc。
  • linux:移除 Linjector 的清理延迟。
  • ios:添加 config.mk 选项,可以在不包含越狱支持代码的情况下构建,以兼容 TestFlight 等环境。
  • ios:消除对外部 Mach VM 头文件的依赖。
  • android:修复 Android/x86 上的 unw_getcontext();该问题会在 Thread.backtrace() 等调用期间导致栈损坏。
  • freebsd:添加 BSDmakefile 以方便使用。
  • freebsd:提高 gum_clear_cache() 的可靠性。
  • freebsd:改进程序路径查询 API。
  • freebsd:MAP_32BIT 失败时进行更充分的尝试。
  • mips:修复因缺少 CI 而长期未被发现的回归。
  • qnx:修复因缺少 CI 而长期未被发现的回归,同时改进 QNX 后端。
  • posix:如果 madvise() 不可用,则使用 posix_madvise()。
  • stalker:在 glibc、Android 和 FreeBSD 上检测线程退出实现。
  • stalker:修复 x86 后端中的 Linux clone() 支持。
  • stalker:修复 JECXZ/JRCXZ x86 指令的反向修补。
  • stalker:修复 x86 后端中两处混淆 pc 与 code 的问题。
  • stalker:优化 x86 后端中的 Linux 系统调用逻辑。
  • stalker:将展开支持置于 API 之后。
  • stalker:简化并修复 x86 展开中的 Interceptor 逻辑。
  • stalker:在 arm64 后端中实现展开挂钩。感谢 @s1341!
  • stalker:添加反向修补查询支持。
  • stalker:支持重新编译代码块。
  • process:添加 resolve_module_pointer()。
  • elf-module:改进 DT_SYMTAB 条目数量检测。
  • elf-module:跳过名称引用悬空的符号。
  • symbolutil-libdwarf:添加对 DWARF v5 的支持。
  • libdwarf:向后移植上游对 DW_FORM_line_strp 处理的修复。
  • dbghelp-backtracer:提高 32 位 x86 上的可靠性。
  • arm-relocator:简化 PC 相对 LDR 的处理。
  • arm-writer:添加 call_reg_with_arguments*()。
  • arm-writer:处理参数超过四个的 put_call*()。
  • thumb-writer:处理 put_call*() 的栈对齐。
  • arm64-writer:优化 LDR reg, #0。
  • x86-relocator:添加 input_pc 以支持离线使用。
  • x86-relocator:修复 RIP 相对快速路径中混淆 PC 与输出的问题。
  • x86-relocator:改进 RIP 偏移修正逻辑。
  • bounds-checker:回退到匹配的堆 API。
  • gumjs:修复 CModule 内存分配逻辑。
  • gumjs:修复使用内置 TinyCC 时的 CModule 运行时。
  • gumjs:将构建时的 Python 最低要求降至 3.7。
  • heap-api:改进非 Windows 操作系统上的 libc 检测。
  • heap-api:将静态 MSVC CRT API 纳入列表。
  • gum:改进 Meson 构建系统以支持 MSVC。
  • gum:改进 Gum vapi,公开更多 API。
  • core:调用 modulate.py 中的工具时关闭本地化,修复某些区域设置下的构建失败。
  • python:修复 get_max_argument_count() 中错误引用计数导致的稳定性问题。
  • python:修复 get_index_url_from_pip()。感谢 @X5tar!
  • python:修复 Python < 3.6 上的索引 URL 获取。感谢 @serfend!
  • node:发布 Electron 18 而不是 16 的预构建版本。
  • ci:添加 Linux/MIPS、FreeBSD/x86_64、FreeBSD/arm64 和 QNX/armeabi。对于 Gum, 还添加 Windows/x86_64、macOS/x86_64、Linux/x86、Linux/x86_64、iOS/arm64、 Android/x86、Android/arm 和 Android/arm64。

Frida 15.1.17 发布

此版本一项值得注意的改进是全面重构了 Java.backtrace()。它现在采用惰性计算,速度提升超过 10 倍。我还完善了它的 API,目前该 API 已视为稳定。

开发 frida-java-bridge 时,我优化了 Env 对象的处理方式:如果当前线程已有实例,就会复用它。

其余改进列在下面的变更日志中,请务必查看。

尽情体验吧!

变更日志

  • 修复 i/macOS、Android 和 QNX 的 devkit,其中缺少部分 libiconv。
  • 改进 LLVM 工具链上的 devkit 打包。
  • 改进 GLib 的 diet 模式支持。
  • cmodule:公开 g_strndup()。
  • cmodule:公开 Gum 的线程局部存储 API。
  • java:重构 Java.backtrace(),改为惰性计算并提升超过 10 倍的速度。
    • 将线程切换和栈遍历逻辑移至 CModule。
    • 返回 Backtrace 对象,而不是由栈帧组成的数组。
    • 提供低成本的 id 属性用于去重。
    • 访问 frames 属性时才惰性计算栈帧。
  • java:尽可能避免创建成本较高的 Env。
  • python:改进索引 URL 处理。感谢 @GalaxySnail!

Frida 15.1.16 发布

这次我们赶在周末前带来两个错误修复和一个新功能。

Gum 过去依赖 GIO,但该依赖已在上个版本中移除。这项变更带来的不幸结果是, agent 和 gadget 不再清理 GIO,因为它们原本依靠 Gum 的清理代码完成此事。 这意味着我们遗留了线程,而这从来都不是好事。因此,这是第一个错误修复。

同样在上个版本中,我们的 Python 绑定内的 setup.py 经历了大幅修改。我们改进了 .egg 下载逻辑,却不慎破坏了本地 .egg 逻辑。这是第二个错误修复。

接下来是新功能。对于使用 Gum JavaScript 绑定 GumJS 的用户,我们现在支持 console.count() 和 console.countReset()。浏览器和 Node.js 也实现了这些功能, 它们可以方便地统计某个标签出现的次数。感谢 @yotamN 作出这项出色贡献。

祝你使用愉快!

Frida 15.1.15 发布

本版本有不少令人兴奋的内容。让我们直接开始。

FreeBSD

我们的目标是支持用户关心的所有平台。在本版本中,我想迈出将支持扩展到 BSD 的第一步。现在我很高兴地宣布,Frida 终于也支持 FreeBSD 了!🎉

目前只支持 x86_64 和 arm64,但如果有人愿意帮忙,扩展到其余体系结构并不困难。

移植工作带来了多项架构改进,也普遍提升了基于 ELF 的操作系统上的稳健性。它还让我想到了一些改进 Linux 注入器、使其支持向容器注入的方案;这是我今后希望完成的工作。

Stalker 性能

在 15.1.10 中,Stalker 在 x86/64 上获得了巨大的性能提升。本版本将相同思路应用到了 arm64 后端,包括改进局部性、更好的内联缓存等。据说我们当时在 FuzzBench 中已经能超越或追平 QEMU,现在 arm64 上的表现应该也相当不错。与此同时,我们还提升了稳定性。令人兴奋!

GObject 内省

早在 14.1 中,@meme 就为构建系统接入了 GObject Introspection 支持。这意味着所有 API 都有了机器可读的描述,使我们能够复用现有的语言绑定基础设施,甚至免费获得自动生成的参考文档。

本版本为 Gum 添加了大量注解和文档字符串,我们比以往任何时候都更接近自动生成参考文档。在适合发布生成的文档之前仍有一些工作要做,但已经不远了。如果有人愿意参与,请查看 Gum 的 CI,并留意 GObject Introspection 输出的警告。

Meson 子项目支持

我非常喜欢 Meson 构建系统的一点是它支持子项目。Gum 现在可以作为子项目使用。你们有些人可能已经通过 devkit 二进制文件使用 Gum,现在又有了一个更加简便的新选择。

与使用 devkit 相比,主要优势是所有内容都从源代码构建,因此很容易试验代码。

假设有一个 hello.c 文件,内容如下:

#define _GNU_SOURCE
#include <dlfcn.h>
#include <fcntl.h>
#include <gum.h>
#include <stdio.h>
#include <unistd.h>

static int (* open_impl) (const char * path, int oflag, ...);
static int replacement_open (const char * path, int oflag, ...);

int
main (int argc,
      char * argv[])
{
  gum_init ();

  GumInterceptor * interceptor = gum_interceptor_obtain ();

  gum_interceptor_begin_transaction (interceptor);

  open_impl = dlsym (RTLD_DEFAULT, "open");
  gum_interceptor_replace (interceptor, open_impl, replacement_open,
      NULL, NULL);

  gum_interceptor_end_transaction (interceptor);

  close (open_impl ("/etc/hosts", O_RDONLY));
  close (open_impl ("/etc/fstab", O_RDONLY));

  return 0;
}

static int
replacement_open (const char * path,
                  int oflag,
                  ...)
{
  printf ("!!! open(\"%s\", 0x%x)\n", path, oflag);

  return open_impl (path, oflag);
}

为了构建它,可以在旁边创建包含以下内容的 meson.build:

project('hello', 'c')
gum = dependency('frida-gum-1.0')
executable('hello', 'hello.c', dependencies: [gum])

再创建 subprojects/frida-gum.wrap,内容如下:

[wrap-git]
url = https://github.com/frida/frida-gum.git
revision = main
depth = 1

[provide]
dependency_names = frida-gum-1.0, frida-gum-heap-1.0, frida-gum-prof-1.0, frida-gumjs-1.0

如果尚未安装 Meson 和 Ninja,请运行 pip install meson ninja。

然后进行构建并运行:

$ meson setup build
$ meson compile -C build
$ ./build/hello
!!! open("/etc/hosts", 0x0)
!!! open("/etc/fstab", 0x0)

体积

我们投入了大量精力,确保 Frida 能从桌面系统一直扩展到嵌入式系统。本版本中,我花了一些时间分析二进制体积,并据此做出大量调整、添加构建选项来减小体积。

我很好奇,只使用 Interceptor 的 Gum Hello World 程序最小能做到多小。最终结果在使用 Thumb 指令的 32 位 ARM 上测得,其中 Gum 及其依赖静态链接,唯一的外部依赖是系统 libc。

结果小到只有 55K(!),让我非常兴奋。我在 Gum、GLib 和 Capstone 中引入了新的构建选项。Gum 现在支持 “diet” 模式,不使用 GObject,只提供普通 C API。这意味着它不支持 GObject Introspection 和高级语言绑定,也不提供完整 Gum API,不过未来可以继续扩展。

类似地,GLib 也新增了 “diet” 模式,主要是禁用 slice 分配器、调试功能,并做一些其他小调整。

对于 Capstone,我引入了一个可设为 “tiny” 的新 “profile” 选项。启用后,Capstone 只理解足以确定每条指令长度的指令集内容,并提供一些与位置相关指令的细节。其思路是仅支持 Relocator 实现所需的能力,因为 Interceptor 和 Stalker 背后的大部分繁重工作都由它们完成。

除非确实需要如此小的体积,否则我不建议使用这些构建选项;但了解能够做到什么仍然很有价值。我们也提供其他不那么极端的选项,详情请阅读体积文档。

多构建系统之苦

自 Frida 诞生以来一直困扰我的一件事是,构建 Frida 需要与多个构建系统打交道。我们当然会尽量把复杂性隐藏在脚本和 makefile 后面,但总会有用户不得不费力弄清 Frida 为何无法构建,并因此感到沮丧。

有些人还希望为略有不同的 libc、工具链或其他环境交叉编译 Frida,甚至可能想支持尚未支持的操作系统。但当他们意识到需要处理四种不同构建系统——Meson、autotools、自定义 Perl 脚本(OpenSSL)和 GN(V8)——时,很可能立刻失去动力。

我们是 Meson 的满意用户,因此我的目标是“让一切 Meson 化!”到本版本为止,我们终于基本实现所有必需依赖都使用 Meson 构建。唯一的例外是 V8,但希望有一天也能用 Meson 构建它。(来自未来的剧透:Frida 16 会实现这一目标!)

结束语

此外还有许多令人兴奋的变化,请务必查看下面的变更日志。

祝使用愉快!

变更日志

  • 添加 FreeBSD 支持。
  • 添加 ARMv4 支持,用于为旧式嵌入式系统插桩。
  • 添加减小二进制体积的构建选项(参见 config.mk)。
  • 调整 Capstone 和 GLib,以实现小得多的二进制体积。
  • droidy:添加 AXML 解码器。感谢 @meme!
  • windows:修复 dbghelp 回溯器对 libffi frame 的支持。
  • linux:修复与新版 glibc 的兼容性。
  • linux:安装资源后只使用一个 frida-helper。
  • qnx:注入器关闭时移除临时文件。
  • core:修复取消 agent 清理时的泄漏。
  • gumjs:修复返回 null 的 RPC 调用处理。
  • interceptor:无法分配 “JMP ” 可达内存时,按需在 x86 上使用 “jumbo” JMP。
  • interceptor:生成可变大小的 x86 NOP 填充。
  • stalker:将近期用于优化 x86/64 后端的思路应用于 arm64 后端,例如改进局部性和内联缓存,从而提升性能。
  • stalker:修复大小为零的 freeze/thaw() 处理。
  • stalker:重做 x86 PLT 排除代码,避免跟踪期间的重入问题。
  • stalker:不再要求存在 C++ 运行时。
  • arm-writer:添加 put_bl_reg()、put_call_reg()。
  • arm-writer:修复 put_call_address*() 中的寄存器破坏。
  • arm64-reader:公开 disassemble_instruction_at()。
  • arm64-writer:修复混合宽度字面量的处理。
  • arm64-writer:修复 TBZ/TBNZ 编码。
  • arm64-writer:修复 32 位系统上的 put_and_reg_reg_imm()。
  • arm64-writer:添加 put_{ldr,str}_reg_reg_offset_mode()。
  • elf-module:公开更多细节,添加离线模式支持和 Vala 绑定。
  • exceptor:添加 reset() 以恢复异常处理程序。
  • gum:添加大量 GObject Introspection 注解和 API 文档。
  • gum:支持作为 Meson 子项目使用。
  • gum:将 Meson 构建系统移植到 Windows。
  • gum:消除 GIO 依赖。
  • gum:添加 diet 模式,使使用 Interceptor 的 “Hello World” C 程序在采用 Thumb 指令的 32 位 ARM 上可小至 55K。
  • gum:添加 CI。感谢 @meme!
  • 对构建系统进行多项可移植性改进。
  • 使用 Meson 构建 elfutils、libiconv、libdwarf、libunwind、openssl、xz。
  • 升级依赖:capstone、elfutils、libdwarf、libunwind。
  • 发布 Fedora 35 而非 34 的软件包。
  • python:使用 PEP 503 代替 PyPI xmlrpc。感谢 @GalaxySnail!
  • python:修复 Windows 上对 Python >= 3.10 的支持。

Frida 15.1 发布

隆重介绍_全新的_ Swift 桥接!Swift 从版本 5 起已实现 ABI 稳定,这个期待已久的桥接让 Frida 能够很好地配合 Swift 编写的二进制文件。无论你认为 Swift 是静态语言还是动态语言,有一点可以确定:随着这个 Frida 版本发布,它变得动态多了。

元数据

逆向工程师开始分析二进制文件时,通常首先要了解其中定义的各种数据结构。因此,最合理的起点是构建与 ObjC.classes 和 ObjC.protocols API 对应的 Swift 能力。不过 Swift 还有结构体、枚举等一等类型,而且 Swift 运行时并未提供 Objective-C 意义上的反射原语,所以我们必须挖得更深一些。

幸运的是,Swift 编译器会为二进制文件定义的每种类型生成元数据。撰写本文时,这些元数据封装在 include/swift/ABI/Metadata.h 中定义的 C++ 结构体 TargetTypeContextDescriptor 里。该数据结构包含类型名称、字段、方法(如适用),以及取决于具体类型的其他有用数据。这些数据结构由相对指针引用(定义于 include/swift/Basic/RelativePointer.h)。在 Mach-O 二进制文件中,它们存放在 __swift5_types 节。

因此,为了转储类型,Frida 基本上会遍历这些数据结构并逐一解析,与 dsdump 的做法非常相似;区别在于你无需构建 Swift 编译器即可进行实验。

Frida 还有一个优势:能够探查用 Swift 编写的 Apple 内部 dylib。得益于私有 getsectiondata API,我们无需解析 dyld_shared_cache,即可轻松获得节偏移。

获得元数据后,就能轻松为对象实例和不同类型的值创建 JavaScript 包装器。

调用约定

为了与 Objective-C 桥接能力相当,Swift 桥接必须支持调用 Swift 函数,而事实证明这同样并不简单。

Swift 定义了自己的调用约定 swiftcall。简而言之,它力求尽可能高效:对于大小不超过 4 个寄存器容量的结构体,不浪费加载和存储指令,而是直接通过寄存器传递。由于这很快会占满宝贵的 8 个参数寄存器(AARCH64 上为 x0–x7),它不使用第一个寄存器传递 self 参数。此外还定义了 error 寄存器,供被调用方保存其抛出的错误。

上述过程在 Swift 编译器文档中称为“物理降级”,由后端 LLVM 实现。

物理降级之前的过程称为“语义降级”,即编译器前端确定值由谁“拥有”,以及采用直接还是间接方式传递。有些结构体即使小于 4 个寄存器,也必须间接传递;例如泛型结构体在编译时无法确定精确内存布局,或者其中包含必须始终位于内存中的弱引用。

为了调用 Swift 函数,我们必须同时实现语义降级和物理降级。物理降级通过 JIT 编译的适配函数实现(得益于 Arm64Writer API),负责必要的 SystemV–swiftcall 转换。语义降级则利用类型元数据判断值是否应直接传递。

编译器文档是深入了解该调用约定的绝佳资料。

拦截

由于 Swift 直接通过寄存器传递结构体,寄存器与实际参数之间并非一一对应。

既然已经拥有类型的 JavaScript 包装器,也能从 JS 运行时调用 Swift 函数,合理的下一步就是扩展 Interceptor 以支持 Swift 函数。

对于未剥离符号的函数,我们使用简单的正则表达式解析参数类型和名称,返回值也同样处理。解析完成后,获取类型元数据并确定类型布局,再为每个参数构造 JS 包装器,把 Swift 参数值传给它,无论该值占用多少个寄存器。

结语

请注意,该桥接仍处于非常早期的开发阶段,因此:

  • 目前仅支持 Darwin arm64(e)。
  • 性能尚未达到最佳状态,部分边界情况可能处理不当,出现一些错误也属预期。
  • API 在短期到中期内可能发生破坏性变更。
  • 非常欢迎提交 PR 和 issue!

有关当前 API 的最新资料,请参阅文档。

尽情体验吧!

15.1.0 的变更

  • 实现 Swift 桥接,使 Frida 能够:
    • 浏览 Swift 模块及其中实现的类型,包括类、结构体、枚举和协议。
    • 为对象实例和值创建 JavaScript 包装器。
    • 从 JavaScript 运行时调用采用 swiftcall 调用约定的函数。
    • 拦截 Swift 函数并自动解析其参数和返回值。
  • 修复 i/macOS 回归:与 iOS 15 支持相关的改动破坏了附加到 Apple 系统守护进程的能力。
  • gadget:在 connect 模式中新增 interaction.parameters;这些参数会“反映”到应用信息的 parameters.config 下。感谢 @mrmacete!

15.1.1 的变更

  • gumjs:修复 V8 运行时中的 Swift 生命周期逻辑。

15.1.2 的变更

  • control-service:修复信号连接,使 Device.output 等信号能由远程 frida-server 正确发出。感谢 @mrmacete!
  • gadget:修复在 Frida 15 前期重构中遗漏的“runtime”选项。
  • relocator:优化 x86 RIP 相对代码的处理,在可行时仅调整偏移。
  • gumjs:新增 ESM 支持,让 frida-compile 等工具能输出更好的代码。
  • gumjs:解析后丢弃源代码。
  • gumjs:修复编译为 QuickJS 字节码时的泄漏。
  • java:公开 JNIEnv->GetDirectBufferAddress。感谢 @pandasauce!

15.1.3 的变更

  • objc:修复 Proxy 的 respondsToSelector 实现。感谢 @hot3eed!
  • gumjs:修复缺少模块时 V8 运行时崩溃。
  • gumjs:发出 ESM 入口点抛出的 V8 异常。

15.1.4 的变更

  • gumjs:修复 QuickJS 运行时中与弱引用回调有关的重复释放。感谢 @mrmacete!
  • gumjs:在无关的 NativeCallback 调用中忽略 Interceptor 上下文,从而安全忽略调用栈上层的无效 Interceptor 上下文,改用最小但正确的回调上下文。感谢 @mrmacete!
  • gumjs:修复 ESM 模块名称规范化逻辑。
  • gumjs:新增 Process 的 cwd、home 和 tmp 目录 getter。
  • swift:将元数据缓存性能提升约 3 倍。感谢 @hot3eed!
  • node:发布 v15 而非 v13 的 Electron 预构建包。

15.1.5 的变更

  • gumjs:修复 QuickJS 将大数字转换为字符串时的崩溃。感谢 @vfsfitvnm!
  • gumjs:向 CModule 公开 GError 和 GIConv。感谢 @0xDC00!
  • droidy:支持 ADB 服务器主机/端口环境变量。感谢 @amirpeles90!
  • swift:改进非 Darwin 平台上的加载行为。

15.1.6 的变更

  • swift:修复非 Darwin 平台加载期间的崩溃。感谢 @hot3eed!

15.1.7 的变更

  • swift:修复旧版操作系统上的 CoreSymbolication 集成。感谢 @hot3eed!
  • python:为 Android/ARM 新增 setup.py 下载逻辑;不过 CI 尚未构建并上传此类二进制文件。

15.1.8 的变更

  • darwin:支持在 SRD 环境中工作。感谢 @Nessphoro!
  • darwin:支持使用较新的 iOS SDK 构建。

15.1.9 的变更

  • x86-relocator:修复 RIP 相对指令的补丁。这是 15.1.2 引入的回归,会导致 Stalker 不可靠。
  • portal-service:只要从 PortalService 清除会话 ID,就始终移除 ClusterNode 会话,从而避免 NULL 解引用和泄漏。感谢 @mrmacete!
  • frida-portal:修复 –help 输出中的拼写错误。

15.1.10 的变更

  • p2p:妥善处理不受支持的 ICE candidate。
  • p2p:暂时禁用 ICE-TCP。
  • p2p:重构 PeerSocket,修复同步问题。
  • socket:修复 WebService 拆卸。
  • vala:优化服务器端 GDBus 回复处理,使 RPC 和网络协议减少往返并提升性能。
  • x86-writer:在间接分支之后或内部加入 UD2 指令。
  • x86-writer:尽可能生成更大的 NOP。
  • stalker:提升 x86/64 后端性能。
  • objc-api-resolver:防范已释放的 ObjC 类。感谢 @mrmacete!
  • gumjs:修复 V8 Interceptor.{replace,revert}() 回归。感谢 @3vilWind!
  • gumjs:用 regsAccessed 和 operand.access 扩展 Instruction API。感谢 @3vilWind!

15.1.11 的变更

  • x86-writer:新增 put_sahf() 和 put_lahf()。
  • x86-relocator:修复超出范围的 Jcc 分支目标处理。感谢 @0xDC00!
  • stalker:优化目标地址获取。
  • stalker:避免高开销的 XCHG 指令。
  • stalker:优化 IC 序言以使用 SAHF/LAHF。
  • memory:改进 scan(),支持正则表达式 pattern。感谢 @hot3eed!
  • kernel:在支持的平台上从 all_image_info 获取基址。感谢 @mrmacete!
  • windows:提升 dbghelp 回溯器可靠性。感谢 @HonicRoku!

15.1.12 的变更

  • agent:修复卸载时遇到 NO_REPLY_EXPECTED 调用而挂起的问题;此前仍会等待回复。由于服务器端 DBus 代码由 Vala 编译器生成,且它之前(Frida <= 15.1.9)会忽略 NO_REPLY_EXPECTED,这个错误一直未被发现。
  • android:迁移到 NDK r24 Beta 1。

15.1.13 的变更

  • linux:改进 glibc 系统上的模块解析。
  • fruity:修复 dyld v4 情况下的 spawn(未越狱 iOS 15.x)。感谢 @mrmacete!
  • objc-api-resolver:通过互斥锁防范 objc_disposeClassPair()。感谢 @mrmacete!
  • gumjs:更新 Kernel.scan*(),使其与 Memory.scan*() 一致。感谢 @hot3eed!
  • stalker:修复 x86 上生成的分支操作码。
  • stalker:修复 Thumb IT AL 处理。
  • stalker:在 x86 上通过 PLT 处理被排除的 Linux 调用。
  • stalker:修复 x86 上的 Linux 异常处理。
  • java:新增 Java.backtrace(),目前不保证 API 稳定性。

15.1.14 的变更

  • backtracer:改进模糊回溯器,使其包含直接调用者,并在已知栈末尾时避免越界遍历。
  • windows:实现 Thread.try_get_ranges()。
  • linux:实现 Thread.try_get_ranges()。
  • ios:在 SRD 系统上向 launchd 登记。
  • stalker:修复 x86 调用深度代码中的意外覆盖。
  • node:同时发布 Node.js v17 的预构建包。

Frida 15.0 发布

发生了太多变化。先从一项重要的新功能说起,本次发布中的大多数其他变更都由它引领:

Portal

第一部分:构想

今年早些时候,@insitusec 和我一起构思如何简化分布式插桩场景。本质上,就是交付 一个“空心”的 Frida Gadget,由后端提供应用专用的插桩逻辑。

一种实现方式是使用 Socket.connect() JavaScript API,然后定义一种应用专用的信令协议, 通过它加载代码,再将代码交给 JavaScript 运行时。

但这种做法很快就会产生大量乏味的胶水代码,而且 frida-trace 等现有工具实际上无法在 这种配置下使用。

这时,@insitusec 提出 Frida Gadget 或许可以提供一种与其 Listen 交互模式相反的 对应模式。这样一来,它不再是公开兼容 frida-server 接口的服务器,而是可以配置成连接 Portal 的客户端。

这样的 Portal 会聚合所有已连接的 Gadget,并公开一个兼容 frida-server 的接口,其中 每个 Gadget 都表现为一个进程。从外部看,它们就像是 Portal 所在机器上的进程:使用 enumerate_processes() 或 frida-ps 时,每个进程都有唯一的进程 ID,而且可以无缝地 对它们执行 attach()。

这样,现有 Frida 工具的工作方式完全不变;在 Portal 上启用 spawn-gating 后,可以指示 任何接入的 Gadget 等待,直到有人应用所需的插桩逻辑并对其调用 resume()。这与其他 场景下 spawn-gating 的工作方式相同。

第二部分:实现

实现它非常有趣,没过多久,第一个 PoC 就运行起来了。不过,弄清所有细节花了一些时间, 最终方案定型如下:

Portal 应该公开两个不同的接口:

  1. Gadget 可以连接的 cluster 接口,使其能够加入集群。
  2. 还可选择提供供控制器通信的 control 接口。例如: frida-trace -H my.portal.com -n Twitter -i open

对用户而言,这非常简单:只需从我们的 releases 获取 frida-portal 二进制文件, 在 Gadget 能够访问的某台机器上运行它,然后将工具指向该地址——就像使用普通 frida-server 一样。

不过,这只是其中一部分,也就是简单场景下的使用方式。frida-portal CLI 程序实际上只是 底层 PortalService 的一层轻量 CLI 包装。这个 CLI 程序只有略多于 200 行代码,其中真正的逻辑很少。

也可以使用 frida-core 的语言绑定(例如 Python 或 Node.js)来实例化 PortalService。 这样可以将它配置为不提供任何控制接口,转而访问它的 device 属性。这是一个标准的 Frida Device 对象,可以对其调用 enumerate_processes()、attach() 等。当然,也可以 同时采用两种方式。

使用 API 还会带来其他功能,稍后我们会回到这些内容。

第三部分:TLS

考虑到在公共互联网上运行 frida-portal 可能非常有用,我们显然也应该支持 TLS。由于其他 功能已经将 glib-networking 作为依赖,因此从体积角度看,添加 TLS 的成本很低。

实现方面,只有客户端需要少量逻辑,服务器端也同样直接。

对于 CLI 工具,只需传入 --certificate=/path/to/pem。服务器需要一个包含公钥和私钥的 PEM 编码文件,并会接受传入客户端的任何证书。客户端同样需要 PEM 编码文件,但其中只需 包含受信任 CA 的公钥;服务器证书必须与该公钥匹配,或由其派生。

在 API 层面,归结为以下代码:

import frida

manager = frida.get_device_manager()
device = manager.add_remote_device("my.portal.com",
                                   certificate="/path/to/pem/or/inline/pem-data")
session = device.attach("Twitter")
…

第四部分:身份验证

与在公共互联网上运行 frida-portal 相伴的另一个显而易见的功能是身份验证。现在,我们的 服务器 CLI 程序和其他 CLI 工具都支持 --token=secret。

在 API 层面也很简单:

import frida

manager = frida.get_device_manager()
device = manager.add_remote_device("my.portal.com",
                                   token="secret")
session = device.attach("Twitter")
…

如果通过 API 实例化 PortalService,事情就有趣得多,因为这样可以轻松接入自定义的 身份验证后端:

import frida

def authenticate(token):
    # Where `token` might be an OAuth access token
    # that is used to grab user details from e.g.
    # GitHub, Twitter, etc.
    user = …

    # Attach some application-specific state to the connection.
    return {
        'name': user.name,
    }

cluster_params = frida.EndpointParameters(authentication=('token', "wow-such-secret"))
control_params = frida.EndpointParameters(authentication=('callback', authenticate))
service = frida.PortalService(cluster_params, control_params)

EndpointParameters 构造函数还支持 address、port、certificate 等其他选项。

第五部分:离线模式

这就引出了下一个挑战:如何处理暂时性的连接问题。我确实在 PortalClient 中实现了 自动重连逻辑,Gadget 正是使用它连接 PortalService。

但即使 Gadget 能重新连接 Portal,在断线期间已加载的脚本该怎么办?如果控制器与 Portal 断开连接,又该怎么办?

现在我们已经有了同时处理这两种情况的方案。不过,它需要主动启用,因此旧行为仍是默认值。

使用方式如下:

session = device.attach("Twitter",
                        persist_timeout=30)

现在,一旦发生连接故障,脚本会继续加载在远端,但发出的所有消息都会进入队列。在上面的 示例中,客户端有 30 秒可以重新连接;超时后脚本会被卸载,数据也会丢失。

控制器可以订阅 Session.detached 信号来处理这种情况:

def on_detached(reason, crash):
    if reason == 'connection-terminated':
        # Oops. Better call session.resume()

session.on('detached', on_detached)

一旦 session.resume() 成功,所有缓冲的消息都会送达,一切恢复正常。

上面的示例略过了一些细节,例如当前 Python 绑定较为棘手的线程约束;完整示例请参阅 此处。(等我们将 Python 绑定从同步 API 迁移到 async/await 后,事情会简单很多。)

第六部分:延迟与瓶颈

接下来,假设 Portal 运行在美国的数据中心,Gadget 位于西班牙朋友的住处,而我正在挪威 使用 frida-trace 控制它。如果来自西班牙的脚本消息必须横跨大西洋两次,那就太糟糕了; 问题不仅在于延迟,还在于我下个月要付的 AWS 账单。因为我正在转储内存,这会产生大量流量。

这个问题稍难一些,不过有了 libnice——一个基于 GLib 构建的轻量、成熟的 ICE 实现——我们可以直接使用它。GLib 已经是技术栈的一部分:它是我们进行 C 编程的标准库, 而 Vala 代码也会编译为依赖 GLib 的 C 代码,因此非常契合。从体积角度看,这也是个好消息。

作为用户,只需传入 --p2p 并指定 STUN 服务器:

$ frida-trace \
    -H my.portal.com \
    --p2p \
    --stun-server=my.stunserver.com \
    -n Twitter \
    -i open

(也支持 TURN 中继。)

API 端的用法如下:

session.setup_peer_connection(stun_server="my.stunserver.com")

就是这么简单!

第七部分:只有 Gadget 能参加吗?

你可能已经注意到,Gadget 一直是到目前为止反复出现的主题。我不愿意添加只适用于某一种 模式的功能,例如只支持 Injected 模式而不支持 Embedded 模式。因此我很早就 意识到,Portal 必须是一项普遍可用的功能。

假设我的朋友正在意大利家中的客厅里逆向 iPhone 上的目标,而我也想参与,他可以运行:

$ frida-join -U ReversingTarget my.portal.com cert.pem secret

现在我就可以通过 Frida REPL 加入:

$ frida \
    -H my.portal.com \
    --certificate=cert.pem \
    --token=secret \
    --p2p \
    --stun-server=my.stunserver.com \
    -n ReversingTarget

如果朋友想通过 API 加入 Portal,可以这样做:

session = frida.get_usb_device().attach("ReversingTarget")
membership = session.join_portal("my.portal.com",
                                 certificate="/path/to/cert.pem",
                                 token="secret")

第八部分:Web

早在 Frida 诞生之前,我就一直想构建一款在线协作逆向应用。在 Frida 项目刚起步时, 我做过一个集成聊天、控制台等功能的桌面 GUI。然而,有限的业余时间成了难题,因此最终 我删掉了 GUI 代码,决定专注于 API。

如今已是 2021 年,单页应用(SPA)在许多场景下都非常有吸引力。我也注意到已经有不少 基于 Frida 构建的 SPA,这令人十分兴奋!但我自己尝试 SPA 时发现,编写中间件相当繁琐。

为了容纳前面介绍的功能,Frida 15 必须修改一些协议,因此现在似乎也是彻底打破协议、 提升主版本号的合适时机。我一直尽量避免这样做,因为我知道这对所有人都很痛苦,包括我自己。

现在,浏览器终于也能参与进来,而且不需要任何中间件:

async function start() {
  const ws = wrapEventStream(new WebSocket(`ws://${location.host}/ws`));
  const bus = dbus.peerBus(ws, {
    authMethods: [],
  });

  const hostSessionObj = await bus.getProxyObject('re.frida.HostSession15',
      '/re/frida/HostSession');
  const hostSession = hostSessionObj.getInterface('re.frida.HostSession15');

  const processes: HostProcessInfo[] = await hostSession.enumerateProcesses({});
  console.log('Got processes:', processes);

  const target = processes.find(([, name]) => name === 'hello2');
  if (target === undefined) {
    throw new Error('Target process not found');
  }
  const [pid] = target;
  console.log('Got PID:', pid);

  const sessionId = await hostSession.attach(pid, {
    'persist-timeout': new Variant('u', 30)
  });
  …
}

(完整示例位于 examples/web_client。)

这意味着 Frida 的网络协议现在基于 WebSocket,因此浏览器终于可以直接与运行中的 Portal/frida-server 通信,中间无需任何中间件或网关。

不过,我不想只做个半成品,因此确保点对点实现基于 WebRTC 数据通道。这样,即使是浏览器也能以最低延迟通信,还有助于降低 AWS 账单。

第九部分:静态资源

当我们为 Portal 构建了 Web 应用后,由于 Portal 原生使用 WebSocket,也就同时支持 HTTP,因此可以非常轻松地从同一服务器提供该 SPA:

$ ./frida-portal --asset-root=/path/to/web/app

在 API 层面也很简单:

control_params = frida.EndpointParameters(asset_root="/path/to/web/app")
service = frida.PortalService(cluster_params, control_params)

第十部分:协作

拥有控制器(比如 Web 应用)之后,自然的下一步就是加入协作功能,让该 SPA 的多个运行 实例能够相互通信。

既然控制器与 PortalService 之间已经存在 TCP 连接,那么让开发者也使用这条通道几乎 不增加成本。在许多场景中,额外增加一条信令通道会带来大量本可避免的复杂性。

新的 Bus API 正是在这里派上用场:

import frida

def on_message(message, data):
    # TODO: Handle incoming message.
    pass

manager = frida.get_device_manager()
device = manager.add_remote_device("my.portal.com")
bus = device.bus

bus.on('message', on_message)
bus.attach()

bus.post({
    'type': 'rename',
    'address': "0x1234",
    'name': "EncryptPacket"
})
bus.post({
    'type': 'chat',
    'text': "Hey, check out EncryptPacket everybody"
})

这里首先附加消息处理程序,以便接收来自 Portal 的消息。

然后调用 attach(),让 Portal 知道我们希望与它通信。(我们不希望它向不使用 Bus 的 控制器发送消息,例如 frida-trace。)

最后,我们通过 post() 发送两种不同类型的消息。如何处理由 PortalService 决定。

这意味着远程 PortalService 需要通过 API 实例化,因为必须处理传入消息——Portal 不会 自行将消息转发给其他控制器。

不过不用担心,实现起来很简单:

import frida
import sys

def on_message(connection_id, message, data):
    # TODO: Handle incoming message.
    pass

cluster_params = frida.EndpointParameters()
control_params = frida.EndpointParameters()
service = frida.PortalService(cluster_params, control_params)
service.on('message', on_message)
service.start()

sys.stdin.read()

on_message() 应检查 message 并决定如何处理。

它可以选择回复发送消息的控制器:

service.post(connection_id, {
    'type': 'rename-rejected',
    'reason': "Not authorized"
})

另一个实用做法是,每当有人对其 Bus 对象调用 attach() 时发送欢迎消息:

def on_subscribe(connection_id):
    service.post(connection_id, {
        'type': 'welcome',
        'users': [user.nick for user in connected_users]
    })

service.on('subscribe', on_subscribe)

根据应用需求,你可能还需要向所有已附加到 Bus 的控制器广播消息:

service.broadcast({
    'type': 'announce',
    'text': "Important Service Announcement"
})

也可以通过 narrowcast() 向一部分控制器发送消息:

service.narrowcast("#reversing", {
    'type': 'chat',
    'sender': user.nick,
    'text': "Hello everyone"
})

这意味着,任何带有 #reversing 标签的控制器连接都会收到该消息。标签的设置方式如下:

service.tag(connection_id, "#reversing")

随后可以根据操作添加这些标签,例如控制器发送“join”消息加入频道。也可以根据身份验证 应用标签,例如只让属于某个 GitHub 组织的连接收到消息。

最后,在集群端加入 Portal 时还可以指定访问控制列表(ACL)。ACL 是字符串数组,其中 指定的标签会授予控制器发现给定进程并与之交互的权限。这意味着,对于每个应获准访问某个 节点或节点组的控制器,都需要使用 service.tag()。

基本就是这些。更完整的示例请参阅 examples/portal_server.py 和 examples/portal_client.py,它们实现了一个类似 IRC 的聊天服务。

系统参数

五月时,我与 @Hexploitable 聊过。他当时正在开发一款工具,需要根据设备运行的是 iOS 还是 Android 来选择 Device 对象。过去也有人提出过这项功能,现在似乎终于到了 解决它的时候。

虽然可以执行 device.attach(0),在系统会话中加载脚本,从而在 Frida 自身内部运行代码 (例如远程 frida-server 中),但这样做比较繁琐。如果 Device 代表受限/未 root 的设备, 这种方式也无法工作,因为那里的代码执行受到更多限制。

经过一番讨论,@Hexploitable 开始实现这项功能,并很快做出了可以工作的初稿。之后我又 加以完善,并在 Portal 功能最终落地后不久将其合并。

该 API 很简单,未来也易于扩展:

$ python3 -c 'import frida; import json; \
    print(json.dumps(frida.query_system_parameters()))' \
    | jq

macOS 设备

如果附加一台受限的 iOS 设备,也可以对其进行查询:

$ python3 -c 'import frida; import json; \
    device = frida.get_usb_device(); \
    print(json.dumps(device.query_system_parameters()))' \
    | jq

iOS 设备

这里需要注意一个重要细节:access: 'jailed'。通过它可以判断当前是在使用我们对受限 iOS/Android 系统的支持(也就是只能访问可调试应用),还是确实在与远程 frida-server 通信——后者由 access: 'full' 表示。

Android 上的内容还没这么丰富(欢迎提交 PR!),但仍有许多实用信息:

Android 设备

如果 Linux 发行版符合 LSB,我们还能识别其具体发行版:

Ubuntu 设备

最后还有 Windows:

Windows 设备

应用和进程参数

另一个在即兴交流后逐渐成形的好点子,源于 @pancake 告诉我:如果能知道已安装 iOS 应用的具体版本,会非常有用。

开发 Portal 功能时,我已经从许多方面打破了协议,所以现在似乎也是继续调整的好时机, 从而避免未来再次痛苦地提升主版本号。

快进到实现完成:Application 和 Process 对象不再包含 small_icon 或 large_icon 属性,取而代之的是一个 parameters 字典。

默认调用 enumerate_applications() 时,看起来仍很熟悉:

enumerate_applications()

但改为 enumerate_applications(scope='metadata') 后,内容就丰富多了:

enumerate_applications(scope='metadata')

这里可以看到 iOS Twitter 应用的版本和构建号、应用 bundle 在文件系统中的位置、它所 拥有的容器、它当前是否为最前端应用、它在多久以前启动等信息。

还可以进一步使用 enumerate_applications(scope='full'),同时获取图标:

enumerate_applications(scope='full')

如果 query_system_parameters() 报告 access: 'jailed',debuggable: true 参数就非常有用,因为你的应用可能需要筛选应用列表,只显示能够 spawn() 和/或 attach() 的应用,或者更突出地显示可调试应用,以提供更好的用户体验。

另外值得一提的是,get_frontmost_application() 现在也支持传入 scope。

熟悉旧 API 的读者可能已经注意到,图标现在可以用压缩后的 PNG 形式传输。过去传输的 始终是未压缩的 RGBA 数据,iOS 端会执行 PNG 解码,并缩小为两种固定分辨率(16x16 和 32x32)。

这一切意味着,为了包含图标,我们会浪费大量 CPU 时间、内存和带宽,即便数据最终进入 一个根本不会使用图标的 CLI 工具。现在使用 Frida 15 时,你可能会发现列出应用和进程 快了很多。即使确实请求图标,也应该比以前更快,因为不再进行解压和缩放。

以上是应用列表。上述改进同样适用于进程列表,现在的 enumerate_applications(scope='full') 可能如下所示:

enumerate_processes(scope='full')

这里还可以清楚看到 Twitter 应用当前位于最前端、其父进程是 launchd(PID 1)、运行它的 用户、启动时间等信息。

你可能会疑惑为什么 applications 是数组。Android 上的示例最能说明原因:

enumerate_processes(scope='full')

“com.android.phone”进程实际上承载了六个不同的“应用”!

当然,我也没有忘记 Windows:

enumerate_processes(scope='full')

这就是“scope”选项。另外还有一个面向 UI 的选项。UI 可能希望快速获取应用/进程列表, 只有当用户与特定条目交互,或将一部分条目滚动到可见区域时,才真正需要元数据/图标。 现在我们提供了一个选项来支持这类场景。

假设只想获取两个特定应用的元数据,现在可以这样做:

ids = [
    "com.atebits.Tweetie2",
    "no.sparebank1.mobilbank"
]
apps = device.enumerate_applications(identifiers=ids,
                                     scope='full')

enumerate_applications(identifiers=x)

进程列表也支持同样的功能,用法如下:

processes = device.enumerate_processes(pids=[1337, 1338],
                                       scope='full')

Portal 与应用/进程参数

介绍完应用参数和 Portal 后,还有一个重要细节值得说明:PortalService 会呈现来自 任意数量(可能位于远程)的系统中的进程,因此在其中实现 query_system_parameters() 意义不大。我们可以使用应用/进程参数来填补这一空缺。

这意味着,对于来自 PortalService 的任何 Application 和 Process,如果 scope 设为 metadata 或 full,都会提供名为 system 的参数,其中包含该特定应用/进程的系统 参数。这样,应用仍可提前判断自己是否关注某个进程。

受限 iOS 与 Android 改进

实现 Application 和 Process 参数功能非常有趣,我也尝试尽可能缩小受限(未 root)与 越狱(已 root)设备之间的差距。例如在 Android 上,未 root 代码路径过去甚至不会获取 应用标签。这是因为我们依赖通过 ADB 运行 shell 命令,而我找不到在这种情况下获取标签的 方法。

shell 命令方案非常脆弱,因为大多数工具输出详情时采用的是供人阅读而非机器处理的格式。 显然,这类输出很可能随着 Android 的演进而变化。

因此,我们现在会复制并运行一个很小的预构建 .dex;获取元数据只需向该辅助进程发出 RPC 调用。这样,我们能够为未 root 设备提供与已 root 场景相同的全部详情;后者会在 Android 端运行 frida-server。

另一点值得一提:我们不再将 Android 启动器视为最前端应用。现在这与 iOS 上的行为一致, 在那里 SpringBoard 从不会被视为最前端应用。

作为这些重大变更的一部分,我还添加了在 Android 上获取图标的代码,同时支持未 root 和 已 root 设备。因此,这项功能不再局限于 iOS、macOS 和 Windows。

受限 iOS 过去也不提供图标,但这项功能缺口现在已经补上。不过,受限和越狱 iOS 之间仍有 一项区别:受限场景中无法获得 ppid 和 user 参数,因为据我所知,目前没有任何 lockdown/DTX API 公开这些信息。除此之外,整体状况已经相当不错。

i/macOS 回溯能力大幅提升

得益于 @hot3eed 提交的一项令人兴奋的拉取请求,我们现在拥有使用 Objective-C 运行时的 i/macOS 符号化后备方案。这样一来,系统或许能够将 module!0x1234 解析为 Objective-C 方法,而不只是显示偏移地址。太棒了!

@mrmacete 还带来了另一项出色贡献:NativeCallback 现在始终公开上下文,因此可以 调用 Thread.backtrace(this.context),并预期它在所有情况下都能正常工作。

过去,只有将 NativeCallback 用作 Interceptor 替代项时才能做到这一点。因此,如果使用 ObjC.implement() 调配 Objective-C API,实际上无法从该 NativeCallback 捕获回溯。 这是一项令人振奋的改进!

Android 上未解压的原生库

在 Android 上使用 Frida 时,你可能遇到过原生库并不位于文件系统中,而是直接从应用 .apk 加载的应用。得益于 @P-Sc 的出色贡献,我们现在能够透明支持这种情况——无需 修改现有插桩代码。

操作系统支持升级

现在也支持 macOS Monterey、iOS 15 和 Android 12 的最新测试版。特别感谢 Corellium 的 @alexhude 协助调试和测试 iOS 15,也感谢 @pengzhangdev 为 frida-java-bridge 提交修复,以支持 Android 12。

联网的 iOS 设备

另一个多次被请求的功能是支持联网的 iOS 设备。如果你不想让 iPhone/iPad 整天插着线、 损耗电池,这项功能会非常实用。它的好处在于“开箱即用”——运行 frida-ls-devices 时 应该就能看到这些设备。

只有两个需要注意的陷阱。如果联网的 iOS 设备既能通过网络访问,又同时插着线,那么现在 可能会出现两个 ID 相同的不同 Device 对象。

例如:

$ frida-ls-devices
Id                         Type    Name
-------------------------  ------  -------------------------------------
local                      local   Local System
00008027-xxxxxxxxxxxxxxxx  usb     iPad
socket                     remote  Local Socket
00008027-xxxxxxxxxxxxxxxx  remote  iOS Device [fe80::146f:75af:d79:630c]

因此,如果使用 -U 或 frida.get_usb_device(),行为会与以前一样,通过 USB 使用 设备。但如果想使用联网设备,按 ID 解析时 USB 条目会优先,因为它在设备列表中通常位于 联网设备之前。

这意味着还需要检查设备的 type。CLI 工具尚未提供用于执行此操作的开关;如果有人 感兴趣,我们非常欢迎相关拉取请求!

第二个陷阱是,frida-server 默认只监听环回接口,因此无法通过网络连接。如果手动或通过 Cydia 使用我们的 iOS .deb,就必须编辑 /Library/LaunchDaemons/re.frida.server.plist 添加 --listen 开关,再使用 launchctl 重启服务。

根据你对网络环境的信任程度,这种情况下可能还需要使用前面提到的新 TLS 和身份验证功能。

结语

此外还有许多令人兴奋的变更,请务必查看下面的变更日志。

尽情使用吧!

15.0.0 变更

  • 引入 PortalService API 和守护进程。这项网络服务用于编排由 Frida 插桩的远程进程 集群,同时实现兼容 frida-server 的控制接口,以及供目标进程中的 Agent 和 Gadget 通信的集群接口。已连接的控制器可以像枚举 Portal 所在系统的本地进程一样枚举这些 进程,并可执行 attach(),也可启用 spawn-gating 来应用早期插桩。
  • 添加 Session.join_portal(),方便与远程 PortalService 共享进程控制权,并与其他 节点一起加入其集群。
  • 为 frida-gadget 添加“connect”交互,使其也能加入 PortalService 集群。
  • 添加 PortalClient,用于实现 Session.join_portal() 和 frida-gadget 的“connect”交互。 它会连接 PortalService 并加入集群,在发生暂时性故障时自动重连。还支持指定 ACL, 即一组标签;PortalService 要求已连接控制器至少拥有其中一个标签。应用负责根据身份 验证等条件为控制器添加标签。
  • 添加 Device.bus API,让连接到 PortalService 的客户端能够与其交换应用专用消息。 需要通过 API 实例化服务,才能接入消息处理程序和协议逻辑。
  • 添加 Session 持久化支持。在 attach() 到进程时指定非零“persist_timeout”选项即可 启用。服务器之后检测到拥有该会话的客户端断开连接时,会允许脚本继续加载,直到达到 超时时间(秒)。期间发出的所有脚本和调试器消息都会排队;如果客户端在超时前返回, 这些消息稍后会被送达。
  • 添加 TLS 支持,通过指定证书启用。服务器端使用包含公钥和私钥的 PEM,并接受客户端 提供的任何证书。客户端则使用包含受信任 CA 公钥的 PEM,服务器证书必须与其匹配或 由其派生。
  • 添加身份验证支持,通过指定 token 启用。守护进程可通过 CLI 选项指定静态 token, API 则允许接入自定义身份验证后端,也就是说可以按需解释 token。
  • 将网络协议迁移到 WebSocket。
  • 添加协议级保活。
  • 实现兼容 WebRTC Data Channel 的点对点支持,通过对 Session 调用 setup_peer_connection() 启用。这样客户端与远程进程之间可以建立直接连接,适合通过 Portal 等中介与进程通信的场景。
  • 跳过 DBus 身份验证握手,并指示 GDBus 不获取属性,从而优化协议并省下一次往返。
  • 移除已弃用的协议部分,例如 Session.enable_jit()。
  • 添加 Device.query_system_parameters()。感谢 @Hexploitable!
  • 改进应用和进程查询 API。(上文已有详细介绍。)
  • 将 Crash 参数名称改为 kebab-case。
  • 添加 Session.is_detached(),适用于多线程场景:当我们成功连接“detached”信号时, 该信号可能已经发出。
  • 修复 Stalker 对 Linux/x86 上 SYSCALL 指令的处理。
  • 修复 macOS 上的 iPad 设备名称。
  • 当符号缺失但待符号化地址属于 Objective-C 方法时,大幅改进 i/macOS 上的回溯/符号化。 感谢 @hot3eed!
  • 提高回溯器的准确性和灵活性:当 NativeCallback 未用作 Interceptor 替代项时,现在会 为其公开最小上下文。ObjC.implement() 就是一个例子,它用于调配 API。感谢 @mrmacete!
  • 切换到 iOS 所用的映射策略,提高 Interceptor 在 macOS/arm64 上的可靠性。
  • 支持通过网络连接的 iOS 设备。
  • 避免 iOS 上的沙箱检查失败时遗留文件。
  • 修复 Stalker 在使用 checkra1n 越狱的较新 iOS 硬件上的问题。解决方案是暂时禁用 iOS 上的 RWX 支持:即使越狱看起来提供了这项能力,它是否真正有效最终取决于硬件支持哪些 缓解措施。感谢 @stacksmashing 报告问题并帮助我们查明根因!
  • 从 iOS 维护脚本中移除 bash 专用语法,提高越狱兼容性。感谢 @nyuszika7h!
  • 改进 arm64 上的 Interceptor 栈帧布局,使回溯代码能够越过我们生成的代码继续遍历栈。 这也让调试器与 Interceptor 一起使用时更加方便。
  • 修复 ObjC ApiResolver 死锁。问题发生在从 dyld 镜像回调中延迟解析 free() 时,而此时 调用 dlsym() 并不合适。
  • 支持 Android 上未解压的原生库。感谢 @P-Sc!
  • 修复 Android get_frontmost_application() 名称截断。
  • 不再将 Android 启动器视为最前端应用。
  • 如果进程代表 Android 应用的主 UI 进程,则使用应用标签作为进程名称。这终于与 iOS 上的行为保持一致。
  • 改进受限 Android 注入器:现在使用长生命周期的 shell 会话来提速;同时确保放入 /data/local/tmp 的文件名唯一,并清理临时文件。
  • 移除 Firefox OS 支持。
  • 重命名弱引用 API,以免与 ES2021 冲突。WeakRef.bind() 和 WeakRef.unbind() 现分别 改为 Script.bindWeak() 和 Script.unbindWeak()。
  • 将 dlmalloc 自旋锁睡眠时长降为零,大幅提升 Windows 上的内存分配性能;这意味着它只会 让出当前时间片的剩余部分。默认的 50 ms 在线程开始竞争该锁后很容易引入明显延迟。
  • 延迟创建 ScriptScheduler 线程池。这意味着 GumJS 用户可以在真正需要之前避免后台线程。 如果你正在编写需要处理 fork() 的工具或 Agent,这非常有用,无需实现停止线程并在之后 重启的逻辑。(frida-agent 会这样做,但简单场景不一定需要。)
  • Java:支持 Android 12 测试版。感谢 @pengzhangdev!
  • Java:修复 Java.array() 对未加载数组类型的处理。如果应用没有使用该数组类型,它就 不会加载到内存中,而 Java.array() 过去会因此失败。感谢 @yotamN!
  • Java:为原始类型数组添加 toString()。现在会生成由逗号分隔数组值的字符串,而不是 通用的“[Object Object]”字符串。感谢 @yotamN!
  • CModule:补充 32 位 x86 缺失的 TinyCC 内建项。
  • python:添加 Script.is_destroyed 属性。
  • python:添加 Session.is_detached 属性。
  • python:添加 Device.is_lost 属性。
  • python:尝试对已销毁脚本进行 RPC 调用时抛出异常。
  • node:修复与较新 Node.js 版本的兼容性;这些版本要求任意给定 Buffer 的后备存储唯一。 在无法保证同一缓冲区只会被观察一次时,我们直接制作副本。
  • node:修复信号转换回调中的释放后使用问题。
  • node:修复信号连接回调中的释放后使用问题。
  • node:迁移到 C++17,以兼容较新的 Node.js 头文件。
  • node:添加 Script.isDestroyed 属性。
  • node:添加 Device.isLost 属性。

15.0.1 变更

  • 确保 DarwinGrafter 合并 bind 时不会在 __LINKEDIT 中产生间隙,否则会触发 codesign 的错误,导致签名后的二进制文件损坏。感谢 @mrmacete!
  • node:修复使用 MSVC 构建时的编译错误。

15.0.2 变更

  • 修复客户端-服务器和 p2p 场景下的大消息处理。还将 WebSocket 载荷大小上限提高到 256 KiB,与 p2p 模式下数据通道通常协商出的大小相同。
  • 将 WebSocket I/O 移至 DBus 线程,避免不必要的线程切换。
  • 修复使用 p2p 时的泄漏。

15.0.3 变更

  • 为 i/macOS 实现新的 frida-pipe 策略。过去直接在目标进程中设置 Mach 端口的策略会与 受保护 Mach 端口产生问题,因此现在注册一个全局可见的 Mach 服务,让目标进程联系它, 获取 socketpair 的一端。我们还会预先向沙箱查询,并在需要时签发扩展 token。如果无法 向 launchd 注册 Mach 服务,则回退到旧策略。
  • 在 iOS 15 及更高版本上跳过 iOS platformized 检测,因为它与受保护 Mach 端口配合不佳。
  • 将早期插桩移植到 macOS 12 和 iOS 15。
  • 妥善处理 Agent 启动失败:只记录错误并卸载,而不是让目标进程崩溃。
  • Linux:在支持时为 frida-pipe 使用抽象名称。
  • frida-pipe 使用完 UNIX socket 后将其 unlink。
  • 修复 iOS policyd Mach 消息生命周期逻辑。

15.0.4 变更

  • 修复 i/macOS 注入器的数据大小逻辑。该值从一开始就被硬编码,近期入口点数据大小调整 导致它在使用 4K 内存页的系统上损坏。
  • 修复 dyld < 4 上的 i/macOS 早期插桩回归。

15.0.5 变更

  • 修复 dyld >= 4 上的 __CFInitialize() 代码路径。
  • 修复 spawn() 期间的 i/macOS 沙箱扩展逻辑。
  • 将受限 iOS 注入器移植到 iOS 15。
  • 实现 Android USAP 互操作。
  • 改进 DarwinGrafter 的 lazy bind 合并逻辑。感谢 @mrmacete!

15.0.6 变更

  • 修复 Windows 构建回归。

15.0.7 变更

  • 修复 Android 12 上的早期插桩。
  • node:修复 ApplicationParameters 类型定义。感谢报告问题的 @pancake!

15.0.8 变更

  • iOS:支持 unc0ver v6.1.2。
  • iOS:更新 Substrate 互操作逻辑,以支持 0.9.7113。

15.0.9 变更

  • iOS:恢复对旧版操作系统的支持。(已在 iOS 10.3 上验证。)
  • iOS:修复对旧版 Apple usbmuxd 的支持。
  • Android:处理不支持受限模式的设备。
  • 修复 DarwinGrafter 对齐问题:即使 lazy bind 位于常规 bind 之后,也按 16 字节对齐。 感谢 @mrmacete!

15.0.10 变更

  • 修复 Device.open_channel(“lockdown:”) 会立即关闭流的回归。
  • 修复与旧版 ADB 通信时的崩溃。

15.0.11 变更

  • 重写 macOS spawn gating,改用 DTrace。这意味着我们已移除对内核扩展的支持,无需再 担心未来操作系统不再支持扩展;同时也终于支持 Apple Silicon 上的 spawn gating。
  • 规避 i/macOS arm64 早期插桩期间的单步延迟。

15.0.12 变更

  • 修复 macOS spawn gating 的 task port 生命周期问题。不应自作聪明地保留 task port, 因为在 exec 转换后继续使用会引发严重问题。
  • 移除 i/macOS task port 缓存逻辑。它在 exec 转换中很危险,会增加复杂性,而且对性能 的帮助并不大。
  • 将 macOS spawn gating 的 DTrace 谓词环境变量改为可选。
  • 改进 macOS spawn gating 错误消息。

15.0.13 变更

  • 改进客户端,使其指定 Host 请求头并使用 TLS SNI。
  • 撤销 i/macOS 单步延迟规避措施。
  • iOS:修复连接请求中的 usbmux 端口号编码。
  • Python、Node.js:修复 Device.spawn() 辅助选项逻辑中的所有权问题。

15.0.14 变更

  • 将 iOS 崩溃报告器集成移植到 iOS 14.7.1。
  • 将内部 Agent 配置为在 i/macOS 上减少侵入性。
  • 改进 i/macOS 进程准备期间的错误处理。
  • 恢复 i/macOS 单步延迟规避措施,事实证明它仍然必要。
  • 在即将让出 JS 锁时处理可重入情况;如果 Interceptor 在 end_transaction() 期间调用 被替换的函数,就可能发生这种情况。
  • 修复 GumJS 中 Interceptor 的条件式取消忽略逻辑。此前它会阻止 Interceptor 忽略内部 调用,造成噪声并降低性能。
  • 增强 i/macOS DebugSymbol 后备名称,同时包含未滑动地址,方便直接放入静态分析工具。
  • 修复 Stalker 代码 slab 补充逻辑。
  • 添加 Stalker 统计接口。

15.0.15 变更

  • 重构 i/macOS Exceptor,以支持最新 iOS 14。过去每当发生原生异常时都会导致死锁。

15.0.16 变更

  • 修复 i/macOS 在 ARM 上早期插桩期间的单步处理问题,该问题会导致 attach() 对刚刚 spawn() 的进程随机失败。感谢 @mrmacete!
  • 添加 Stalker backpatch 预取支持。
  • 允许在 x86 上配置 Stalker 内联缓存大小。
  • 优化 Stalker x86 返回处理。
  • ObjC:允许代理实现方法。感谢 @hot3eed!

15.0.17 变更

  • gadget:支持在 i/macOS 上打包为 framework。从“Resources/config.json”加载配置, 并相对于同一目录解析相对路径。另外,现在“certificate”和“asset_root”也支持指定 相对路径。
  • web-service:实现采用 NGINX 风格输出的基本目录列表,适用于 “frida-server –asset-root=/”等场景。
  • stalker:修复 32 位 x86 的 backpatch 参数。

15.0.18 变更

  • 修复长期存在的内存泄漏,包括内部堆 realloc 行为配置错误导致的泄漏,以及向 QuickJS 注册 JavaScript 类的方式所导致的泄漏。感谢 @mrmacete 发现并协助追踪这些长期 存在的错误!

15.0.19 变更

  • gadget:修复 iOS 上的 framework 资源查找逻辑。

Frida 14.2 发布

这次有太多内容可讲。先从一项重要的新功能开始:

Realm

Frida 支持 Android 已有相当长时间,但有一项功能一直被用户反复要求提供——这些用户大多以为自己遇到了错误。对话通常是这样开始的:“我在硬件加速的 Android 模拟器 X 中使用 Frida,附加到进程 Y 时,Process.enumerateModules() 中缺少 JNI 库 Z。但我能在 Process.enumerateRanges() 和 /proc/$pid/maps 中看到它。为什么?”

你可能已经猜到,我们说的是 Android 的 NativeBridge。它通常用于搭载 Intel 处理器的 Android 设备,使其能够运行仅支持 ARM 的应用,也就是包含一个或多个只为 ARM 构建的 JNI 组件的应用。

但在 Frida 的语境中,我们通常谈论的是基于 VirtualBox、运行 x86 Android 系统的模拟器。该系统附带由专有 ARM 转译器 libhoudini 提供的 NativeBridge 支持。

这类模拟器有很多,例如 BlueStacks、LDPlayer、NoxPlayer 等。上述产品主要针对游戏运行进行了优化,而现在 Google 官方的 Android 11 AVD 也已开箱提供 NativeBridge 支持。

多年来,我一直在思考 Frida 该如何支持此类场景,但每次思考都会有点头疼。我确实觉得我们最终应该支持它,只是始终难以确定 API 应有的形态。

然后 2020 年到来,Apple 宣布向 ARM 迁移,Rosetta 突然再次变得重要。“好吧,”我想,“现在已经有两个平台需要支持在进程中容纳运行旧代码的模拟 Realm 了。”

当然还有 Windows,只是我们尚不支持 ARM 上的 Windows。我们确实应该支持;如果有人有兴趣尝试,请务必联系我们。

总之,我很高兴地宣布,我们面向 x86 和 x86_64 的 Android 二进制文件现在可以开箱支持此类进程。你可能已经熟悉下面这个 frida-core API,其 Python 形式如下:

session = device.attach(target)

(如果你的代码只处理本地系统,也可以使用 frida.attach()。)

如果 target 存在模拟 Realm,现在可以这样做:

session = device.attach(target, realm='emulated')

默认值为 realm='native',而且两个 Realm 实际上可以同时使用。使用我们的命令行工具时,传入 --realm=emulated 即可作用于模拟 Realm。

在 Android 上使用此功能时有一个重要注意事项:Java 层插桩必须在 native Realm 中应用。

最后需要说明,这项新功能目前只在 Android 上得到支持,但未来支持 macOS 上的 Rosetta 应该并不困难。如果你愿意帮忙,请务必联系我们。

将 Android Java 挂钩改为内联方式

此前,Frida 的 Java bridge 在 Android 上替换 Java 方法时,会修改内存中的方法元数据,使目标方法变为 native 方法(如果它原本不是)。这样我们就能安装一个与指定方法 JNI 签名相匹配的 NativeCallback。

这带来了一些挑战,因为 ART 运行时还包含依赖指定方法特性的其他内部状态。我们设计了一些变通方案来绕开部分问题,但仍有一些特别棘手的边缘情况没有解决,其中一个例子就是 ART VM 维护的 JIT 分析数据。

我考虑已久的一个想法是停止修改方法元数据,转而对 AOT 生成的机器代码做内联挂钩——当然仅针对非 native 方法。这样仍未覆盖在虚拟机解释器中运行的方法,但我们假设可以通过挂钩虚拟机内部实现来处理它们。

我做了一个早期原型,进一步探索这种方案。它看起来可行,但仍有许多挑战需要解决。与 @muhzii 头脑风暴之后,他在业余时间继续完善这个粗糙的概念验证。后来有一天,当我看到他刚刚提交的出色拉取请求时,兴奋得差点从椅子上摔下来。

得益于 Muhammed 的杰出工作,现在大家都能在 Android 上享受大幅改进的 Java 插桩体验。这不仅提高了稳定性,也意味着直接调用不再绕过你的替换方法。太棒了!

去优化

对于在 Android 上使用 Java.deoptimizeEverything()、以确保挂钩不会因优化而被跳过的用户,现在有了粒度更细的替代方案。感谢 @alkalinesec 为 Java bridge 带来的优秀贡献,现在可以使用 Java.deoptimizeBootImage()。它确保只有启动映像 OAT 文件中的代码会被去优化。在某些情况下,应用代码本身去优化后会变慢,而可靠触发挂钩又不需要对它去优化;此时这项功能能显著提升性能。

CModule

这里还有一项非常令人兴奋的更新。故事中的下一位英雄是 @mephi42,他开始将 Frida 移植到 S390x。我们的 CModule 实现在底层依赖 TinyCC,而 TinyCC 尚不支持这一体系结构。不过系统中可能装有 C 编译器,因此 @mephi42 提议:在 TinyCC 无法提供帮助的系统上支持使用 GCC。

我非常喜欢这个想法。不仅因为它能扩大体系结构支持,还因为它有潜力生成快得多的代码——TinyCC 优化的是较小的编译器体积和较快的编译速度,而非较快的代码。

不用说,随着每个支持 GCC 的拉取请求到来,我也越来越兴奋。最后一个合入后,它又启发我添加了在 i/macOS 上使用 Apple clang 的支持。

最终我们得到如下用法:

const cm = new CModule(`…`, {}, { toolchain: 'external' });

其中 toolchain 可以是 any、internal 或 external。默认值是 any,这意味着如果 TinyCC 支持你的 Process.arch,我们就使用它,否则回退到 external。

不过故事并未结束。在实现 i/macOS 支持时,我并不清楚如何融合 JavaScript 端提供的符号,也就是 CModule 构造函数的第二个参数。

GCC 实现使用链接器脚本,这是一个非常优雅但 Apple 链接器并不支持的方案。随后我突然意识到:我们已经有自己的动态链接器,注入器就在使用它。

接好这部分后,另一个结论也显而易见:我们可以轻松支持完全跳过 Clang,让用户传入预编译的共享库。

这样设计是为了支持交叉编译,同时也使人们能够用 Swift 和 Rust 等语言实现 CModule——基本上,任何能与 C 互操作的语言都可以。

因此我们现在还支持:

const cm = new CModule(blob);

其中 blob 是一个包含共享库、用于构造 CModule 的 ArrayBuffer。目前这部分只在 i/macOS 上实现,但目标是在所有平台上提供支持。(欢迎贡献!)

另外,从 frida-tools 9.2 开始,REPL 的 -C 开关也支持此功能,既能方便地使用外部工具链,又不会失去实时重新加载能力,从而大幅缩短开发反馈周期。

再进一步,CModule API 现在还提供 CModule.builtins 属性,脚手架工具可以用它取得内置头文件和预处理器定义。

说到这里,frida-tools 中现在已经有了这样的工具:

$ mkdir pewpew
$ cd pewpew
$ frida-create cmodule
Created ./meson.build
Created ./pewpew.c
Created ./.gitignore
Created ./include/glib.h
Created ./include/gum/gumstalker.h
Created ./include/gum/gumprocess.h
Created ./include/gum/gummetalarray.h
Created ./include/gum/guminterceptor.h
Created ./include/gum/gumspinlock.h
Created ./include/gum/gummetalhash.h
Created ./include/gum/gummemory.h
Created ./include/gum/gumdefs.h
Created ./include/gum/gummodulemap.h
Created ./include/json-glib/json-glib.h
Created ./include/gum/arch-x86/gumx86writer.h
Created ./include/capstone.h
Created ./include/x86.h
Created ./include/platform.h

Run `meson build && ninja -C build` to build, then:
- Inject CModule using the REPL: frida Calculator -C ./build/pewpew.dylib
- Edit *.c, and build incrementally through `ninja -C build`
- REPL will live-reload whenever ./build/pewpew.dylib changes on disk

$ meson build && ninja -C build
…
[2/2] Linking target pewpew.dylib
$ frida Calculator -C ./build/pewpew.dylib
…
init()
[Local::Calculator]->

没错,它会实时重新加载!如果做到极致,你可以使用文件监视工具,在 pewpew.c 每次变化时运行 ninja -C build;之后只需保存,就能立即看到插桩在目标进程中生效。

值得注意的是,使用内部 CModule 工具链时也可以采用上述做法。把头文件放在磁盘上,有利于编辑器提供代码补全等功能。

结束语

此外还有许多令人兴奋的变化,请务必查看下面的变更日志。

祝使用愉快!

14.2.0 的变更

  • 全新的 Realm API,用于为原生进程内的模拟 Realm 插桩。目前只在 Android 上实现。
  • 添加 Java.deoptimizeBootImage()。感谢 @alkalinesec!
  • 向 frida-server 添加 –disable-preload/-P。它适用于操作系统兼容性问题,例如 Frida 附加到某些系统进程时会导致其崩溃。
  • 修复旧版 Android 上的 libc 检测。
  • 修复在 Android 上解析 vDSO 导出时的崩溃。感谢 @ant9000!
  • 恢复 Android 上的 libhoudini 支持。
  • 修复 Android 11 转译器上的 ARM 缓存刷新。
  • 修复 Android 5.x 的链接器偏移。感谢 @muhzii!
  • 开始重构 CModule 内部实现,为多个后端做准备。感谢 @mephi42!
  • 修复 ARM 上 CModule 的聚合初始化。
  • 修复 ModuleApiResolver 快速路径产生错误匹配的问题。

14.2.1 的变更

  • 修复 V8 运行时中 CModule 构造函数的错误路径。
  • Android 上的 “system_server” agent 改用 V8 运行时。

14.2.2 的变更

  • 修复 Darwin.Mapper 对没有 fixup 的页面的 arm64e 处理。这个问题纯粹因为“运气”而一直未被发现,直到我们的二进制文件最终发生足够多的变化才暴露出来。

14.2.3 的变更

  • 升级为对 ART 运行时使用内联挂钩。感谢 @muhzii!
  • 修复 i/macOS 上的直接传输回归。该问题由 GLib 升级引入,因为 GLib.Socket 在 Apple 操作系统上新增了 GLib.Credentials 支持。典型症状是 frida-server 被 Jetsam 终止。
  • 修复 32 位 Windows 上 libffi 对 stdcall、thiscall 和 fastcall 的支持。
  • 扩展 Memory.alloc(),支持在指定地址附近分配。感谢 @muhzii!
  • 修复 x86_64 上 RIP 相对间接分支的重定位。感谢 @dkw72n!
  • 改进 JVM C++ 分配器 API 探测逻辑,在放弃前先查询调试符号。感谢 @Happyholic1203!
  • 升级 SELinux 库以支持最前沿的 Android 系统。
  • 添加用于生成 GIR 的 gum-linux-x86_64-gir 目标。感谢 @meme!

14.2.4 的变更

  • 修复使用 ART 解释器时的 Android 性能回归,例如使用 deoptimizeEverything() 或 deoptimizeBootImage() 时,JS 回调会变得极其频繁。将热点回调移到 CModule 以提高速度。
  • 修复 Linux 上 Node.js 绑定中的 V8 调试器支持。
  • 修复 libdwarf 后端出现 ELF 初始化错误时的崩溃。

14.2.5 的变更

  • 修复 14.2.4 在旧版 Android 系统上引入的回归。

14.2.6 的变更

  • 修复与旧版 NativeBridge v3 及更新版本的兼容性;这些版本需要指定命名空间。

14.2.7 的变更

  • 修复 printf() 渲染 %p 时不带 “0x” 前缀的系统上 frida-java-bridge 的崩溃。
  • 修复 ARM64 上 jni_ids_indirection_ 偏移的解析。感谢 @muhzii!

14.2.8 的变更

  • 修复 i/macOS 上 GLib SO_NOSIGPIPE 的回归。该问题通常会导致 frida-server 因 SIGPIPE 而终止。感谢 @mrmacete!
  • 重构 CModule 内部实现并为 GCC 后端奠定基础。感谢 @mephi42!
  • 为只关心事件、不需要生命周期挂钩或代码转换的 Stalker C API 使用者添加 EventSink.make_from_callback()。
  • 在代码块起始处发出 Stalker BLOCK 事件。这最符合直觉,因为通常会期待 BLOCK 事件至少与 COMPILE 事件一样多;这种行为也最适合测量覆盖率。
  • 添加 Stalker 预取支持,可用于优化类似 “AFL fork server” 的用例。

14.2.9 的变更

  • 在 Darwin CodeSegment 后端处理 permanent 条目。从 iOS 14.3 开始,在 A12+ 设备上,当目标 VM 映射条目标记为 “permanent” 时,mach_vm_remap() 可能返回 KERN_NO_SPACE。感谢 @mrmacete!
  • 接入 CModule 的 GCC 支持。感谢 @mephi42!
  • 添加 Apple 操作系统上使用 Clang 的 CModule 后端。
  • 支持链接预构建的 CModule。(目前仅限 i/macOS。)
  • 完成 CModule 工具链选择 API。
  • 添加供工具使用的 CModule.builtins 属性。
  • 默认生成 frida-core GIR。感谢 @meme!
  • 修复 Linux/MIPS 上的回归。

14.2.10 的变更

  • 改进 frida-inject,使其支持双向标准输入输出。
  • 在 frida-python 中添加 Termux 支持:现在可以运行 pip install frida-tools。

14.2.11 的变更

  • 改进 frida-inject,使其支持原始终端模式。
  • 为 Darwin 添加内部策略守护进程。
  • 改进 Gum.Darwin.Mapper 以支持严格内核。

14.2.12 的变更

  • 修复 GC 后 ART 方法挂钩的可靠性。感谢 @muhzii!

14.2.13 的变更

  • 修复 x86 上 Instruction 操作数的解析,确保立即数始终由 Int64 而非 number 表示。感谢 @muhzii!
  • 修复进程未附加终端时的 frida-inject。感谢 @muhzii!
  • 向 CModule 公开 GLib 的 Base64 和 Checksum 原语。感谢 @mrmacete!

14.2.14 的变更

  • 修复 Gadget 在 i/macOS 上过早加载时的崩溃。
  • 将 frida-inject 的 stdin 通信改为可选。感谢 @muhzii!
  • 支持在 unc0ver 6.x 上启动 iOS 应用。感谢 @mrmacete!
  • 规避启动 iOS 应用时的单步延迟,避免随机失败。感谢 @mrmacete!
  • 修复 libc shim 中 read() 签名不匹配的问题,该问题会在较新的 Apple 工具链上导致编译错误。感谢 @Manouchehri!
  • 修复较新版 Android 上 enumerate_applications() 截断名称的问题。感谢 @pancake 报告并协助定位!
  • 修复目标无法加载 frida-agent 时的挂起。
  • 修复附加 Windows 服务的支持。
  • 注册新 Windows 服务前清理陈旧服务。
  • 添加构建选项,以便使用已安装的资源而不是将其嵌入。
  • 更新 iOS 打包以使用已安装的资源。
  • 添加对受限 Android 的基本支持。感谢 @enovella_ 参与愉快而高效的结对编程!
  • 扩展 Arm64Writer API 以支持更多立即数。
  • 改进 Stalker,使其支持 arm64 上暂时未对齐的栈。
  • 修复 Stalker follow() 在没有 sink 时的崩溃。
  • 实现 Stalker 失效支持,使插桩可以在不丢弃全部转译代码的情况下更新。感谢 @p1onk 协助!
  • 添加 Gum.DarwinModule.enumerate_function_starts()。
  • 添加 Gum.DarwinGrafter,用于 AOT grafting,以便预处理二进制文件,使其在无法于运行时修改代码时仍可插桩。感谢 @mrmacete 协助!
  • 添加 Memory.allocate_near()。
  • 改进 Stalker 在所有受支持体系结构上的性能和稳健性:
    • 改进调用探针,使其在目标位置而非调用点探测,并利用新的失效基础设施。
    • 支持在调用探针内部添加或移除调用探针。
    • 重构 Callout 处理,使用户数据可在失效时销毁,同时移除 Callout 锁。
    • 遇到自修改代码时重新编译,而不是分配新代码块。
    • 为代码和数据使用独立 slab,避免因元数据存储耗尽而只能使用部分 slab。
    • 将第一个代码/数据 slab 内联到 ExecCtx。跟踪很少触及代码的线程时可显著减少内存用量;线程完全没有唤醒时亦然。
    • 当 trust_threshold 为 0 时,不再存储原始代码。
    • 简化 Stalker 代码块元数据,减少每个代码块的内存占用。
  • 修复 ART 上 Java.enumerateMethods() 的结果。此前静态初始化方法会以 ‘$init’ 被错误地纳入枚举结果,实际应完全跳过。感谢 @muhzii!
  • 修复 Java 方法挂钩期间使用的 Android/ART 近地址内存分配路径。感谢 @muhzii!
  • 修复通用 Java 数组类型的处理。这样,从运行时获取的数组对象可在之后编组数组类型时复用,这对保留类型信息很有必要,尤其是在类型为动态类型时。感谢 @muhzii!
  • 将 Android/ART StackVisitor 移植到 x86、x64 和 ARM32。感谢 @P-Sc!
  • 修复 Android 上的 ARM 缓存刷新。事实证明,Linux/ARM 上的 cacheflush() 要求传入范围。这个 32 位 Android/ARM 回归由 14.2.0 引入。
  • 为 32 位 ARM 添加一些缺失的 TinyCC builtin。感谢 @giantpune 报告并协助定位!
  • 修复 Stalker 代码块回收逻辑中的回绕。
  • 修复从大数值构造 V8 NativePointer。
  • 修复 Windows 上 Stalker 的本地线程操作。
  • 修复 CModule 临时目录清理逻辑。
  • 移除遗忘的 InspectorServer 调试代码。
  • 修复 V8 调试器集成。感谢 @taviso 报告!

14.2.15 的变更

  • 修复与最新版 unc0ver iOS 越狱的兼容性。感谢 @mrmacete!
  • 添加 Anbox 支持。感谢 @asabil!
  • 添加 Java.deoptimizeMethod()。感谢 @liuyufei!
  • 处理替换可能被去虚拟化的 ART 方法。感谢 @liuyufei!

14.2.16 的变更

  • 为 32 位 ARM 添加许多缺失的 TinyCC builtin。感谢 @giantpune 报告并协助定位!
  • 修复 arm64 上使用 ADRP 时 Android ART trampoline 的对齐问题。此前替换某些方法时会抛出 Error: invalid argument 异常。感谢 @pandasauce 报告并协助定位!

14.2.17 的变更

  • 从 chained fixup 中枚举 Darwin 导入,以支持最新的 arm64e 二进制文件。感谢 @mrmacete!
  • 修复受限 iOS 注入器对 chained fixup 的处理。感谢 @mrmacete!
  • qml:使用 no_keywords 编译以兼容 GLib。感谢 @suy!

14.2.18 的变更

  • 修复较新 XNU 版本上的 i/macOS 注入器:尝试窃取目标进程 POSIX 线程端口的发送权时,mach_port_extract_right() 会以 KERN_INVALID_CAPABILITY 失败。这会使注入器误以为我们已解除注入,随后释放仍在使用的内存。
  • 修复受限 iOS 注入器中的 ___error 符号名。感谢 @mrmacete!
  • 修复 Linux 后端枚举路径中含空格的模块。感谢 @suy!
  • 修复 Stalker 对 x64 直接分支地址的处理。
  • python:添加 RPC 导出列表功能。感谢 @NewbieGoose!

Frida 14.1 发布

这次有很多好东西!🎉 一起来看看。

依赖项

我们刚把所有依赖项升级到最新版本,其中一部分工作是重整用于构建依赖的构建系统。

有了这些改进,我们终于能完全从源码构建过去的 Frida 版本,解决这个长期以来令人头疼的问题。

现在调整依赖项也容易得多,例如调试问题时。假设你正在排查 Thread.backtrace() 为何无法在 Android 上正常工作,可能需要研究 libunwind 内部实现。现在构建某个特定依赖非常简单:

$ make -f Makefile.sdk.mk FRIDA_HOST=android-arm64 libunwind

如果要为本地系统构建:

$ make -f Makefile.sdk.mk libunwind

如果已经构建了 Frida,并想替换其预构建 SDK 中的 libunwind,现在可以执行:

$ make -f Makefile.sdk.mk symlinks-libunwind

随后可以继续修改“deps/libunwind”,并重新运行以下命令进行增量编译:

$ make -f Makefile.sdk.mk libunwind

iOS

现在支持 iOS 14.2。此前基本可用,但崩溃报告器集成会使 Apple 的崩溃报告器死锁,对整体系统稳定性不利。

GumJS 支持 size_t 和 ssize_t

感谢 @mame82,NativeFunction 等 API 终于支持“size_t”和“ssize_t”。跨平台 Agent 不再需要维护它们与原生类型之间的映射。太棒了!

系统 GLib 支持

Gum 终于可以使用上游版本的 GLib 构建,而且现在支持生成 GObject introspection 定义。这为今后完全自动生成语言绑定铺平了道路。

感谢 @meme 带来这些出色改进!

Windows 进程内注入

Windows 后端终于支持进程内注入。在最常见的目标进程架构相同且无需提权的情况下,现在无需先把“frida-helper-{32,64}.exe”写入临时目录并启动,即可对目标执行 attach();启动时间也因此缩短。

这项改进旨在解决一个长期问题:我们的逻辑容易触发某些端点安全产品的误报,导致注入器无法工作。确实需要启动辅助程序时仍可能遇到此类问题,但最常见的用例现在很可能可以正常工作。

Stalker ARM 改进

对于在 32 位 ARM 上使用 Stalker 的用户,它现在应比以往好用得多;此版本加入了大量修复。

字节码与 frida-tools

14.0 发布后我们意识到,QuickJS 字节码格式比预期更易变化。因此,除非应用设计为只配合某个确切 Frida 版本使用,否则不建议使用“frida-compile -b”。

发布上一版 frida-tools 时我尚未意识到这个陷阱,因此选择把 frida-trace Agent 预编译为字节码。准备 14.1 时发现错误后,我撤销了该改动并发布新版 frida-tools。

因此升级时请确保也获取其最新版本:

$ pip3 install -U frida-tools

结语

此外还有许多令人兴奋的变化,请务必查看下面的变更日志。

尽情体验吧!

14.1.0 的变更

  • 将所有依赖升级到最新版本。
  • 大幅重整依赖构建系统,今后终于支持完全从源码构建过去的 Frida 版本。
  • 将 iOS 崩溃报告器集成移植到 iOS 14.2。
  • 修复与 iOS 设备通信时的错误传播。
  • GumJS 新增“size_t”和“ssize_t”支持。感谢 @mame82!
  • 支持链接系统 GLib 和 libffi。感谢 @meme!
  • 支持 GObject Introspection。感谢 @meme!
  • 改进 Windows 后端以支持进程内注入;在架构相同且无需提权的常见情况下,可避开常见杀毒启发式并提升速度。
  • 修复 Stalker ARM 对“ldr pc, [sp], #4”的处理。
  • 修复 Stalker ARM 在 IT 块中破坏标志的问题。
  • 修复 Stalker ARM 对 IT 块中 CMN/CMP/TST 的处理。
  • 修复 ThumbWriter 指令的抑制标志。
  • 修复 Stalker ARM 排除逻辑的可靠性。
  • 修复 ARM Stalker 在 Thumb 模式下对线程执行 follow()。
  • 修复 ARM Stalker 在 Thumb 模式下的 SVC 处理。
  • 修复 ThumbRelocator 对未对齐 ADR 的处理。
  • Stalker ARM 改用运行时 VFP 特性检测。
  • 没有任何回调时拒绝 Interceptor.attach()。
  • 改进 GumJS 错误消息格式。
  • 修复 V8 调试器集成中的饥饿问题。
  • 在 V8 上的调用期间也保持 NativeCallback 存活。

14.1.1 的变更

  • 修复 CModule 中 Capstone 缺失的回归。
  • 为 32 位 ARM 添加缺失的 CModule 内置项。
  • 修复 Android/ARM64 上的 Thread.backtrace()。

14.1.2 的变更

  • 修复 Android/ARM 上的 Thread.backtrace()。

14.1.3 的变更

  • 修复 ObjC.choose();14.1.0 中的 TinyCC 升级暴露了既有错误。
  • 默认重新启用 V8。某些用例中它比 QuickJS 更合适,而且大家也非常想念它的调试器功能。
  • 为 frida-server 新增 –ignore-crashes/-C,用于禁用原生崩溃报告器集成,适用于不需要该集成或运行在尚未完全支持的前沿操作系统版本上的场景。(目前仅 iOS 和 Android 提供崩溃报告器集成。)
  • 增强 devkit,确保所有平台都公开 Capstone API。
  • 改进 devkit 示例。

Frida 14.0 发布

这是一次重大的新版本发布,背后是数周高强度编码和多得有些过分的咖啡。不过在深入介绍之前,我们需要先快速回顾一下过去。

多年来,基于 V8 的运行时一直很好地服务着我们。但最终,我们需要支持那些并不适合运行 V8 的受限系统,于是引入了第二个运行时。

它运行得不错,但也留下了一些取舍:

  • 两个运行时所支持的语言特性差异巨大。我们试图通过把精简运行时设为默认值来缓解部分问题,因为它随处可用,也是功能方面的最低共同标准。
  • 使用 frida-compile 等工具将现代 JavaScript 编译为可在两个运行时上执行的旧版 JavaScript 时,必须牺牲性能。
  • 当非简单 agent 中充斥大量代码和数据时,不仅能明显看出 V8 有多快——这并不意外——还能看出它很擅长紧凑地组织对象,避免浪费宝贵的 RAM。更拉大两个运行时差距的是,V8 可以直接运行现代 JavaScript,无需执行一个臃肿版本,后者要包含兼容垫片来补齐 Map、Set 等缺失的运行时功能。
  • 示例代码和文档往往显得晦涩,只为避免让那些可能尝试在默认运行时上执行现代代码的用户感到困惑。
  • 垃圾回收器实现上的差异,可能会在一个运行时中掩盖用户的错误,而在另一个更积极释放资源的运行时中立即爆炸。一个例子是:外部代码仍在使用 NativeCallback 时,却没有让它保持存活。
  • 糟糕的用户体验:以上种种汇总起来,会形成一个极其令人沮丧和困惑的使用故事。
  • 新功能和改进必须实现两次。显而易见,这对维护者来说非常痛苦。

时间快进到 2019 年,QuickJS 引起了我的注意。不过当时我正忙于其他事情,等到后来仔细研究时,我发现它支持 ES2020,而且作为解释器,性能也令人印象深刻。

但一想到要从头实现新的运行时,再看看另外两个运行时各自大约有 2.5 万行代码,这项工作就让人不堪重负。

可我还是不断回到 QuickJS 网站,仔细研读技术细节,甚至一度开始深入阅读其公共 API。

随后我注意到,它不支持协作式多线程使用,也就是让多个线程步调一致地执行 JavaScript。这让前方的工作显得更加艰巨;但我又想起自己已经为 Duktape 贡献过这项支持,而且并没有那么难。

最终我鼓起了勇气。从 GumJS 庞大的测试套件中挑了一个极其简单的测试作为第一个挑战,然后从现有两个运行时中较新的那个复制粘贴 ScriptBackend 和 Script 实现。先重命名,再把所有模块(Interceptor、Stalker 等)存根化,只想先让一个几乎为空的“外壳”能够编译并运行。

到了这一步,我彻底上瘾,根本停不下来。喝掉了大量咖啡,不知不觉就实现了核心部分和第一个模块,随后又是一个,再来一个。

在深入使用 QuickJS API,并反复查看其内部实现以确保理解引用计数规则等细节后,实现协作式多线程 API 所需的工作突然变得非常清晰。只有做到这一点,它才会成为真正的运行时,而不只是玩具。

我们需要能够在调用 NativeFunction 时暂停 JS 执行。这是因为被调用函数可能会阻塞等待另一个线程已经持有的锁,而另一个线程可能刚刚调用了被 hook 的函数,正在等待进入 JS 运行时。因此,如果调用 NativeFunction 前不释放 JS 锁,就会发生死锁。

另一个场景是调用 Thread.sleep() 或其他阻塞 API;如果持有 JS 锁执行它们,就会造成线程饥饿。

总之,QuickJS 多线程 API 最终实现起来很直接,于是我继续推进,直到终于全部完成!🎉

这时我非常好奇这个全新运行时的性能,首先想知道进入和离开运行时的成本。

我在 iPhone 6 上试运行了 GumJS 的一个测试:使用 Interceptor hook 一个几乎为空的 C 函数,提供空的 JS 回调,然后反复调用该 C 函数,并测量每次调用所用的实际时间。

其思路是模拟用户 hook 高频调用函数时的情况,以了解基础开销。

结果如下:

# QuickJS
<min: 1.0 us, max: 7.0 us, median: 2.0 us> ok 1 /GumJS/Script/Interceptor/Performance/interceptor_on_enter_performance#QJS
<min: 2.0 us, max: 54.0 us, median: 2.0 us> ok 2 /GumJS/Script/Interceptor/Performance/interceptor_on_leave_performance#QJS
<min: 3.0 us, max: 18.0 us, median: 3.0 us> ok 3 /GumJS/Script/Interceptor/Performance/interceptor_on_enter_and_leave_performance#QJS
# Duktape
<min: 2.0 us, max: 8.0 us, median: 3.0 us> ok 4 /GumJS/Script/Interceptor/Performance/interceptor_on_enter_performance#DUK
<min: 2.0 us, max: 6.0 us, median: 3.0 us> ok 5 /GumJS/Script/Interceptor/Performance/interceptor_on_leave_performance#DUK
<min: 4.0 us, max: 89.0 us, median: 4.0 us> ok 6 /GumJS/Script/Interceptor/Performance/interceptor_on_enter_and_leave_performance#DUK
# V8
<min: 13.0 us, max: 119.0 us, median: 14.0 us> ok 7 /GumJS/Script/Interceptor/Performance/interceptor_on_enter_performance#V8
<min: 15.0 us, max: 127.0 us, median: 16.0 us> ok 8 /GumJS/Script/Interceptor/Performance/interceptor_on_leave_performance#V8
<min: 26.0 us, max: 198.0 us, median: 28.0 us> ok 9 /GumJS/Script/Interceptor/Performance/interceptor_on_enter_and_leave_performance#V8

哇,这看起来很有希望!那么基线内存占用呢,也就是运行时单个实例本身会消耗多少内存?

QJS 内存基线

提升相当明显——只有上一个运行时的五分之一!

接下来,我想了解使用 REPL 时 Frida 内部堆的近似初始大小。其中包括 frida-agent、JS 运行时以及所加载 REPL agent 使用的全部内存:

QJS REPL 内存

太棒了,为其他用途腾出了 1 MB!

说到这里,希望你也和我一样对这个新版本感到兴奋。我们已经用这个基于 QuickJS 构建的全新运行时替换了先前的默认运行时。

作为实验,我还决定在构建官方二进制文件时不包含 V8 运行时。这意味着二进制文件比以往任何时候都小得多。

我知道有些使用场景可能离不开 V8 运行时,所以希望你尝试一下新的 QuickJS 运行时,并告诉我它的表现。如果它在你的特定场景中彻底失灵,也不必担心,请告诉我,我们会一起想办法。

如果希望自行构建启用 V8 运行时的 Frida,只需调整这一行。但如果你确实离不开它,请务必告诉我,以便我们决定未来是否还需要继续支持这个运行时。

这个大版本的另一项变更只影响 i/macOS:我们终于跟随 Apple 的脚步,放弃对 32 位程序的支持。目前仍会保留相关代码路径,但官方二进制文件已经轻量得多,顶层构建系统也有所精简。例如,make core-macos-thin 现在只是 make core-macos。

Frida 本身的变化就这些,但还有更多。我们还发布了 frida-tools 9.0,经过全新升级,现在可以到处使用现代 JavaScript 特性。其中包括 frida-trace,语法升级后,其生成的 hook 模板可读性大幅提高。最后,我们还发布了 frida-compile 10.0:Babel 依赖以及对应的命令行开关都已移除,速度更快,也简单得多。

希望你喜欢这个新版本!

14.0.0 的变更

  • 使用基于 QuickJS 的全新 GumJS 运行时替换默认运行时。
  • 默认禁用 V8。
  • 在 V8 上保留 Interceptor.attach() 的回调对象。
  • 从全局访问 API 中移除“enumerate”陷阱。

14.0.1 的变更

  • QJS:修复嵌套的全局访问请求。
  • qml:更新到新的 frida-core API。

14.0.2 的变更

  • QJS:在调用期间让 NativeCallback 保持存活。
  • QJS:加速 NativeCallback 构造逻辑。
  • QJS:暂时禁用堆栈限制。
  • iOS:将 iOS 崩溃报告器集成移植到 iOS 14。
  • iOS:移除 32 位打包逻辑。
  • Android:为“system_server”agent 使用默认运行时。
  • 现代化内部 JavaScript agent。

14.0.3 的变更

  • 在 Windows 上也禁用 V8。
  • iOS:改进打包脚本。

14.0.4 的变更

  • iOS:修复工具链升级引起的 arm64e 回归。

14.0.5 的变更

  • QJS:修复 Interceptor 错误处理。

14.0.6 的变更

  • ObjC:修复被替换方法的生命周期,使其不再与类包装器绑定,并在链式使用场景中保持存活。感谢 @Hexploitable 和 @mrmacete 的协助!
  • 修复 act == oact 时 Exceptor sigaction() 注册失败的问题。感谢 @hluwa!
  • 改进 Linux libc 检测。
  • 修复在 Linux 上枚举和修改线程时偶发的挂起。
  • 修复 PC 与 CPSR Thumb 位处理不一致的问题。
  • 修复 Linux/armhf 和 Linux/arm64 上的构建回归。
  • 发布适用于 32 位和 64 位 Raspberry Pi 的二进制文件。

14.0.7 的变更

  • 避免在执行 JS 代码期间崩溃时发生死锁,例如调用带有 exceptions: 'propagate' 的 NativeFunction,或 GumJS 本身存在错误时。感谢 @mrmacete!
  • 修复 macOS/arm64 上的 CModule。
  • 发布适用于 32 位 Raspberry Pi 的 Python 和 Node.js 二进制文件。
  • 发布 Fedora 33 而非 Fedora 32 的二进制文件。
  • 发布 Ubuntu 20.10 的二进制文件。

14.0.8 的变更

  • 通过在上传连接中加入一些双向通信,提高受限 iOS 上的上传可靠性。这可以防止复杂远程配置中的 gadget 上传触发 DoS 保护。感谢 @mrmacete!

Frida 12.11 发布

为迎接 Apple 发布 macOS 11,Frida 12.11 来了!此版本完全兼容 macOS 11 Beta 3,而且现在还支持 Apple 芯片上的 macOS。太棒了!

值得一提的是,我们没有止步于 arm64,还支持 arm64e。该 ABI 仍在变化,因此如果你拥有 Developer Transition Kit(DTK)并想尝试,需要禁用 SIP,再添加一个启动参数:

$ sudo nvram boot-args="-arm64e_preview_abi"

考虑到各平台如此出色地趋于统一,我们实际上可能已经支持越狱的 iOS 14。等公开越狱工具出现后即可确认;至少支持它应该不需要太多工作。

正在探索 DTK 的用户可以像往常一样获取 CLI 工具和 Python 绑定:

$ pip3 install frida-tools

顺便一提,我们刚发布了 CryptoShark 0.2.0,非常推荐尝试。目前唯一的限制是只提供 macOS/x86_64 二进制文件;借助 Rosetta,它能在 macOS/arm64 上运行,但无法附加到“Local System”设备上的进程。

解决方法很简单:从我们的发布页获取 frida-server 二进制文件并启动,然后让 CryptoShark 连接“Local Socket”设备。如果想在一台系统上运行 CryptoShark,并附加到另一台系统的进程,也可使用本地 SSH 端口转发:

$ ssh -L 27042:127.0.0.1:27042 dtk

此版本还有许多令人兴奋的变化,请务必查看下面的变更日志。

尽情体验吧!

12.11.0 的变更

  • 新增 macOS 11 和 Apple 芯片支持。
  • 在 Darwin 上将辅助进程守护进程化。感谢 @mrmacete!
  • 在 Linux 上将辅助进程守护进程化。
  • 修复使用 usbmuxd 时不可靠的 iOS 设备处理。感谢 @mrmacete!
  • 修复 i/macOS frida-helper 提前退出时的无限等待。
  • 为 Android spawn() 新增“uid”选项以指定用户 ID。感谢 @sowdust!
  • 支持最新版 checkra1n 越狱。感谢 @Hexploitable 协助!
  • 提升 Stalker ARM 稳定性。
  • 修复 Interceptor arm64 后端错误路径中的泄漏。
  • 修复无 RWX 页面系统上 memcpy() 附近的拦截。
  • 修复 Darwin/arm64e 上 CpuContext 指针的编码。
  • 始终在 Darwin/arm64 上剥离回溯项。
  • 修复大端系统上的 Linux 架构检测。
  • 修复 ARM BE8 上 Capstone 的字节序配置。

12.11.1 的变更

  • 处理使用不同 ptrauth 密钥的 i/macOS 目标。
  • 修复大端系统上的 Linux CPU 类型检测。
  • 修复 Linux/ARM-BE8 上的早期插桩。
  • 修复向因 SIGTTIN 或 SIGTTOU 阻塞的 Linux 进程注入。

12.11.2 的变更

  • 修复 macOS 11/x86_64 上 Stalker 的 thread_exit 探测。
  • 修复 macOS 11/x86_64 上导出解析缓慢的问题。
  • 修复 ARM 上 CModule 对 Capstone 头文件的支持。
  • 在 ARM 的 CModule 运行时中新增 ArmWriter。
  • qml:支持指定要使用的脚本运行时。

12.11.3 的变更

  • 修复 V8 运行时中 ModuleMap.values() 的原型。
  • qml:将 DetachReason 枚举与当前 Frida API 同步。
  • qml:修复 Device 生命周期逻辑。

12.11.4 的变更

  • 修复 macOS 11 beta 3 上的注入器,并停止支持更早的 beta。
  • 移除 macOS 11 beta 3 已使其多余的辅助进程变通方案。
  • 修复 i/macOS introspection 模块处理。

12.11.5 的变更

  • 修复 macOS 11 和 iOS 14 上使用 dyld 现代代码路径的进程早期插桩。
  • 使用 VMThread::execute() 安装新方法,使 JVM 方法拦截更安全;它会阻塞所有 Java 线程,从而能更安全地拦截热点方法。感谢 @0xraaz!
  • ARM Relocator 新增 SUB 指令支持,提高在 32 位 ARM 上使用 Interceptor 和 Stalker 的可靠性。
  • qml:添加缺失的 include,修复 GCC 构建。

12.11.6 的变更

  • 将未越狱 iOS 注入器移植到新的 arm64e ABI,因此现在即使在 A12+ 设备上,也完全支持 iOS 14 beta 3 的未越狱模式。

12.11.7 的变更

  • 改进 Linux 和 QNX 上的 libc 检测。感谢 @demantz!
  • 修复 libdwarf 后端的符号大小检查,使 Linux 调试符号解析更可靠。
  • 修复脆弱的 Android Activity 启动逻辑。感谢 @muhzii!
  • 清除 kAccFastInterpreterToInterpreterInvoke 标志,提高 Android Java Hook 可靠性。感谢 @deroko!
  • 防止在 $dispose() 后使用 Java 包装器,使此类危险错误更易发现。
  • 改进 frida-qml 构建系统并支持独立使用。

12.11.8 的变更

  • 支持 Apple 芯片上的 macOS 11 beta 4。

12.11.9 的变更

  • 支持使用 Xcode 12 开发者磁盘映像的未越狱 iOS。

12.11.10 的变更

  • node:修复 IOStream 的 WriteOperation 泄漏。感谢 @mrmacete!
  • qml:支持列出应用。
  • qml:在各模型上公开“count”属性。
  • 修复“add sb, pc, r4”的 ARM 重定位。
  • 修复“add ip, pc, #4, #12”的 ARM 重定位。
  • 修复 Rn 位于寄存器列表中时 ARM writer 对 LDMIA 的支持。

12.11.11 的变更

  • 支持 Android R 上的不透明 JNI ID,以支持可调试应用。感谢 @muhzii!
  • qml:支持启动进程。
  • qml:在 Linux 上使用 devkit 链接时加入缺失的库。
  • qml:修复 Linux 上的静态链接。
  • qml:优化启动过程,不再等待 enumerate_devices()。

12.11.12 的变更

  • 在 i/macOS 早期插桩期间初始化 CoreFoundation。感谢 @mrmacete!
  • Stalker 支持 NULL EventSink。感谢 @meme!
  • node:提供 Electron v10 和 v11 预构建包;下个版本将停止提供 v9 预构建包。
  • qml:新增 post(QJsonArray)。

12.11.13 的变更

  • 修复 Android 11/arm64 上的 ART 内部结构探测。感谢 @enovella_!
  • 暂时不压缩地构建 V8 的 GumJS 运行时,因为还需改进 frida-compile 以使用最新版 terser。

12.11.14 的变更

  • frida-compile 已升级到最新版 terser,现在压缩构建 V8 的 GumJS 运行时。

12.11.15 的变更

  • 支持 iOS 14.x 安全 DTX。感谢 @mrmacete!
  • 修复 Android 11 上的 Java.deoptimizeEverything()。感谢 @Gh0u1L5!

12.11.16 的变更

  • 修复 Arm64Relocator.can_relocate() 的 arm64e 支持。感谢 @mrmacete!
  • 为 Stalker.follow() 新增“onEvent”选项,允许在原生代码中同步处理事件,通常使用 CModule 实现。可用于自定义过滤或队列逻辑以提升性能,或牺牲性能换取可靠事件传递。
  • 向 EventSink 公开 Stalker 的实时 CpuContext,可通过“onEvent”回调和 Gum C API 访问。
  • 在 CModule 运行时中新增 Spinlock。

12.11.17 的变更

  • 在未越狱 iOS 上通过 LLDB 终止进程,尽可能避免使用 ProcessControl。此前行为会让 debugserver 处于异常状态,已终止应用有时仍显示为运行中,导致后续 spawn() 的早期插桩失败。感谢 @mrmacete!
  • 允许 instrumentation 字段检测妥善失败,修复旧版 Android API 上的 Java 桥接初始化;旧 API 本就不需要它。
  • 略微减少每个脚本的 Duktape 内存用量,无需驻留脚本源码字符串。

12.11.18 的变更

  • 在未越狱 iOS 上检测最前端应用时跳过应用扩展。此前应用扩展有时会成为首个匹配进程,随后抛出“Unable to resolve bundle path to bundle ID”。感谢 @mrmacete!
  • 改进 Android ART 在 x86/x86_64 上的插桩偏移检测。感谢 @Gh0u1L5!
  • 修复 Android 7.1–8.1 上的 JDWP 初始化失败。感谢 @Gh0u1L5!
  • 修复 libdwarf 后端的最近符号逻辑。
  • 修复基于 Duktape 的运行时参数解析逻辑中的泄漏:解析后续参数出错时,已收集的内存范围数组会泄漏。

Frida 12.10 发布

这次为 Java 开发者和逆向工程人员带来了一些令人兴奋的消息:frida-java-bridge 现在支持 HotSpot JVM。这意味着 Java 运行时桥接不再是 Android 独有功能。非常感谢 Razvan Sima 带来这项出色的功能。

时机也恰到好处,因为我们最近还添加了全新的 Java.enumerateMethods(query) API,用于高效定位与指定查询匹配的方法。我们也确保在 HotSpot JVM 上实现了它。

查询以 "class!method" 形式指定,允许使用 glob。末尾还可以附加 / 和一个或多个修饰符:

  • i:不区分大小写匹配。
  • s:包含方法签名,例如 "putInt" 会变成 "putInt(java.lang.String, int): void"。这便于按参数和返回类型匹配,例如用 "*!*: boolean/s" 匹配所有返回布尔值的方法。
  • u:只包含用户定义的类,忽略系统类。

例如:

Java.perform(() => {
  const groups = Java.enumerateMethods('*youtube*!on*')
  console.log(JSON.stringify(groups, null, 2));
});

可能会得到如下输出:

[
  {
    "loader": "<instance: java.lang.ClassLoader, $className: dalvik.system.PathClassLoader>",
    "classes": [
      {
        "name": "com.google.android.apps.youtube.app.watch.nextgenwatch.ui.NextGenWatchLayout",
        "methods": [
          "onAttachedToWindow",
          "onDetachedFromWindow",
          "onFinishInflate",
          "onInterceptTouchEvent",
          "onLayout",
          "onMeasure",
          "onSizeChanged",
          "onTouchEvent",
          "onViewRemoved"
        ]
      },
      {
        "name": "com.google.android.apps.youtube.app.search.suggest.YouTubeSuggestionProvider",
        "methods": [
          "onCreate"
        ]
      },
      {
        "name": "com.google.android.libraries.youtube.common.ui.YouTubeButton",
        "methods": [
          "onInitializeAccessibilityNodeInfo"
        ]
      },
      …
    ]
  }
]

我们还增强了 frida-trace,使其支持跟踪 Java 方法:

$ frida-trace \
    -U \
    -f com.google.android.youtube \
    --runtime=v8 \
    -j '*!*certificate*/isu'
Instrumenting...
X509Util.addTestRootCertificate: Auto-generated handler at "/Users/oleavr/__handlers__/org.chromium.net.X509Util/addTestRootCertificate.js"
X509Util.clearTestRootCertificates: Auto-generated handler at "/Users/oleavr/__handlers__/org.chromium.net.X509Util/clearTestRootCertificates.js"
X509Util.createCertificateFromBytes: Auto-generated handler at "/Users/oleavr/__handlers__/org.chromium.net.X509Util/createCertificateFromBytes.js"
X509Util.isKnownRoot: Auto-generated handler at "/Users/oleavr/__handlers__/org.chromium.net.X509Util/isKnownRoot.js"
X509Util.verifyKeyUsage: Auto-generated handler at "/Users/oleavr/__handlers__/org.chromium.net.X509Util/verifyKeyUsage.js"
X509Util.verifyServerCertificates: Auto-generated handler at "/Users/oleavr/__handlers__/org.chromium.net.X509Util/verifyServerCertificates.js"
ResourceLoader$CppProxy.native_enableDevCertificate: Auto-generated handler at "/Users/oleavr/__handlers__/com.google.android.libraries.elements.interfaces.ResourceLoader_CppProxy/native_enableDevCertificate.js"
ResourceLoader$CppProxy.enableDevCertificate: Auto-generated handler at "/Users/oleavr/__handlers__/com.google.android.libraries.elements.interfaces.ResourceLoader_CppProxy/enableDevCertificate.js"
AndroidCertVerifyResult.getCertificateChainEncoded: Auto-generated handler at "/Users/oleavr/__handlers__/org.chromium.net.AndroidCertVerifyResult/getCertificateChainEncoded.js"
bjbm.a: Auto-generated handler at "/Users/oleavr/__handlers__/bjbm/a.js"
bjbn.a: Auto-generated handler at "/Users/oleavr/__handlers__/bjbn/a.js"
AndroidNetworkLibrary.addTestRootCertificate: Auto-generated handler at "/Users/oleavr/__handlers__/org.chromium.net.AndroidNetworkLibrary/addTestRootCertificate.js"
AndroidNetworkLibrary.clearTestRootCertificates: Auto-generated handler at "/Users/oleavr/__handlers__/org.chromium.net.AndroidNetworkLibrary/clearTestRootCertificates.js"
AndroidNetworkLibrary.verifyServerCertificates: Auto-generated handler at "/Users/oleavr/__handlers__/org.chromium.net.AndroidNetworkLibrary/verifyServerCertificates.js"
vxr.checkClientTrusted: Auto-generated handler at "/Users/oleavr/__handlers__/vxr/checkClientTrusted.js"
vxr.checkServerTrusted: Auto-generated handler at "/Users/oleavr/__handlers__/vxr/checkServerTrusted.js"
vxr.getAcceptedIssuers: Auto-generated handler at "/Users/oleavr/__handlers__/vxr/getAcceptedIssuers.js"
ResourceLoader.enableDevCertificate: Auto-generated handler at "/Users/oleavr/__handlers__/com.google.android.libraries.elements.interfaces.ResourceLoader/enableDevCertificate.js"
Started tracing 18 functions. Press Ctrl+C to stop.
           /* TID 0x339d */
   955 ms  AndroidNetworkLibrary.verifyServerCertificates([[48,-126,9,…],[48,-126,4,…]], "RSA", "suggestqueries.google.com")
   972 ms  AndroidCertVerifyResult.getCertificateChainEncoded()
  1043 ms  AndroidNetworkLibrary.verifyServerCertificates([[48,-126,4,…],[48,-126,4,…]], "RSA", "www.googleadservices.com")
  1059 ms  AndroidCertVerifyResult.getCertificateChainEncoded()
           /* TID 0x33a0 */
  1643 ms  AndroidNetworkLibrary.verifyServerCertificates([[48,-126,5,…],[48,-126,4,…]], "RSA", "googleads.g.doubleclick.net")
           /* TID 0x339d */
  1651 ms  AndroidNetworkLibrary.verifyServerCertificates([[48,-126,9,…],[48,-126,4,…]], "RSA", "www.youtube.com")
           /* TID 0x33a1 */
  1665 ms  AndroidNetworkLibrary.verifyServerCertificates([[48,-126,15,…],[48,-126,4,…]], "RSA", "lh3.googleusercontent.com")
           /* TID 0x33a0 */
  1674 ms  AndroidCertVerifyResult.getCertificateChainEncoded()
           /* TID 0x339d */
  1674 ms  AndroidCertVerifyResult.getCertificateChainEncoded()
           /* TID 0x3417 */
  1674 ms  AndroidNetworkLibrary.verifyServerCertificates([[48,-126,15,…],[48,-126,4,…]], "RSA", "yt3.ggpht.com")
           /* TID 0x33a1 */
  1684 ms  AndroidCertVerifyResult.getCertificateChainEncoded()
           /* TID 0x3417 */
  1688 ms  AndroidCertVerifyResult.getCertificateChainEncoded()
  2513 ms  AndroidNetworkLibrary.verifyServerCertificates([[48,-126,9,…],[48,-126,4,…]], "RSA", "redirector.googlevideo.com")
  2527 ms  AndroidCertVerifyResult.getCertificateChainEncoded()
  2722 ms  AndroidNetworkLibrary.verifyServerCertificates([[48,-126,9,…],[48,-126,4,…]], "RSA", "r1---sn-bxuovgf5t-vnaz.googlevideo.com")
           /* TID 0x33a1 */
  2741 ms  AndroidNetworkLibrary.verifyServerCertificates([[48,-126,9,…],[48,-126,4,…]], "RSA", "r2---sn-bxuovgf5t-vnas.googlevideo.com")
           /* TID 0x339d */
  2758 ms  AndroidNetworkLibrary.verifyServerCertificates([[48,-126,9,…],[48,-126,4,…]], "RSA", "r2---sn-bxuovgf5t-vnaz.googlevideo.com")
           /* TID 0x33a1 */
  2771 ms  AndroidCertVerifyResult.getCertificateChainEncoded()
           /* TID 0x3417 */
  2772 ms  AndroidCertVerifyResult.getCertificateChainEncoded()
           /* TID 0x339d */
  2777 ms  AndroidCertVerifyResult.getCertificateChainEncoded()
  2892 ms  AndroidNetworkLibrary.verifyServerCertificates([[48,-126,6,…],[48,-126,4,…]], "RSA", "r2---sn-bxuovgf5t-vnas.googlevideo.com")
           /* TID 0x3417 */
  2908 ms  AndroidNetworkLibrary.verifyServerCertificates([[48,-126,6,…],[48,-126,4,…]], "RSA", "r2---sn-bxuovgf5t-vnaz.googlevideo.com")
           /* TID 0x33a1 */
  2926 ms  AndroidNetworkLibrary.verifyServerCertificates([[48,-126,6,…],[48,-126,4,…]], "RSA", "r1---sn-bxuovgf5t-vnaz.googlevideo.com")
           /* TID 0x3417 */
  2935 ms  AndroidCertVerifyResult.getCertificateChainEncoded()
           /* TID 0x339d */
  2937 ms  AndroidCertVerifyResult.getCertificateChainEncoded()
           /* TID 0x33a1 */
  2942 ms  AndroidCertVerifyResult.getCertificateChainEncoded()

此功能刚刚随 frida-tools 8.0 发布,可通过例如 pip3 install -U frida-tools 获取。

我们也一直努力从各方面改进质量。32 位 ARM 上的 Stalker 就是一个很好的例子,现在它在 Android 上运行得好得多,速度也快了很多;此前有一个错误会导致 Thumb 代码块被反复重新编译。我们还实现了其他 Stalker 后端采用的一项自适应优化,仅此一项通常就能带来约 5 倍的性能提升。

以上就是主要亮点。如果你对细节感兴趣,强烈建议阅读下面的变更日志。

祝使用愉快!

12.10.0 的变更

  • Java:添加 HotSpot JVM 支持。使用 JVMTI 枚举类和选择对象。如果 JVM 库含有符号(macOS 上的 JDK 默认如此),方法拦截即可工作。已在 macOS 上使用 Java 8、11、13、14 测试。感谢 @0xraaz!
  • Java:修复 _getUsedClass() 不返回的问题。不使用 Java.perform() 而连续调用两次 Java.use() 会使 _getUsedClass() 陷入无限休眠循环。感谢 @0xraaz!
  • Java:修复此前重构破坏的 $alloc()。
  • ObjC:添加 Block.declare(),以便处理没有签名元数据的 block。
  • ObjC:修复 12.9.8 引入的 ObjC pointer 处理回归。

12.10.1 的变更

  • Java:允许 ClassFactory.get(null),方便配合 enumerateMethods() 使用。
  • Java:恢复拉取请求中意外遗漏的 JVM 方法调整逻辑。感谢 @0xraaz!

12.10.2 的变更

  • 修复 i/macOS 上长符号名的处理。感谢 @mrmacete!
  • Java:修复静态/final 方法的 JVM 拦截问题。感谢 @0xraaz!
  • 修复 Stalker ARM 对 Thumb-2 “mov pc, <reg>” 的处理。
  • 修复 Stalker ARM 对易失 VFP 寄存器的处理。

12.10.3 的变更

  • 修复 Fruity 后端中设备移除事件的接线。感谢 @mrmacete!
  • 避免在 ArmWriter.put_branch_address() 中破坏 R9。
  • 添加 ThumbWriter.can_branch_directly_between()。
  • 添加 ThumbWriter.put_branch_address()。
  • 改进 ThumbRelocator 以处理 ADR。
  • 修复 Stalker ARM 代码块损坏。
  • 修复 Stalker ARM 针对 Thumb 代码块的回收逻辑。
  • 添加缺失的 Stalker ARM 延续逻辑,以支持较长的基本块。
  • 实现 Stalker ARM 回填逻辑,性能通常提高 5 倍。

12.10.4 的变更

  • 修复 V8 运行时中 Module.name 的编码。感谢 @mrmacete!

Frida 12.9 发布

上一个大型版本的主题是 Stalker。对还不熟悉它的用户来说,它本质上是一个代码跟踪引擎:可跟踪线程,捕获执行的每个函数、每个代码块,甚至每条指令。除了跟踪代码,它还允许在任意位置添加和删除指令,并运用高级 JIT 技巧使这一切非常快速。

这听起来可能仍有些抽象,来看几个例子。你可以用它确定“这个函数还调用了哪些函数”。或者,你想在应用代码的每条 RET 指令处,用 Apple 语音合成器读出 RAX 寄存器的值?这里展示了实现方式。这也是我 2017 年 r2con 演讲中的演示之一。

此前 Stalker 仅支持 Intel 架构和 ARM64。现在我非常高兴地宣布:Stalker 也支持 ARM32 了!🎉 希望这个大家期待已久的后端能推动更多人在 Stalker 之上构建很酷的项目。它的潜力远不止“代码跟踪”;结合 CModule 后,也很容易在快速原型、动态行为和性能之间取得平衡。

此版本有太多内容值得介绍。另一项重大变化是升级了所有依赖,其中最有趣的可能是 V8 8.4。这意味着无需用 frida-compile 编译 Agent,就能使用可选链和空值合并运算符等最新 JavaScript 特性。此外还有性能提升,V8 在这方面也持续进步。

我们还新增了 Android 11 Developer Preview 4 支持;即使在未越狱 iOS 上,现在也完全支持 iOS/arm64e 应用。所有受支持平台都有大量改进。特别值得强调的是,我们终于消除了影响 Duktape JS 运行时的长期资源泄漏;自从 Duktape 成为默认 JS 运行时起,这个错误就一直存在。

这些改进涉及的领域实在太多,无法逐一深入说明,请务必查看下面的变更日志。

尽情体验吧!

12.9.0 的变更

  • Stalker 现已支持 ARM32。🎉
  • Stalker JS 集成不再破坏 errno / LastError。
  • Stalker.follow() 现在在 x86 和 ARM64 上可靠工作,包括 Windows 上目标线程处于系统调用时。
  • Stalker 终于能在 WoW64 上可靠工作。感谢 @zuypt!
  • 所有依赖均升级到最新版本,其中最令人兴奋的是支持最新 JavaScript 特性的 V8 8.4。
  • 终于发现并修复长期存在的 Duktape 内存泄漏。感谢 @disazoz 提交促成突破的错误报告。
  • Socket.connect() 出错时不再泄漏文件描述符及相关内存(由 GLib 依赖升级修复)。感谢 @1215clf 报告!
  • Kernel.read*() 在 V8 运行时中不再泄漏。
  • UNIX 构建系统迁移到 Meson 0.54。
  • Windows 构建系统迁移到 VS2019。
  • 除 v10 和 v12 外,也提供 Node.js v14 预构建包。
  • 提供 Electron v8 和 v9 预构建包。
  • 提供 Fedora F32 软件包。
  • 提供 Ubuntu 20.04 软件包。
  • Python 绑定不再使用弃用 API。
  • 支持仅使用 leanback 的 Android 应用。感谢 @5murfette!
  • arm64e 支持未越狱 iOS 上无 closure 的 spawn()。感谢 @mrmacete!
  • iOS usbmux 配对记录 plist 解析现也支持二进制 plist,修复 Frida 拒绝有线连接 iOS USB 设备的长期问题。感谢 @pachoo!
  • arm64e 也支持 ObjC.choose()。感谢 @mrmacete!
  • ObjC.protocols 枚举终于能始终正确工作,而非仅第一次有效。感谢 @CodeColorist 报告!
  • 初步支持 Android 11 Developer Preview。感谢 @abdawoud!
  • 兼容 MUSL libc。
  • 支持旧版 glibc,使二进制文件可在更多桌面 Linux 系统上运行。
  • Libc shim 也覆盖 memalign() 并支持较新的 GNU 工具链。
  • Exceptor 的 POSIX 后端现在能在 ARM32 上正确检测 Thumb,避免此前的随机崩溃。
  • Exceptor 不再破坏 i/macOS 上的“rflags”(x86_64)和“cpsr”(ARM64),并提供对原生上下文的写访问。
  • libc shim 新增四个关键 i/macOS 64 位系统调用:read()、write()、mmap()、munmap()。感谢 @mrmacete!
  • 为方便使用,iOS 二进制文件现在使用“skip-library-validation”权限签名。感谢 @elvanderb!
  • frida-core Vala API 绑定不再缺少 frida.Error 类型。
  • 脚本处于 LOADING 状态时,现在允许向其 post() 消息,适用于脚本需在 load() 期间发起同步请求的场景。感谢 @Gbps!
  • Gadget 终于支持在 64 位 ELF 目标上通过 V8 运行时进行早期插桩;此前构造函数会以错误顺序运行。感谢 @tacesrever!
  • Device.open_channel() 支持 TCP 之外的 ADB 通道。感谢 @aemmitt-ns!
  • ArmWriter 和 ThumbWriter API 支持多条新指令。
  • 大幅改进 ARM32 重定位器实现。
  • 通过加载器调用时,Linux 模块枚举可正常工作。
  • 改进 Linux 符号解析。
  • 改进 V8 运行时的参数列表处理,使 undefined 与 Duktape 运行时的行为一致。感谢 @mrmacete!
  • CModule Stalker API 恢复正常。
  • CModule 运行时现公开 Thread.{get,set}_system_error()。
  • CModule 在 Linux/MIPS 上现在提供桩实现,不再因 TinyCC 尚不支持 MIPS 而编译失败。
  • 配置 Capstone 以支持 ARMv8 A32 编码。

12.9.1 的变更

  • Python 绑定的 setup.py 现在能在 macOS 上正确处理 Python 3.x。

12.9.2 的变更

  • Fruity(iOS USB)后端不再向 stdio 输出警告。

12.9.3 的变更

  • 支持 Android 11 Developer Preview 4。感谢 @enovella_ 协助!
  • Linux 文件监控恢复良好状态。
  • ArmRelocator 可正确重定位涉及 PC 寄存器的 ADD 指令。
  • ThumbRelocator 可正确处理包含无条件分支的 IT 块,使 Interceptor 能 Hook 更多棘手情况。感谢 @bet4it!
  • Stalker ARM32 在 Thumb 模式下也支持 clone 系统调用。
  • Stalker ARM32 现在像 ARM64 后端一样抑制独占操作周围的事件。
  • Stalker ARM32 支持信任阈值。
  • 改进 ObjC 和 Java 桥接的错误处理,避免在不受支持的操作系统上导致进程崩溃。

12.9.4 的变更

  • Objective-C 运行时实际不可用时,ObjC.available 不再错误地声称可用。12.9.3 的错误处理重构破坏了这一点,而测试覆盖的盲区使回归未被发现。
  • Electron v9 已发布,因此现在只提供 v9 预构建包。

12.9.5 的变更

  • 最新 unc0ver 支持 iOS 早期插桩,即 spawn()。
  • iOS 崩溃报告器集成已移植到 iOS 13.5。
  • SystemFunction 现在不仅在 V8 运行时,也在 Duktape 运行时实现 call() 和 apply()。
  • Java 桥接终于能处理内嵌 nul 的字符串,修复自 Java 桥接诞生以来就存在的长期问题。感谢 @tacesrever!

12.9.6 的变更

  • 除了正确的 Windows 二进制文件外没有其他变化。上次 Windows CI worker 实际没有构建任何内容,发布了过期二进制文件。

12.9.7 的变更

  • unc0ver 越狱上的 iOS 早期插桩更加可靠:现在会在早期插桩中加载 substrate-inserter.dylib,让它有机会引导进程,并允许 Hook 引导程序已 Hook 的系统 API,无需担心引导程序遇到你的 Hook 时混乱。感谢 @mrmacete!

12.9.8 的变更

  • ApiResolver 实现现在支持在查询字符串后追加“/i”进行不区分大小写的匹配。感谢 @Hexploitable!
  • module ApiResolver 不再泄漏 MatchInfo 实例。
  • CModule 运行时新增 GLib.PatternSpec 和 GLib UTF-8 大小写辅助函数。
  • 新增 DebugSymbol.load(),可显式加载调试符号。目前仅在 Windows 上实现;Windows 还支持“module!symbol”记法,以提升性能和精度。感谢 @ohjeongwook!
  • Java 桥接新增 API:Java.enumerateMethods(query),可高效定位匹配指定查询的方法。
  • ObjC.choose() 不再因仅能在 V8 运行时复现的生命周期问题而崩溃。

Frida 12.8 发布

准备迎接一个令人兴奋的新版本。这一次,我们终于为长期缺少关爱的 Stalker 引擎 带来大量改进。它已经存在约十年,但直到 2017 年末发布 Frida 10.5 时,我们才 开始释放它的巨大潜力。

此前,我们可以对现有线程调用 Stalker.follow(),不仅观察线程,还能以任意方式修改其 指令流。它也可以与 Interceptor 结合,在选定的关键点之间对当前线程进行插桩。这使我们 得以构建 AirSpy 等工具。

但是,如果想对一次 NativeFunction 调用执行 Stalker.follow() 呢?这看起来很简单, 重入问题却让它极其困难。我们很容易一路跟踪到私有堆等内部执行路径,随后又需要为插桩 本身分配内存……由此产生的各种场景复杂得令人头疼。

我们的解决办法是让 Stalker 能够排除特定内存范围。发现调用进入这类位置时,它只会在 那里发出一条调用指令,而不会继续跟踪执行。我们自动排除了 frida-agent 自身的内存范围, 从而无需处理那些棘手的重入问题。

我们还专门处理了对当前线程调用 Stalker.follow() 的情况:将这项工作排队,直到即将离开 我们的运行时并返回用户代码时再执行;对于 JS 线程,则是在返回主循环时执行。

但如何结合使用 Stalker 与 NativeFunction 仍是一个悬而未决的大问题。现在终于解决了:

const open = new NativeFunction(
    Module.getExportByName(null, 'open'),
    'int', ['pointer', 'int'],
    { traps: 'all' }
);

Stalker.follow({
  events: {
    call: true
  },
  onReceive(e) {
    console.log(JSON.stringify(Stalker.parse(e)));
  }
});

const fd = open(Memory.allocUtf8String('/foo/bar'), 0);
console.log('open() =>', fd);

为 NativeFunction 设置 traps: 'all' 选项后,如果调用来自一个因进入排除范围而暂时 暂停 Stalker 的线程,它就会重新激活 Stalker。本例正是如此,因为 frida-agent 的所有 代码都被标记为排除。

Objective-C 方法也能实现相同效果:

Stalker.follow({
  events: {
    call: true
  },
  onReceive(e) {
    console.log(JSON.stringify(Stalker.parse(e)));
  }
});

const NSAutoreleasePool = ObjC.classes.NSAutoreleasePool;
const NSFileManager = ObjC.classes.NSFileManager;

const fileExistsAtPath = NSFileManager['- fileExistsAtPath:']
    .clone({ traps: 'all' });

const pool = NSAutoreleasePool.alloc().init();
try {
  const manager = NSFileManager.defaultManager();
  const result = fileExistsAtPath.call(manager, '/foo/bar');
  console.log('fileExistsAtPath() =>', result);
} finally {
  pool.release();
}

Android 上的 Java 方法也一样:

Stalker.follow({
  events: {
    call: true
  },
  onReceive(e) {
    console.log(JSON.stringify(Stalker.parse(e)));
  }
});

Java.perform(() => {
  const JFile = Java.use('java.io.File');
  const exists = JFile.exists.clone({ traps: 'all' });

  const file = JFile.$new('/foo/bar');
  const result = exists.call(file);
  console.log('exists() =>', result);
});

太棒了。不过,这些示例只触及了 Stalker 能力的表面。进程内模糊测试是一个非常酷的 用例,frida-fuzz 就是很好的例子。其他用例还包括逆向分析、代码覆盖率测量、用于 测试的故障注入、挂钩内联系统调用等。

这就是本次发布的主线。感谢 @andreafioraldi 提供出色的错误报告,并帮助测试这些 棘手的变更。

收尾

另一个值得一提的新功能是 ArrayBuffer.wrap() API,它让你能够像访问 JavaScript 数组一样,方便而高效地访问内存区域:

const header = Memory.alloc(16);

const bytes = new Uint8Array(ArrayBuffer.wrap(header, 16));
bytes[0] = 1;
bytes[0] += 2;
bytes[1] = 2;

console.log(hexdump(header, { length: 16, ansi: true }));
console.log('First byte is:', bytes[0]);

这意味着可以把直接内存访问交给 JavaScript API,无需在运行时内外复制内存。唯一缺点是, 无效指针不会产生 JS 异常,而会导致进程崩溃。

现在还可以通过 ArrayBuffer 新增的 unwrap() 方法访问任意 ArrayBuffer 的后备存储。 例如,使用 frida-fs 等现有模块获得 ArrayBuffer 后,可以将其传给原生代码。

感谢 @DaveManouchehri 贡献 ArrayBuffer.wrap() API 的初稿,也特别感谢 @CodeColorist 提议并协助完善 unwrap() 功能。

12.8.0 中的变更

  • Stalker 重新激活功能可正常工作。
  • 正确处理 Stalker 线程生命周期;在 i/macOS 上跟踪线程直至其终止时不再崩溃。
  • Stalker 采用更安全的垃圾回收逻辑。
  • Stalker transform 回调出错并抛出 JS 异常时,现在会触发 Stalker.unfollow(),避免错误 因进程崩溃而被吞掉。
  • 稳健支持从 Stalker transform 中调用 unfollow()。
  • Stalker 支持不具备 AVX2 的旧款 x86 CPU。
  • 支持禁用 Stalker 队列自动排空。
  • NativeFunction 通过全新的 Interceptor 栈展开 API 更好地处理异常。
  • Java 和 ObjC API 可为方法通过 clone(options) 指定 NativeFunction 选项,并可通过 ObjC.Block() 的第二个参数为 block 指定选项。
  • ObjC 类和协议缓存逻辑终于可以正常工作。感谢 @gebing!
  • Windows 预构建 Python 3 扩展终于像其他平台一样,支持 Windows 上所有 >= 3.4 的 Python 3 版本。
  • ArrayBuffer wrap() 与 unwrap()。
  • DebugSymbol API 在 Linux/Android 上具备更好的错误处理。
  • Android 10 系统进程中的 Java 集成不再于 recompileExceptionClearForArm64() 崩溃。
  • i/macOS 上的 GumJS devkit 再次支持 V8。

12.8.1 中的变更

  • CModule 的 Stalker 集成恢复正常。

12.8.2 中的变更

  • Thumb IT 块终于能够正确重定位。这意味着可在 Android 等 32 位 ARM 目标上挂钩更多 函数。感谢 @bigboysun!

12.8.3 中的变更

  • 引入 Java.ClassFactory.get(),以便同时使用多个类加载器而无需担心类名冲突。因此, 给 loader 属性赋值现已视为弃用。为保持向后兼容仍会保留该属性,但不支持与新 API 同时使用。
  • Java.enumerateLoadedClasses() 除名称外也会提供类句柄。
  • JNI 的 GetByteArrayRegion() 函数现已纳入 Env 包装器。感谢 @iddoeldor!

12.8.4 中的变更

  • 当 PLT/GOT 条目尚未预热时,内部 hook 不再导致 Linux/ELF 目标崩溃。

12.8.5 中的变更

  • Python 绑定终于能在 Python 2.x 上提供正确编码的错误消息。

12.8.6 中的变更

  • Android linker 检测终于能在沙箱进程中再次正常工作。这是 12.7.8 引入的回归。 感谢 @DaveManouchehri 报告并协助定位!

12.8.7 中的变更

  • Node.js IOStream 绑定获得两项关键稳定性改进。取消逻辑中存在竞态条件,导致 cancellable 并非总会被使用;teardown 逻辑中也有一个错误,可能在所有 I/O 操作完成 前关闭流。感谢 @mrmacete 提供这些出色修复!

12.8.8 中的变更

  • 在 Android/Linux 的早期插桩场景中,即使调用 Gadget 入口点时持有动态链接器锁, Gadget 也不再死锁。由于 Exceptor 现在使用 dlsym() 避免早期插桩期间的 PLT/GOT 问题,必须确保从入口点线程而非 Gadget 线程初始化 Exceptor。

12.8.9 中的变更

  • Stalker 的 JavaScript 集成不再于 EventSink::stop() 中发生释放后使用,即 Stalker.unfollow() 之后的释放后使用。

12.8.10 中的变更

  • Gadget 再次能够在没有调试器的 iOS 上运行。这是 12.8.8 引入的回归。感谢 @ddzobov 报告!

12.8.11 中的变更

  • 当 Mach 异常处理 API 的使用者只请求部分处理器时,i/macOS Exceptor 的 API hook 不再发生越界写入。这类使用者通常是崩溃报告器或分析框架。
  • 现在为 Electron v8(稳定版)和 v9(测试版)提供预构建包,不再为 v7 提供。

12.8.12 中的变更

  • 大幅重构 Android Java 集成,现在使用 Proxy 对象和 CModule 延迟解析内容;也不再使用 eval 动态生成方法与字段包装器,因此每个生成的包装器所需内存更少。这些变更降低了 内存用量,并让 Java.use() 更快完成。
  • 在试图隐藏私有 API 的 Android 版本(即 Android >= 9)上,Android Java 集成可不受 限制地访问方法和字段。
  • Android 设备枚举速度大幅提高。当本地 ADB 守护进程足够新(即 2017 年某个时间点之后 的 ADB)时,不再运行任何 adb shell 命令来确定设备名称。
  • 终于消除了 Linux 类操作系统上一个长期存在的内存泄漏,它会影响新版 Android 中 zygote 和 system_server 等受限进程。问题出在线程退出后不久回收线程局部数据的 逻辑:判断线程确实完成退出的机制会失败,永远不认为线程已经消失。这会造成垃圾不断 堆积,需要遍历的垃圾集合越来越长。我们不仅会在徒劳的 GC 尝试上花费越来越多时间, 还会因每 50 毫秒重试一次 GC 而消耗 CPU。
  • Python 绑定允许从 Cancellable 获取文件描述符,以便集成到事件循环和其他 poll() 风格的场景中。值得一提的是,frida-tools 7.0.1 已基于此带来一项重大改进:CLI 工具 退出前不再延迟最多 500 毫秒,因此 frida-ls-devices 和 frida-ps 等短生命周期 程序现在响应非常迅速。
  • Duktape 的 source map 处理现在也适用于 REPL 加载的脚本。由于 REPL 会附加自己的代码, 内联 source map 并不位于脚本最后一行;现在堆栈跟踪始终包含有意义的文件名和行号。
  • Duktape:内置 JavaScript 运行时(即 GumJS 胶水代码、ObjC 和 Java)现在使用启用 loose 选项的 Babel 处理,以减小体积并提高性能。API 不会泄漏现代 JavaScript 数据结构,因此无需让 Babel 完全符合规范。
  • V8:压缩内置 JavaScript 运行时,以减小占用并提高代码速度。此前仅对 Duktape 执行。
  • 改进 enumerate_processes() 中的 Linux 进程名启发式规则。

12.8.13 中的变更

  • Java.performNow() 恢复正常工作。
  • Python 绑定的 setup.py 现在会先查找本地 .egg,再尝试下载,并要求下载在两分钟内 完成。感谢 @XieEDeHeiShou 提供这些改进!

12.8.14 中的变更

  • 现在正确支持 iOS 模拟器,包括 Gadget 形式,以及从 macOS 附加到运行中的模拟器进程。 感谢 @insitusec 协助修复这些问题!
  • Gadget 现在也会在 iOS 上向上一级目录查找 .config,但仅当其父目录名为 “Frameworks”时如此。感谢 @insitusec 的建议!

12.8.15 中的变更

  • 全新且功能完整的 iOS/arm64e 支持,包括新的 NativePointer 方法:sign()、 strip()、blend()。
  • 现在支持最新版 iOS Unc0ver 越狱。感谢 @mrmacete 提交拉取请求,并感谢 @Pwn20wnd 协助!❤️
  • 改进 Chimera 越狱支持,确保初始化 pspawn_payload-stg2.dylib。感谢 @mrmacete!
  • 当 agent 入口点立即返回时,i/macOS 注入器不再失败。
  • 改进受限 iOS 需要 Gadget 时的错误消息。
  • 改进 Windows 注入器的错误处理,避免 DLL 注入失败时导致目标进程崩溃。感谢 @dasraf9!
  • 支持注入 i/macOS 上仍在运行的新生目标;同时不再一律认为挂起进程需要为注入做准备。
  • 改进 iOS 容错,可处理查询最前端 iOS 应用名称失败的情况。
  • 改进 Android 容错;zygote 和 system_server 进程终止后无需重启 frida-server。
  • 现在可在 Android 10 启动期间运行 frida-server,因为 LD_LIBRARY_PATH 不再干扰 frida-helper-32 的启动。感谢 @enovella 协助定位!
  • 在类 UNIX 平台上无法处理 SIGABRT 时不再陷入无限循环。
  • Exceptor 的 POSIX 后端现在支持嵌套信号。感谢 @bannsec!
  • 正确处理无效的 Windows ANSI 字符串。感谢 @clouds56!
  • Java.perform() 在 Android < 5 上重新正常工作。
  • 改进 NativeFunction 的可变参数处理,现在会提升小于 int 的可变参数。感谢 @0x410c 报告!

12.8.16 中的变更

  • 大型 CModule 实例现在可在使用 16K 页的 iOS 系统上工作。感谢 @mrmacete 发现并 修复这个长期存在的问题!
  • Stalker 也可在 iOS/arm64e 的 arm64 进程中工作。感谢 @AeonLucid 报告并协助定位!

12.8.17 中的变更

  • 对 i/macOS 上仍在运行的新生目标的注入支持引发了回归,因此暂时撤销。具体而言, iOS 12.4 的 notifyd 不会设置 libSystemInitialized。需要进一步调查原因, 因而目前先回退这部分逻辑。

12.8.18 中的变更

  • 全新改进的 Java.scheduleOnMainThread(),可调用 getApplicationContext() 等 API。 感谢 @giantpune 报告!
  • 能够在新版 Android 上挂钩 CriticalNative 方法。感谢 @abdawoud 报告!

12.8.19 中的变更

  • 如果脚本未经加载就被销毁,现在会得到正确清理。这样最终释放脚本核心时,也会释放其 对 Exceptor 的引用。此前若存在未加载脚本,Exceptor 线程会留在目标进程中,导致 detach 后再次 attach 时无限挂起。感谢 @mrmacete 发现并修复这个长期问题!

12.8.20 中的变更

  • remove_remote_device() API 恢复正常工作。这是 12.7.17 不幸引入的回归。感谢 @CodeColorist 报告!

Frida 12.7 发布

这次只有一项新功能,但它分量十足。我们要直面那个一直存在却少有人谈的问题:性能。

Frida 的插桩核心 Gum 使用 C 编写,也可以从 C 中使用;不过对于大多数场景,使用其 JavaScript 绑定会更合适。

然而,在某些情况下性能会成为问题。即使使用基于 V8 的运行时——这意味着 JavaScript 在运行时会接受性能分析,并根据热点位置进行优化……(顺便说一句,这实在令人惊叹,V8 真是一项了不起的工程成就!)

……进入和离开 JavaScript VM 仍要付出少量代价。在 iPhone 5S 上,如果使用 Interceptor.attach(),只指定空的 onEnter,这项开销大约是六微秒。

这听起来可能不多,但如果一个函数被调用一百万次,就会增加 6 秒开销。而 hook 可能只需做一件极其简单的事,因此大部分时间其实都花在进入和离开 VM 上。

需要向 API 传递回调时也有同类问题:API 可能遍历数百万个项目,并为每项调用一次回调;回调也许只是查看一个字节,再收集少数符合特定条件的项目。

最直接的做法是使用 NativeCallback 实现该回调,但很快就会发现这种方式无法扩展。

又或者,你正在编写模糊测试器,需要在紧密循环中调用 NativeFunction;进入/离开 VM 再加上 libffi 的成本会不断累积。

除了用 C 编写整个 agent,还可以构建原生库,并使用 Module.load() 加载。这确实可行,但意味着必须为每一种架构编译并部署到目标等。

另一种方案是使用 X86Writer/Arm64Writer 等 API 在运行时生成代码。这同样很痛苦,因为支持每种架构都需要大量工作。但直到现在,对于 frida-java-bridge 等模块来说,这仍是唯一可移植的选择。

而现在,我们终于有了好得多的方案:CModule 登场:

CModule Hello World 示例

它接收包含 C 源代码的字符串,将其编译为机器码并直接写入内存。该功能使用 TinyCC 实现,因此只给 Frida 增加约 100 kB 的体积。

如图所示,所有全局函数都会自动导出为 NativePointer 属性,名称与 C 源代码中完全相同。

而且,它很快:

CModule 速度

(在主频 3.1 GHz 的 Intel i7 上测得。)

还可以将这项新功能与 Interceptor 等 API 结合使用:

const m = new CModule(`
#include <gum/guminterceptor.h>

#define EPERM 1

int
open (const char * path,
      int oflag,
      ...)
{
  GumInvocationContext * ic;

  ic = gum_interceptor_get_current_invocation ();
  ic->system_error = EPERM;

  return -1;
}
`);

const openImpl = Module.getExportByName(null, 'open');

Interceptor.replace(openImpl, m.open);

(请注意,本例及后续示例使用了模板字面量等现代 JavaScript 特性,因此需要在 V8 运行时上执行,或使用 frida-compile 编译。)

还可以将它与 Interceptor.attach() 结合:

const openImpl = Module.getExportByName(null, 'open');

Interceptor.attach(openImpl, new CModule(`
  #include <gum/guminterceptor.h>
  #include <stdio.h>

  void
  onEnter (GumInvocationContext * ic)
  {
    const char * path;

    path = gum_invocation_context_get_nth_argument (ic, 0);

    printf ("open() path=\\"%s\\"\\n", path);
  }

  void
  onLeave (GumInvocationContext * ic)
  {
    int fd;

    fd = (int) gum_invocation_context_get_return_value (ic);

    printf ("=> fd=%d\\n", fd);
  }
`));

太棒了。不过最后这个示例实际上会写入目标进程的 stdout;调试时这样做没有问题,但可能并不十分实用。

可以通过回调 JavaScript 来解决。来看看具体写法:

const openImpl = Module.getExportByName(null, 'open');

Interceptor.attach(openImpl, new CModule(`
  #include <gum/guminterceptor.h>

  extern void onMessage (const gchar * message);

  static void log (const gchar * format, ...);

  void
  onEnter (GumInvocationContext * ic)
  {
    const char * path;

    path = gum_invocation_context_get_nth_argument (ic, 0);

    log ("open() path=\\"%s\\"", path);
  }

  void
  onLeave (GumInvocationContext * ic)
  {
    int fd;

    fd = (int) gum_invocation_context_get_return_value (ic);

    log ("=> fd=%d", fd);
  }

  static void
  log (const gchar * format,
       ...)
  {
    gchar * message;
    va_list args;

    va_start (args, format);
    message = g_strdup_vprintf (format, args);
    va_end (args);

    onMessage (message);

    g_free (message);
  }
`, {
  onMessage: new NativeCallback(messagePtr => {
    const message = messagePtr.readUtf8String();
    console.log('onMessage:', message);
  }, 'void', ['pointer'])
}));

不过这只是玩具示例:这样做实际上违背了用 C 编写 hook 来提升性能的初衷。真正的实现可以先获取 GLib.Mutex,再追加到 GLib.Array,并通过回调 JS 定期刷新缓冲数据。

就像可以从 C 调用 JavaScript 函数一样,也可以在两个世界之间共享数据:

const calls = Memory.alloc(4);

const openImpl = Module.getExportByName(null, 'open');

Interceptor.attach(openImpl, new CModule(`
  #include <gum/guminterceptor.h>

  extern volatile gint calls;

  void
  onEnter (GumInvocationContext * ic)
  {
    g_atomic_int_add (&calls, 1);
  }
`, { calls }));

setInterval(() => {
  console.log('Calls so far:', calls.readInt());
}, 1000);

目前还没有内置 C API 的文档,但可以浏览 frida-gum/bindings/gumjs/runtime/cmodule 中的头文件来了解概况。对于 GLib 等非 Frida API,可以把函数名放进互联网搜索引擎查找文档。

我们的目标是只公开标准 C 库、GLib、JSON-GLib 和 Gum API 的最小子集,以尽量减小体积并最大化性能。纳入的功能应当是无法通过调用 JS 实现,或以这种方式实现时成本高得难以接受的功能。

可以把 JS 端想象成操作系统,接入其中的函数就是系统调用;CModule 只应用于 hook 高频函数,或实现高性能粘合代码,例如传给性能敏感 API 的回调。

还要记住,TinyCC 生成的机器码不如 Clang 或 GCC 高效,因此计算密集型算法用 JavaScript 实现反而可能更快(使用基于 V8 的运行时时)。但对于 hook 和粘合代码,这种差异并不显著;如果需要优化内层循环,随时可以使用 Arm64Writer 等生成机器码并接入 CModule。

一个重要限制是所有数据都只读,因此可写全局变量应声明为 extern,使用 Memory.alloc() 等方式分配,并通过构造函数的第二个参数以符号形式传入。(就像上一个示例中的 calls。)

CModule 被销毁时(例如脚本被卸载),可能还需要初始化并清理某些内容;为此我们提供了两个生命周期 hook:

const cm = new CModule(`
#include <stdio.h>

void
init (void)
{
  printf ("init\\n");
}

void
finalize (void)
{
  printf ("finalize\\n");
}
`);

cm.dispose(); // or wait until it gets GCed or script unloaded

总之,这篇文章越来越长了;不过在结束之前,先看看如何将 CModule 与 Stalker API 配合使用:

const cm = new CModule(`
#include <gum/gumstalker.h>

static void on_ret (GumCpuContext * cpu_context,
    gpointer user_data);

void
transform (GumStalkerIterator * iterator,
           GumStalkerOutput * output,
           gpointer user_data)
{
  cs_insn * insn;

  while (gum_stalker_iterator_next (iterator, &insn))
  {
    if (insn->id == X86_INS_RET)
    {
      gum_x86_writer_put_nop (output->writer.x86);
      gum_stalker_iterator_put_callout (iterator,
          on_ret, NULL, NULL);
    }

    gum_stalker_iterator_keep (iterator);
  }
}

static void
on_ret (GumCpuContext * cpu_context,
        gpointer user_data)
{
  printf ("on_ret!\n");
}
`);

const mainThread = Process.enumerateThreads()[0];

Stalker.follow(mainThread.id, {
  transform: cm.transform,
  data: ptr(1337)
});

这展示了如何用 C 同时实现 transform 回调和 callout;也可以采用混合方式,用 JS 编写 transform 回调,只用 C 编写部分 callout。

还值得一提的是,我重写了 ObjC.choose(),让它使用 CModule,现在速度大约提升了 100 倍。在 iPhone 6S 上用 Twitter 应用登录界面测试时,耗时从约 5 秒缩短到约 50 毫秒。

希望你喜欢这个版本。我很期待看到大家使用新的 CModule API 构建出怎样的东西。我尤其期待改进 REPL,让它支持在 .js 旁加载 .c 文件,以便快速制作原型。

祝使用愉快!

12.7.0 的变更

  • 全新 CModule API,由 TinyCC 驱动。(你刚刚已经读过相关介绍。)
  • 改进 TinyCC,以支持 macOS/x86 上的 Apple ABI。
  • 现在向 JS 公开 Stalker.exclude(),可以将特定内存范围标记为排除。这有助于提升性能并减少噪声。
  • 现在支持并发调用 Java.use(),感谢 @gebing 的精彩贡献。
  • 改进 hexdump() 实现,将 length 选项限制在 ArrayBuffer 长度以内,再次感谢 @gebing 的精彩贡献。

12.7.1 的变更

  • 更多 CModule 功能,包括 GLib.String、GLib.Timer 和 Json.Builder。
  • 改进 TinyCC,以支持 iOS/arm64 上的 Apple ABI。
  • 使用 CModule 重写 ObjC.choose(),现在速度约快 100 倍。

12.7.2 的变更

  • 为 CModule 补充了一些缺失的引用计数 API。

12.7.3 的变更

  • 现在会正确隐藏 CModule 内存范围。
  • 现在会将外部分配的 CModule 内存告知 V8 垃圾回收器,使其能更好地决定何时执行 GC。
  • 附加到 CModule 的符号现在也会在 V8 运行时中正确保持存活;CModule 自身也不再无限期(或直到脚本卸载)保持存活。
  • 添加 CModule.dispose(),用于主动清理内存。

12.7.4 的变更

  • frida-inject 工具现在支持 spawn()。感谢 @hunterli 贡献这项实用功能。
  • 在 i/macOS 上仍持有 JS 锁时调用 thread_suspend(),V8 运行时不再发生死锁;要求 Stalker.follow() 跟踪另一线程时会间接触发这种情况。

12.7.5 的变更

  • 全新 channels API,用于与已连接的 iOS 或 Android 设备建立 TCP 连接,也可与已连接 iOS 设备上的 lockdown 服务通信。
  • DeviceManager.find_device() 及其同类方法背后的超时逻辑现在可以正常工作。
  • java.lang.Class 的 Java 编组现在可以正常工作,也可以在没有实例的情况下内省实例字段。感谢 @gebing 贡献这些精彩修复!

12.7.6 的变更

  • 现在可在 Android 10 上正确检测 Android linker。
  • Android SELinux 策略修补器现在也能处理 Samsung S10 等设备,感谢 @cbayet 的精彩贡献。
  • frida-inject 工具现在支持 -D/–device,可用于非本地设备。
  • 改进错误处理,避免 i/macOS 进程在早期插桩期间意外终止时导致崩溃。
  • iOS 崩溃报告器集成更加健壮,感谢 @mrmacete 贡献的出色修复。其中一项还确保针对同一消息类型并行调用 recv().wait() 时不会无限等待。
  • Linux/arm64 现在支持跟踪线程创建。感谢 @alvaro_fe 的出色贡献!
  • V8 运行时的 WebAssembly 支持现在也能在非 iOS 平台上正常工作。
  • Gum.DarwinModule API 现已成为跨平台 Gum API 的一部分,可用于在非 Apple 系统上解析 Mach-O 文件。

12.7.7 的变更

  • 关闭最后一个会话时,现在会保留永久化 agent;只要 HostSession 端(例如 frida-server)仍然存在,就可以复用它们。很多情况下因此能避免创建额外的 frida-agent 副本。感谢 @mrmacete 的出色改进。
  • 方法返回 this 时,Java bridge 不再触发释放后使用。
  • Android SELinux 策略修补器不再在旧版 Android 上打印警告。这项无害但令人困惑的回归由上一版本针对 Samsung S10 ROM 的修复引入。
  • 改进与 SELinux 相关的错误消息。
  • 初步支持 iOS/arm64e。

12.7.8 的变更

  • 得益于 @Alien-AV 的杰出贡献,Java bridge 现已支持 Android 10。
  • 改进 Android 应用的 spawn() 处理:应用没有启动器 activity 时可以使用 activity 参数。这项实用改进由 @muhzii 贡献。
  • 得益于 @timstrazz 的优雅贡献,Android linker 查找逻辑已具备面向未来的适应性。
  • 大幅提高 iOS 上的容错能力:launchd agent 卸载时现在会终止待处理进程。这意味着 frida-server 退出后不会留下卡在暂停状态的进程。感谢 @mrmacete 的出色改进。

12.7.9 的变更

  • 修复上一版本最后一刻混入的构建回归,macOS 上恢复正常。

12.7.10 的变更

  • MemoryAccessMonitor 现在可用于所有平台,甚至支持 Duktape 运行时。感谢 @alvaro_fe 的出色改进。
  • Android linker 检测恢复正常。(12.7.8 引入的回归。)
  • 改进 Gadget,支持在 i/macOS 上通过构造函数传入配置。
  • 移除 Gadget 仅在 i/macOS 上实现的系统循环集成,以避免某些场景下的未定义行为。

12.7.11 的变更

  • Frida 不再在没有 vDSO 的 Android 进程中崩溃。(12.7.8 引入的回归。)
  • 改进解析 Mach-O 映像时的错误处理。
  • 在 i/macOS 上恢复异常时正确处理 ARM 与 Thumb。感谢 @alvaro_fe!
  • CModule 的 JSON-GLib 头文件现在按预期实现自包含。

12.7.12 的变更

  • 完整的 iOS lockdown 集成和统一设备,使基于 Frida 的工具不必过多考虑受限设备与越狱设备的差异。与受限 iOS 设备交互时,现在会自动注入 Gadget,无需重新打包应用,只需保证应用可调试。
  • Frida 终于可以在 Windows 上检测较新的 iOS 设备。
  • 定位了 V8 中的错误,并从上游回移修复。感谢 @mrmacete 找到这个问题!

12.7.13 的变更

  • 改进 frida-objc-bridge 中结构体和联合体的处理。感谢 @gebing!
  • Node.js 绑定现在也公开 Crash 和 CrashParameters 的类型定义。
  • 尝试附加受限 iOS 上的系统会话时会提前抛出异常,并提供更清晰的错误消息。
  • 调整与 iOS Developer Disk Image 相关的错误消息,使其保持一致。

12.7.14 的变更

  • 在 Android >= 10 上访问代码前,Frida 现在会确保代码可读。这是完整支持 Android 10 所缺的最后一块拼图。能够插桩系统进程意味着早期插桩(即 spawn())可以工作;启动 frida-server 时,也不会因为它试图预加载以加速第一次 spawn() 而使 system_server 崩溃。感谢 @Alien-AV 和 @esanfelix 的艰苦研究,让这个解决方案得以在某个周六深夜完成实现。:-)

12.7.15 的变更

  • Node.js 绑定也公开 Crash 类型中的“summary”字段。

12.7.16 的变更

  • frida-gadget-ios 元软件包附带类型定义,因此可从 TypeScript 中使用。
  • Node.js 绑定为 Stdio 和 ChildOrigin 提供正确的类型。

12.7.17 的变更

  • 更健壮地支持受限 iOS:现在可以在 attach() 之后、resume() 之前正确调用 kill()。
  • 条件允许时,Frida 现在会直接与远程 iOS/Android agent 通信。实现方式是与 frida-server 建立新的 TCP 连接,并把其文件描述符传给 agent。这样 frida-server 就能退出数据路径,提高性能和可靠性。
  • 客户端连接 frida-server 并 spawn() 进程后,如果还没来得及 resume() 或 kill() 就断开连接,不会再留下悬而未决的孤儿进程。现在会跟踪已生成进程,并在客户端突然断开时将其终止。
  • 不再导致 Android 10 上的 Zygote 崩溃。事实证明缺少了一条 SELinux 规则。
  • TCP 套接字现在设置了 TCP_NODELAY;除了 TCP,还支持使用 UNIX 套接字与远程 frida-server 或 frida-gadget 通信。
  • NativeFunction 现在支持可变参数函数,不再需要为每种唯一的参数列表签名创建一个实例。感谢 @gebing!

12.7.18 的变更

  • Node.js 绑定终于会在 UNIX 上链接所需的 OpenSSL 符号,不再依赖运气——以前通常只是碰巧所在进程已加载另一个全局可见且 ABI 兼容的 OpenSSL(!)。

12.7.19 的变更

  • 现在也能在 V8 运行时中正确处理对无参数 NativeFunction 调用 apply() 的情况。感谢 @taviso 报告这个长期存在的错误。
  • NativeFunction 在 call() 和 apply() 中处理可选参数的行为,现在与内置版本一致。

12.7.20 的变更

  • Frida 现在同时支持明文和加密的 iOS lockdown 通道;在通道地址后附加“?tls=handshake-only”,仍可使用“TLS 握手后转明文”形式的通道。感谢 @mrmacete!
  • 使用“lockdown:”作为通道地址,可以访问配对的 lockdown 通道本身。感谢 @mrmacete!

12.7.21 的变更

  • 现在支持使用 checkra1n 越狱的 iOS 13。(此前已经支持受限 iOS 13。)

12.7.22 的变更

  • iOS 软件包脚本的启动守护进程逻辑现在兼容 checkra1n,因此不必手动启动/停止 frida-server。

12.7.23 的变更

  • 增强对 checkra1n 越狱的支持:Stalker 现在利用 RWX 页面,速度大幅提升。
  • 提高在不支持 RWX 的 iOS 越狱环境中使用 Stalker 时的稳定性。感谢 @mrmacete!
  • CModule 现在兼容更多 iOS 越狱方案。感谢 @mrmacete!
  • CModule 运行时支持使用 ModuleMap 对象。
  • 得益于 Jon Wilson 的出色贡献,现在支持 ARMBE8。
  • 在 i/macOS 上 spawn() 时,Frida 现在会让子进程能够使用父进程文件描述符,与 Linux 当前行为一致。感谢 @wizche!

12.7.24 的变更

  • 也为 Node.js v13 提供预构建包。

12.7.25 的变更

  • 作为一项关键修复,全面调整 Python 和 Node.js 绑定中的日志处理程序 API:Node.js setter 的类型与 getter 不同,因为 setter 还允许 null。这种不一致会导致新版 TypeScript 编译器报错。感谢 @mrmacete!
  • V8 平台集成不再截断时间戳。感谢 @DaveManouchehri 报告问题!
  • Module.enumerateSymbols() API 会在可用时提供“size”属性,目前仅限 Linux/Android。感谢 @DaveManouchehri!
  • 现在可以使用 Java.use(name, { cache: ‘skip’ }) 绕过缓存,在处理多个类加载器和冲突类名时很有用。感谢 @ChaosData 和 @H4oK3!

12.7.26 的变更

  • Stalker 现在支持临时重新激活,从而可以跟踪排除内存范围内部的代码。
  • NativeFunction 新增 traps: 'all' 选项,即使 Frida 自身内存范围被标记为排除,也允许跟踪调用。
  • 使用 Yama 时,Linux 上的线程枚举终于可以正常工作。感谢 Jon Wilson!

Frida 12.6 发布

过去几周,我们在所有平台上密集修复了大量问题,我想是时候再提升一个次版本号,让大家关注这次发布了。

其中有一项修复尤其值得单独说明。Android Java 集成中长期存在一个错误:传递异常时,进程偶尔会崩溃,堆栈跟踪中通常会出现 GetOatQuickMethodHeader()。感谢 Jake Van Dyke 和 Giovanni Rocca 协助追踪这个问题。自从 Frida 支持 ART 以来,这个错误就一直存在,因此这项修复值得庆祝。🎉

我们的 V8 运行时也稳定了许多,子进程门控比以往任何时候都更好用,Android 设备兼容性显著改善,等等。

归根结底,这是 Frida 有史以来最稳定的版本——现在正是确认自己正在运行 Frida 12.6 的时候。

尽情使用吧!

12.6.1 的变更

  • Android Java 集成中的异常传递修复,在以解释器模式运行 VM 时引入了性能瓶颈,例如通过 Java.deoptimizeEverything() 运行时。以 Pixel 3(Android 9)从启动 Dropbox 应用到登录界面为例,之前大约需要 94 秒,现在只需约 6 秒。

12.6.2 的变更

  • 感谢 Giovanni Rocca 贡献的修复,Android Java 集成现在支持更多 arm64 系统。
  • Android Java 集成再次支持同时供多个脚本使用。

12.6.3 的变更

  • 感谢 Eugene Kolo 贡献的修复,Java.choose() 现在可在 Android >= 8.1 上正常工作。
  • Android Java 集成的解除 hook 功能现已恢复。这也意味着卸载脚本时会正确还原 hook。
  • Frida 现在可以与加入“每脚本运行时选择”功能之前的旧版 Frida 通信。

12.6.4 的变更

  • 构建系统已在所有平台上恢复正常。

12.6.5 的变更

  • Linux 线程枚举现在可在 x86-64 上正常工作。
  • Stalker 终于能够处理可重启的 Linux 系统调用。

12.6.6 的变更

  • Android Java 集成已在 32 位 ARM 上完全恢复正常。

12.6.7 的变更

  • 现已支持最新的 Chimera iOS 越狱;已确认可在 1.0.8 上正常工作。
  • Linux 注入器现在可以处理 libc 名称存在歧义的目标进程,这在 Android 上经常出现。

12.6.8 的变更

  • ObjC.Object 现在提供 $moduleName,可用于确定某个类属于哪个模块。感谢 David Weinstein 贡献这项实用功能!

12.6.9 的变更

  • 现已完整支持最新版 unc0ver 越狱。
  • 早期插桩逻辑已得到改进,现可完整支持 iOS 12。感谢 Francesco Tamagni 协助完成这些棘手的改动。
  • iOS 12 上的内存范围枚举现在更加可靠,因为属于线程的内存范围已被正确隐藏。
  • 隐藏的内存范围现在会被合并,使查找更快。
  • 子进程门控现在可以将子进程保持暂停超过 25 秒。此前,子进程会在这个意外设置的超时时间后自动恢复。这也会影响 Android 上的早期插桩,因为它构建在子进程门控之上。
  • 感谢 John Coates 的出色贡献,Swift 绑定现已支持 RPC,并迁移至 Swift 5.0。

12.6.10 的变更

  • 内存范围枚举现在在所有平台上都很可靠。此前存在一个长期错误:移除操作将已有范围拆分时会出现问题。

12.6.11 的变更

  • 感谢 CodeColorist 提供的优秀修复,在 iOS >= 12 上枚举应用时现在会包含图标。
  • 感谢 gebing 的精彩贡献,Gadget 现在能够检测 Android 应用的可执行文件名和包名。
  • 内存范围隐藏功能获得了一项影响 Windows 用户的关键修复。

12.6.12 的变更

  • frida-inject 工具现在支持通过 -P/–parameters 向脚本传递参数。感谢 Eugene Kolo 贡献这项实用功能。
  • 当脚本卸载发生阻塞时,子进程门控不再死锁。感谢 Ioannis Gasparis 协助追踪这个问题。
  • 子进程门控变得更加可靠:Frida 现在会在更高的编号区间分配文件描述符,以避免应用在 fork()+exec() 期间调用 dup2() 时关闭它们。这种情况通常发生在 Android 应用调用 Runtime.exec() 时。感谢 Ioannis Gasparis 协助追踪这个问题。
  • 在 Muhammed Ziad 大量精彩贡献的帮助下,艰难的 Android NDK r20 升级终于落地。
  • 错误处理得到改进,可避免因权限不足导致初始化失败时发生崩溃。感谢 pancake 报告问题。
  • 在分支中搁置已久的 iOS 原生 lockdown 集成终于合并。它尚未完成,被视为不稳定 API,但由于正在进行一项重大重构,必须将其合并。
  • Stalker 现在允许从 transform 回调中调用 unfollow(),不会再像以前那样导致进程崩溃。感谢 Giovanni Rocca 协助修复此问题。
  • Gadget 的 Android 包名检测逻辑得到改进,可以处理此前未考虑到的一种边界情况。感谢 xiaobaiyey 报告问题并提出修复建议。
  • Java.registerClass() API 得到改进,支持指定父类;同时还修复了该 API 以及带泛型数组处理方面的大量问题。衷心感谢 gebing 带来的这些出色改进。

12.6.13 的变更

  • Agent 和 Gadget 中的构造函数与析构函数现在终于能够正确排序,因此可以移除 libc shim 中针对内存分配器的变通方案。由于工具链的 libgcc 发生细微变化,这些脆弱的变通方案在 Android 的 32 位 ARM 进程中以一种全新且离奇的方式失效了。
  • libc shim 现在还会处理 __cxa_atexit() 和 atexit(),其中前者对于避免泄漏至关重要。

12.6.14 的变更

  • 感谢 gebing 贡献的出色改进,Java.registerClass() API 现在支持用户定义的构造函数和字段。
  • 现在会在所有平台上清理临时文件。
  • Windows 上的 frida-server 现在会处理 Ctrl+C,以支持优雅关闭且不留下临时文件。

12.6.15 的变更

  • NativePointerValue(即除了 NativePointer 外,还支持传入带有 handle 属性的对象)现在再次可在所有环境中正常工作。

12.6.16 的变更

  • frida-gadget-ios 元软件包现在不再有依赖项。

12.6.17 的变更

  • 崩溃报告器集成现在兼容 iOS 12.4。
  • Java 集成得到改进,在被替换的方法被调用时会立即释放全局句柄,以免句柄耗尽。感谢 gebing 带来这项优秀改进。
  • 新增 Java.retain(),允许保存 this,供日后在被替换的 Java 方法之外使用。
  • 对旧版 Android 的支持现在应该略有改善。
  • 在 i/macOS 上向目标进程注入库时,如果目标进程终止,Frida 不再崩溃。
  • 感谢 Jon Wilson 的出色贡献,现已支持 MIPS64。
  • 感谢 gebing 的修复,Memory.patchCode() 在 android-arm64 上不再崩溃。
  • 现在可以正确拦截已被拦截的 Thumb 函数。
  • 在 iOS 进程生命周期早期记录日志时,Frida 不再崩溃。
  • 简单的 ModuleApiResolver 查询现在快如闪电。
  • Duktape 运行时不再包含存在问题的 Reflect 内置对象。
  • Interceptor C API 已重构,以改进命名。

12.6.18 的变更

  • Gadget 二进制文件再次会在所有平台上剥离符号。

12.6.19 的变更

  • 所有 API 现在都可以取消。Python 和 Node.js 语言绑定支持传入 Cancellable 对象。其他语言绑定的行为与之前相同,非常欢迎大家贡献改进。

12.6.20 的变更

  • DeviceManager.find_device() 启动时不再崩溃。

12.6.21 的变更

  • Future.wait_async() 在最后一刻被取消时不再崩溃。

12.6.22 的变更

  • 状态管理得到改进,在已释放状态下也允许调用 eternalize() 和 post()。
  • dispose() RPC 导出现在会收到一个说明原因的参数,以区分 unload、exit 和 exec。
  • 如果 exec 转换失败,现在可以再次对脚本调用 dispose()。
  • frida-inject CLI 工具得到改进,会在分离时退出。
  • 当 post_rpc_message() 失败时,RpcClient 不再崩溃。
  • 现在会在 iOS 和 Android 上禁用 Fruity 与 Droidy 后端,以减小这些后端不适用平台上的占用空间。

12.6.23 的变更

  • 请求进行期间丢失 HostSession 时,Frida 不再崩溃。

Frida 12.5 发布

这是一个内容丰富的版本,有太多值得介绍的内容。

V8

本次发布的主角是 V8。不过先介绍一点背景。

Frida 默认使用 Duktape JavaScript 运行时,以脚本方式访问其插桩核心 Gum。 最初我们只使用 V8,但过去 V8 依赖操作系统支持 RWX 页面,即同时可写和可执行的 内存页,因此最终又添加了基于 Duktape 的第二套 JS 运行时。考虑到 V8 的这一系统限制, 以及 Duktape 不支持最新 JS 语法和功能的事实,我决定把 Duktape 设为默认运行时, 使针对一个平台编写的脚本无需修改语法即可在其他平台运行。Duktape 基本上就是最低 共同标准。

如今 V8 已不再依赖操作系统支持 RWX 页面,实际上正转向默认在 RW- 与 R-X 之间 切换。这使它可用于现代 iOS 越狱环境;在未越狱 iOS 上,只要进程被标记为正在调试、 能够运行未签名代码,也可使用。不仅如此,V8 现在甚至能以 JIT-less 模式运行, 这意味着 Frida 可在每个平台上使用 V8,用户也无需为了使用最新 JavaScript 语法和功能 而通过 frida-compile 编译 agent。不过最后一点只适用于简单 agent;对于复杂 agent, 将其拆分为多个源文件仍很有价值。此外,frida-compile 便于使用 TypeScript,强烈 建议所有复杂的 Frida agent 都采用它。

基于这些变化,显然该把 V8 升级到最新版本了。本版本使用 7.6.48,与 V8 的集成也 比以往深入得多。C++ 内存分配和页级分配现在都由 Frida 管理,因此可以向 Process.enumerateRanges() 等 API 隐藏这些内存范围,也避免用 Frida 自身的分配污染 应用堆。这些细节听起来或许并不重大,但对于基于 Frida 实现内存转储工具至关重要。 此外,我们对被观察进程的干扰也更少,因而降低了进程在插桩状态下表现出不同于正常运行 行为的风险。

运行时选择

你可能还记得 session.enable_jit() API。它终于被弃用了,因为现在可在创建脚本时指定 所需运行时。例如使用 Python 绑定:

script = session.create_script(source, runtime='duk')

使用 Node.js 绑定则是:

const script = await session.createScript(source, {
  runtime: 'v8'
});

Stalker

本版本的另一项重大变化是:得益于 John Coates 的出色贡献,Stalker 在 arm64 上不再依赖 RWX 页面。这意味着 Stalker 终于更容易在 iOS 上使用。

对于在 64 位 Windows 上使用 Stalker 跟踪 32 位进程的用户,它终于能处理新版 Windows 中的 WOW64 转换。这项烧脑的改进由 Florian Märkl 贡献。

Module.load()

有时你可能想加载自己的共享库,其中或许包含用 C/C++ 编写的 hook。在大多数平台上, 可使用 NativeFunction 调用 dlopen()(POSIX)或 LoadLibrary()(Windows)。 但新版 Android 的情况大不相同:其 dlopen() 实现会检查调用者并据此作出决定,其中 一项就是判断应用是否试图访问私有系统 API,因为这会让系统日后难以移除或破坏该 API。 因此从 Android 8 开始,遇到这种情况会返回 NULL。Frida 已为自身注入器解决这一难题, 但想加载自有库的用户此前基本只能自行处理。

从 Frida 12.5 开始,全新的 JavaScript API 会为你处理所有平台特有问题:

const hooks = Module.load('/path/to/my-native-hooks.so');
Interceptor.replace(Module.getExportByName('libc.so', 'read'),
    hooks.getExportByName('replacement_read'));

Android

本版本修复了大量 Android 特有问题。例如,对应用自带库调用 Module.getExportByName() 时,不再导致该库以不同基址被二次加载。仅这一项修复就足以 让你把所有设备升级到最新版。

iOS

得益于 Francesco Tamagni 的出色贡献,现在也支持 iOS Chimera 越狱。

其他变更

各平台还有许多其他改进。

按时间顺序如下:

  • Child gating 也可在旧版 Windows 上工作。感谢 Fernando Urbano!
  • UNIX 操作系统上的可执行文件不再导出动态符号,因此体积更小。
  • Frida agent 和 gadget 加载到高地址(即设置了 MSB)时,不再于 32 位 Linux 上崩溃。
  • Linux/Android 的两个 frida-helper-{32,64} 二进制文件只需其中一个;不支持跨架构的 构建则都不需要。这减小了占用并提高性能。
  • 终于支持 Linux/ARM64,并在发布流程中上传二进制文件。
  • Android 上早期插桩 Zygote 失败时,现在会提示 Magisk Hide。

12.5.1 中的变更

  • 可为每个脚本指定运行时,enable_jit() 因而弃用。

12.5.2 中的变更

  • 在 Linux 和 Android 上使用 V8 时,Gadget 不再于加载脚本时崩溃。非常感谢 Leon Jacobs 报告并协助定位。

12.5.3 中的变更

  • Android linker 集成支持更多设备。
  • Android Java 集成不再于部分 arm64 设备上因“Invalid instruction”崩溃。感谢 Jake Van Dyke 报告并协助定位。
  • 添加缺失的 SELinux 规则后,现在支持 LineageOS 15.1。

12.5.4 中的变更

  • hook 不再干扰 V8 页分配器集成。
  • 修补 libc shim 中的漏洞后,Android 稳定性大幅提高。非常感谢 Giovanni Rocca 报告并协助定位!

12.5.5 中的变更

  • Windows 现在能正确检测 Apple USB 设备。感谢 @xiofee!

12.5.6 中的变更

  • Android Java 集成现在可规避 ART 异常传递逻辑中的错误:某条特定代码路径假设当前线程 至少存在一个 Java 栈帧,但 Frida JS 线程等纯原生线程并非如此。最简单的复现方式是 调用 Java.deoptimizeEverything(),随后用不存在的类名调用 Java.use()。感谢 Jake Van Dyke 报告并协助定位。
  • 在无法监听 TCP 的进程中调用 Java.deoptimizeEverything() 时,Android Java 集成 不再导致进程崩溃。
  • Android Java 集成重新支持 JNI checked 模式。
  • 除 8 和 10 外还支持 Node.js 12,并为所有受支持平台提供预构建包。
  • Node.js 绑定的 enableDebugger() 方法不再要求指定监听端口。

12.5.7 中的变更

  • 在无法启动 logcat 生成崩溃报告的系统上,Android teardown 不再崩溃。
  • 改进 Android 上的 SuperSU 集成 teardown 逻辑。
  • Android Java 集成现已正确支持 JNI checked 模式,大幅提高 Android ROM 兼容性。 感谢 @muhzii 报告并协助测试。
  • V8 后端 teardown 不再出现释放后使用,延迟绑定 WeakRef 时也不再崩溃。

12.5.8 中的变更

  • Linux child-gating 现在能处理子进程切换架构,例如 32 位应用通过 fork+exec 运行 64 位可执行文件。非常感谢 @gebing 提供修复。
  • fork+exec 后未跟踪子进程时,child gating 不再死锁。感谢 @gebing 修复。
  • 在 Android 应用自有模块上查找模块导出不再失败。

12.5.9 中的变更

  • libc shim 现在包含 memcpy(),使其可以被安全挂钩。感谢 Giovanni Rocca 调试并 贡献修复。
  • 即使线程暂时释放了 JS 锁(例如调用 NativeFunction 时),Interceptor.flush() 也能正常工作。
  • Android Java 集成不再于 ART 异常传递期间偶发崩溃,例如挂钩 ClassLoader.loadClass() 时。感谢 Jake Van Dyke 和 Giovanni Rocca 协助定位。这个问题自支持 ART 起就一直存在,值得庆祝修复成功。🎉
  • 无法启动 JDWP 传输的进程中,Android Java 集成不再导致崩溃。

Frida 12.2 发布

让我们谈谈 iOS 内核内省。Frida 获得 iOS 内核的基础内省支持已经有一段时间了,过去几个月里我们一直在改进它。今天发布的版本大幅扩充了 Kernel API,以便处理较新的 64 位内核。

内核基址

可以通过读取 Kernel.base 属性获得内核基址。有了基址,例如就能计算任何已经通过内核缓存静态分析得知的符号的滑动虚拟地址。

内存搜索 API 已移植到内核,因此可以像在用户空间使用 Memory.scan()(或 Memory.scanSync())一样使用 Kernel.scan()(或 Kernel.scanSync())。这是一项强大的基础能力,结合最近推出的位掩码功能,可以通过搜索 arm64 模式来创建自己的符号查找代码。

KEXT 和内存区间

现在可以通过 Kernel.enumerateModules()(或 Kernel.enumerateModulesSync())获得所有 KEXT 的名称和偏移量。

Kernel.enumerateModuleRanges()(或 Kernel.enumerateModuleRangesSync())用于枚举某个指定名称的模块中,由 Mach-O 节定义并按保护属性过滤的所有内存区间。结果与在用户空间调用 Module.enumerateRanges() 得到的结果类似,但还会包含节名。

最后说明

所有 Kernel API 都不依赖 NativePointer,因为它的大小取决于用户空间,而用户空间与内核空间的大小不一定相同。所有地址都改用 UInt64 对象表示。

这一切再加上现有的用于读取、写入和分配内核内存的 JavaScript 接口,可以为构建自己的内核分析或漏洞研究工具提供强大起点。

请注意,这些功能应被视为实验性功能,随意操作内核可能严重损坏你的设备,所以请多加小心,祝黑客愉快!

故障排查

问题:Kernel.available 为 false

满足以下两个条件时,Kernel API 可用:

  • 设备已越狱
  • Frida 能够获得内核任务的发送权,无论是通过传统的 task_for_pid (0),还是访问 host special port 4(现代越狱采用的方式)

实现后一个条件的推荐方式是附加到系统会话,即 PID 0,然后在其中加载脚本。

问题:我在 32 位内核上做不了多少事

是的,未来可以改进这方面,但如今 32 位 iOS 在优先级列表中的位置相当靠后。当然,我们非常欢迎你参与贡献并发送 PR。

问题:我尝试做 X,结果内核 panic 了

别担心,这很正常。你可以前往设备上的 /private/var/mobile/Library/Logs/CrashReporter 目录,或导航到“设置 -> 隐私 -> 分析 -> 分析数据”,找到 panic 日志,并弄清楚你(或 Frida)做错了什么。请记住:内核永远是对的!

问题:我使用 Frida Kernel API 对设备造成了无法恢复的损坏

听到这个消息很遗憾。如果损坏发生在硬件层面,而你又能投入足够的时间和金钱,或许可以按照 https://ifixit.com 上的教程自行修复。

Frida 12.1 发布

这次底层发生了巨大变化。我们的所有依赖都已升级到最新最好的版本。让我们看看亮点。

V8 7.0

Frida 之前依赖的 V8 版本是 6.2.2,现已升级到 7.0.242。迁移到如此新的版本意味着 V8 调试器 API 已消失,并被最新 Node.js 也在使用的新 Inspector API 取代。它特别棒的一点是,Google Chrome 的 Inspector 原生支持它。

要开始使用,只需通过调用 session.enable_jit(),然后调用 session.enable_debugger(),告诉 Frida 使用 V8。

或者,使用 CLI 工具时:

$ frida-trace --enable-jit --debug -f /bin/cat -i read

然后在 Google Chrome 中右键单击并选择“检查”,再单击 Inspector 左上角的绿色 Node.js 图标。就这么简单,现在你已在调试 Frida 脚本。这意味着你可以使用带自动补全的实用控制台、暂停/继续、单步执行、断点、性能分析和堆快照。它非常方便的原因在于,服务器侦听在主机上,因此你可以对代表 USB 连接 Android 设备上某个进程的会话调用 enable_debugger(),一切都能以同样的方式工作。

它看起来是这样的:

控制台 性能分析器 堆快照

不过请注意,目前我们的预构建 iOS 二进制文件中并不包含 V8;但由于 V8 现在已能在没有 RWX 页的情况下运行,应该可以让它再次在 iOS 上运行。我们还计划在幕后桥接 Duktape 的二进制调试器协议,让调试在 Duktape 上也能“开箱即用”,尽管功能集可能会略有缩减。

Process.id

知道 agent 所在进程的 PID 通常很有用,尤其是在预加载模式下。因此,现在无需使用 NativeFunction 去调用 getpid() 之类的函数,直接使用全新的 Process.id 属性就简单多了。

还有其他内容吗?

没有其他新功能,但有一些非常不错的错误修复。感谢 mrmacete,我们现在可以附加到 iOS 11.x 上的 com.apple.WebKit.* 进程。此外,感谢 viniciusmarangoni,本版本还为 frida-java 带来了两项好东西:修复一个 Android 8.0 回归问题,并添加正确对 system_server 进行插桩的能力。

祝使用愉快!

Frida 12.0 发布

有些人可能已经注意到,一本关于 Frida 的书正在筹备中。我在 NowSecure 的日常工作中花了大量时间使用 Frida API,因此常常会想起过去那些后来令我后悔的设计决定。多年来我已解决其中大部分,但有些问题处理起来实在痛苦,一直被搁置。到了今天,想到要在这些问题仍然存在的情况下出版一本书,我意识到是时候迎难而上了。

因此,我非常激动地宣布 Frida 12。Frida 的演进终于到达一个阶段:其基础已经足够稳定,可以据此写一本书了。

下面看看具体变化。

CLI 工具

过去一个容易引起困惑的问题是:Python 绑定还附带了一些 CLI 工具。Frida 是用于构建工具的工具包;虽然我们提供几个示例工具,但是否安装它们应由你决定。

此前,任何使用 Python 绑定构建工具的人最终都会依赖 colorama、prompt-toolkit 和 pygments,原因只是我们的 CLI 工具依赖它们。

现在情况改变了。如果执行:

$ pip install frida

现在只会安装 Python 绑定,不包含其他内容,而且该包零依赖。

不过 CLI 工具可能仍对你有用,可用下面的命令安装:

$ pip install frida-tools

绑定中的便利 API

当初看起来很棒的一个想法,是让语言绑定在 Session 对象上提供一些便利 API。设想是:仅需枚举已加载模块和少量内存范围,再读写内存的简单用例,无需自行加载 Agent。因此 Python 和 Node.js 绑定会在幕后代劳。

当时 rpc API 尚不存在,与 Agent 通信比较繁琐,但这仍是一个糟糕的设计决定。JS API 数量众多,若不引入新的复杂层次,就无法全部公开。另一方面,每种语言绑定都必须重复实现这些便利 API,或者我们必须新增可由绑定公开的核心 API。两种方案都很差,会模糊边界并让 Frida 新用户困惑。诚然,它确实简化了内存转储工具等少数简单用例,但对其他人而言只增加了臃肿和困惑。

现在,这些 API 终于从 Python 和 Node.js 绑定中移除。其他绑定从未实现这些便利 API,因此不受影响。

Node.js 绑定

Node.js 绑定编写至今已有数年,Node.js 在此期间发展了很多,现在支持 ES6 类、async / await、箭头函数、Proxy 对象等特性。

仅凭 Proxy 支持,就能把下面这样的 rpc 用法:

const api = await script.getExports();
const result = await api.add(2, 5);

简化为:

const result = await script.exports.add(2, 5);

有些人可能更喜欢用 TypeScript 编写应用;与传统 JavaScript 相比,它能显著提升生产力。除了类型检查,使用 VS Code 等编辑器时还能获得类型感知重构和出色的代码补全。

不过,要充分发挥类型检查和编辑器功能,项目依赖必须具备类型定义。如今这很少成为问题,使用 Frida Node.js 绑定的用户却是例外,因为此前我们没有提供任何类型定义。现在终于解决了:我没有在现有绑定上补充类型定义,而是决定用 TypeScript 重写它们。这也让我们能利用 ES6 类和 async / await 等现代语言特性。

本可以到此为止,但在 TypeScript 中使用 Node.js 绑定时,下面的代码仍会令人困扰:

script.events.listen('message', (message, data) => {
});

编译器并不知道 Script 对象存在哪些事件,也不知道特定事件的回调应采用什么签名。现在终于修复了,API 改为:

script.message.connect((message, data) => {
});

这样,编辑器甚至能告诉你支持哪些事件,并对回调代码进行正确的类型检查。太棒了!

Interceptor

过去一个令人困惑的现象是:从 onEnter 或 onLeave 访问 this.context.pc 得到的是返回地址,而不是设置 Hook 的指令地址。现在终于修复了。此外,在 x86 上,this.context.sp 现在指向返回地址,而不是第一个参数。使用调用探针时,Stalker 也同样如此。

此次重构会影响回溯器实现,因此我也改进了 Windows 上的默认回溯器。

Tether?

你可能疑惑过,为何 frida.get_usb_device() 返回的 Device 其 type 是 ‘tether’。现在它终于如预期改为 ‘usb’,语言绑定也终于与核心 API 一致。

12.0.1 的变更

  • core:修复 32 位 x86 上的参数访问
  • core:更新 Stalker 以采用新的 CpuContext 语义
  • python:向 PyPI 发布正确的 README
  • python:修复 Windows 构建系统

12.0.2 的变更

  • core:升级到 Capstone 的 next 分支
  • core:修复 Windows 上的 DbgHelp 回溯器并升级到最新版 DbgHelp
  • python:修复长描述
  • java:修复对 java.lang.Class.getMethod() 的 Hook——感谢 0x3430D!

12.0.3 的变更

  • core:修复被 Capstone 升级破坏的 iOS 构建系统

12.0.4 的变更

  • core:修复 i/macOS 早期插桩期间的 libc++ 初始化——感谢 mrmacete!
  • core:支持带掩码的内存搜索——感谢 mrmacete!
  • core:修复 InvocationContext.get_return_address()
  • node:修复异步函数返回 RPC 对象时的崩溃

12.0.5 的变更

  • core:修复 Capstone 升级导致的 arm64 崩溃;测试并分支解码逻辑此前无法解码负偏移。感谢 mrmacete 发现并修复!
  • core:修复 MIPS 回归和一个崩溃问题——感谢 r0ck3tAKATrashPanda!

12.0.6 的变更

  • python:改进 spawn(),在 Python 2.x 上支持 Unicode aux 选项
  • java:修复缓存目录缺失时的 Java.registerClass()
  • java:允许配置临时文件命名

12.0.7 的变更

  • core:修复 iOS 11.3.1 至 11.4.1 上的早期插桩——感谢 mrmacete!

12.0.8 的变更

  • core:修复启动带自定义进程名的 Android 应用——感谢 giantpune!
  • java:修复 Android 8.0 上的 ClassLinker 字段偏移检测

尽情体验吧!

Frida 11.0 发布

是时候彻底改造 spawn() API,并修正 spawn gating 和 child gating API 中一些不够完善的地方了。

启动进程(spawn())

假设你正在使用 Frida 的 Python 绑定,目前会这样做:

pid = device.spawn(["/bin/cat", "/etc/passwd"])

或者这样启动一个 iOS 应用:

pid = device.spawn(["com.apple.mobilesafari"])

嗯,这个 API 真正能做的差不多也就这些了……只有一项例外,而 Python 和 Node.js 绑定还没有公开它。稍后我们会讲到。在此之前,先看看 frida-core 中的底层 API,各语言绑定正是将它公开给不同语言:

namespace Frida {
	…
	public class Device : GLib.Object {
		…
		public async uint spawn (string path,
			string[] argv, string[] envp)
			throws Frida.Error;
		public uint spawn_sync (string path,
			string[] argv, string[] envp)
			throws Frida.Error;
	}
	…
}

顺便说一下,这是 Vala 代码,frida-core 正是用这种语言编写的。它是一种类似 C#、可以编译为 C 的语言,而且非常棒。不过说远了。第一个方法 spawn() 是异步的,允许调用线程在调用进行期间处理其他事情;而 spawn_sync() 会阻塞,直到操作完成。

这两个方法会编译为下面三个 C 函数:

void frida_device_spawn (FridaDevice * self,
    const gchar * path,
    gchar ** argv, int argv_length,
    gchar ** envp, int envp_length,
    GAsyncReadyCallback callback, gpointer user_data);
guint frida_device_spawn_finish (FridaDevice * self,
    GAsyncResult * result, GError ** error);
guint frida_device_spawn_sync (FridaDevice * self,
    const gchar * path,
    gchar ** argv, int argv_length,
    gchar ** envp, int envp_length,
    GError ** error);

前两个函数共同构成 spawn():你先调用第一个函数并传入回调;回调被调用后,再调用第二个函数 spawn_finish(),并传入回调收到的 GAsyncResult。返回值是 PID;如果操作失败,则由 error 输出参数说明出了什么问题。如果你好奇,这就是 GIO 的异步模式。

至于第三个函数 spawn_sync(),Frida 的 Python 绑定使用的就是它。我们的 Node.js 绑定实际使用前两个函数,因为这些绑定完全异步。将来,如果能通过集成 Python 3.5 引入的 async/await 支持,也把 Python 绑定迁移为完全异步,那会很不错。

言归正传,回到上面的示例。我提到过,有一项功能尚未公开。仔细查看 frida-core API,你会注意到其中有一个 envp 字符串数组。查看绑定的内部实现便会发现,我们确实没有公开它,实际上做的是:

  envp = g_get_environ ();
  envp_length = g_strv_length (envp);

这意味着,我们只是把 Python 进程碰巧拥有的环境原样传了过去。如果实际的启动操作发生在完全不同的系统上,例如连接的 iOS 或 Android 设备上,这显然很不妥。这个问题之所以没有那么严重,是因为启动 iOS 和 Android 应用时会忽略 envp,只有启动普通程序时才使用它。

旧 API 的另一个问题是,声明 string[] envp 意味着它不可为空;如果声明为 string[]? envp,它才可以为空。因此,我们无法区分“不提供任何环境”(直觉上意味着“使用默认值”)和“使用空环境”这两种意图。

在着手修复 API 的这一点时,我意识到,是时候一并解决它长期存在的其他几个问题了,例如允许:

  • 在默认环境的基础上仅提供少数额外环境变量
  • 设置工作目录
  • 自定义 stdio 重定向
  • 传递特定于平台的选项

此前,我们一直将 stdio 重定向到自己的管道,并通过 Device 上的 output 信号传输所有输出。另外还有 Device.input(),用于写入 stdin。这些 API 保持不变,唯一的区别是我们不再默认执行这种重定向。不过,你们中的大多数人大概并未深受其扰,因为我们此前没有为 iOS 和 Android 应用实现这种重定向。从这个版本开始,我们终于为 iOS 应用实现了它。

现在,你大概已经想知道新 API 长什么样了。来看看:

namespace Frida {
	…
	public class Device : GLib.Object {
		…
		public async uint spawn (string program,
			Frida.SpawnOptions? options = null)
			throws Frida.Error;
		public uint spawn_sync (string program,
			Frida.SpawnOptions? options = null)
			throws Frida.Error;
	}
	…
	public class SpawnOptions : GLib.Object {
		public string[]? argv { get; set; }
		public string[]? envp { get; set; }
		public string[]? env { get; set; }
		public string? cwd { get; set; }
		public Frida.Stdio stdio { get; set; }
		public GLib.VariantDict aux { get; }

		public SpawnOptions ();
	}
	…
}

回到开头的 Python 示例,它们仍然可以原样工作。不过,除了:

device.spawn(["com.apple.mobilesafari"])

现在也可以这样做:

device.spawn("com.apple.mobilesafari")

因为第一个参数是要启动的 program。你仍然可以在这里传入 argv,它将用于设置 argv 选项,也就是说,argv[0] 会被用作 program 参数。还可以这样做:

device.spawn("/bin/busybox", argv=["/bin/cat", "/etc/passwd"])

如果想替换整个环境,而不是使用默认值:

device.spawn("/bin/ls", envp={ "CLICOLOR": "1" })

不过,在大多数情况下,你可能只想增加或覆盖几个环境变量,现在这也可以做到:

device.spawn("/bin/ls", env={ "CLICOLOR": "1" })

你可能还想使用不同的工作目录:

device.spawn("/bin/ls", cwd="/etc")

或者,你或许想重定向 stdio:

device.spawn("/bin/ls", stdio="pipe")

正如之前提到的,stdio 的默认值是 inherit。

现在,我们已经介绍了所有 SpawnOptions,只剩最后一项:aux。这是一个存放平台特定选项的字典。使用 Python 绑定设置这些选项非常简单:任何无法识别的关键字参数最终都会进入这个字典。

例如,启动 Safari 并让它打开指定 URL:

device.spawn("com.apple.mobilesafari", url="https://frida.re")

或者,你可能想在禁用 ASLR 的情况下启动 i/macOS 程序:

device.spawn("/bin/ls", aslr="disable")

另一个例子是使用指定 activity 启动 Android 应用:

spawn("com.android.settings", activity=".SecuritySettings")

以上其实就是我们目前支持的全部 aux 选项。好处在于,我们可以增加新选项,而不必更新绑定。

不过,在继续之前,先快速看看使用 Node.js 绑定时这个新 API 会是什么样子:

const pid = await device.spawn('/bin/sh', {
  argv: ['/bin/sh', '-c', 'ls /'],
  env: {
    'BADGER': 'badger-badger-badger',
    'SNAKE': true,
    'MUSHROOM': 42,
  },
  cwd: '/usr',
  stdio: 'pipe',
  aslr: 'auto'
});

如你所见,第二个参数是选项对象,无法识别的选项会进入 aux 字典。

11.0.0 中的其余变化

简单总结一下其余变化,先从 Device 类开始:

  • 为了符合语法,enumerate_pending_spawns() 现已改名为 enumerate_pending_spawn()。
  • spawned 信号已重命名为 spawn-added,并且现在还新增了 spawn-removed。
  • delivered 信号已重命名为 child-added,并且现在还新增了 child-removed。

最后一项变化是,Child 类的 path、argv 和 envp 属性现在都可以为空。这样就能区分例如“未提供 envp”和“提供了空 envp”。

11.0.1 中的变化

  • core:修复 32 位 ARM 进程中 agent 线程的栈对齐
  • core:修复脆弱的 SELinux 规则补丁逻辑

11.0.2 中的变化

  • core:修复 i/macOS 上 spawn() 逻辑中的 Mach 端口泄漏(长期存在的问题)

11.0.3 中的变化

  • core:修复 arm64 上 tls_base 计算错误导致 iPhone 8 和 X 崩溃的问题

11.0.4 中的变化

  • python:更新元数据并提升依赖版本

11.0.5 中的变化

  • core:修复与 Electra 的 Tweak Injector 的兼容性问题
  • core:修复 iOS 上 enumerate_processes() 中进程名被截断的问题
  • java:Java.registerClass() 现在支持重载
  • packaging:此后每个新版本都会提供 Fedora 和 Ubuntu 软件包

11.0.6 中的变化

  • python:修复依赖项规范,使从 PyPI 安装后 REPL 能够再次工作

11.0.7 中的变化

  • core:更完善地覆盖 Windows 上的 child gating API
  • python:从 PyPI 安装时,Linux 的 2.7 二进制文件不再损坏

11.0.8 中的变化

  • core:修复某些平台上设置系统会话时因竞态条件而导致崩溃的问题
  • python:修复解释器关闭时的死锁

11.0.9 中的变化

  • java:修复早期插桩期间无法调用 Java.registerClass() 的问题

11.0.10 中的变化

  • core:修复枚举具有空 DT_GNU_HASH 的 ELF 模块导入/导出时发生的崩溃

11.0.11 中的变化

  • java:修复类型兼容性检查;该问题通常会导致调用错误的重载,继而使虚拟机 abort()

11.0.12 中的变化

  • core:修复与最新版 macOS Mojave 和 iOS 12 测试版的兼容性问题
  • core:改进系统会话(即 PID 0)中可用的 iOS Kernel API
  • frida-trace:修复跟踪器脚本通过 send() 发送任意数据时发生的崩溃

11.0.13 中的变化

  • core:修复拆卸从未 load() 过的脚本时发生的卡死

结语(EOF)

差不多就是这些了。如果你还没有读过上周发布的 Frida 10.8 版本介绍,请务必前往这里阅读。

用得开心!

Frida 10.8 发布

准备迎接一次重大升级。这次我们在一个版本中解决了三个存在时间最久的限制。

限制一:fork()

简单回顾一下:这个传统 UNIX API 会克隆整个进程,向父进程返回子进程 ID,并向子进程 返回零。子进程获得父进程地址空间的独立副本;由于采用写时复制,开销通常很小。

涉及多线程后,处理起来就很棘手。子进程中只有调用 fork() 的线程会存活,因此如果其他 线程恰好持有锁,这些锁在子进程中仍处于持有状态,却再也没有线程会释放它们。

这意味着,同时使用 fork 和多线程的应用必须经过非常谨慎的设计。虽然大多数会 fork 的 应用是单线程的,但 Frida 注入 agent 后实际上会把它们变成多线程。文件描述符又是共享的, 同样需要小心管理。

我非常高兴地宣布,我们终于能检测到 fork() 即将发生,临时停止自身线程、暂停通信 通道,并在之后重新启动。这样就能在让子进程继续运行前,按需对它应用插桩。

限制二:execve()、posix_spawn()、CreateProcess() 等

通俗地说,就是程序启动其他程序:要么像 execve() 那样完全替换自身,要么像不带 POSIX_SPAWN_SETEXEC 的 posix_spawn() 那样启动子进程。

与 fork() 后的情况一样,现在可以在子进程执行第一条指令前应用插桩,并控制它何时开始运行。

限制三:处理进程突然终止

过去一个令人困惑的问题是:把数据交给 Frida 的 send() API 后,如果进程即将终止, 这些数据可能实际上无法到达另一端。

此前推荐的解决方案一直是挂钩 exit()、abort() 等函数,通过 send() 加 recv().wait() 的往返过程刷新仍在传输的数据。现在看来这并不理想,因为很难在多个 平台上都正确实现。如今我们有了更好的方案。

下面介绍新的 API 和功能。

子进程门控

这是解决前两个限制的方法。提供 create_script() 的 Session 对象现在也提供 enable_child_gating() 和 disable_child_gating()。Frida 默认行为仍与以前相同; 必须调用 enable_child_gating() 才会启用新行为。

从那以后,所有子进程都会处于挂起状态,你需要使用其 PID 调用 resume()。Device 对象还新增名为 delivered 的信号,应为其连接回调,以便在出现新子进程时收到通知。 此时应先按需应用插桩,再调用 resume()。Device 还新增 enumerate_pending_children() 方法,可获取全部待处理子进程。进程会一直保持挂起并 留在列表中,直到被你恢复或最终被终止。

理论就是这样。下面通过 Frida 的 Python 绑定查看一个实际示例:

import frida
from frida.application import Reactor
import threading

class Application(object):
    def __init__(self):
        self._stop_requested = threading.Event()
        self._reactor = Reactor(run_until_return=lambda _:
            self._stop_requested.wait())

        self._device = frida.get_local_device()
        self._sessions = set()

        self._device.on("delivered", lambda child:
            self._reactor.schedule(
                lambda: self._on_delivered(child)))

    def run(self):
        self._reactor.schedule(lambda: self._start())
        self._reactor.run()

    def _start(self):
        argv = ["/bin/sh", "-c", "cat /etc/hosts"]
        print("✔ spawn(argv={})".format(argv))
        pid = self._device.spawn(argv)
        self._instrument(pid)

    def _stop_if_idle(self):
        if len(self._sessions) == 0:
            self._stop_requested.set()

    def _instrument(self, pid):
        print("✔ attach(pid={})".format(pid))
        session = self._device.attach(pid)
        session.on("detached", lambda reason:
            self._reactor.schedule(lambda:
                self._on_detached(pid, session, reason)))
        print("✔ enable_child_gating()")
        session.enable_child_gating()
        print("✔ create_script()")
        script = session.create_script("""
Interceptor.attach(Module.getExportByName(null, 'open'), {
  onEnter(args) {
    send({
      type: 'open',
      path: Memory.readUtf8String(args[0])
    });
  }
});
""")
        script.on("message", lambda message, data:
            self._reactor.schedule(
                lambda: self._on_message(pid, message)))
        print("✔ load()")
        script.load()
        print("✔ resume(pid={})".format(pid))
        self._device.resume(pid)
        self._sessions.add(session)

    def _on_delivered(self, child):
        print("⚡ delivered: {}".format(child))
        self._instrument(child.pid)

    def _on_detached(self, pid, session, reason):
        print("⚡ detached: pid={}, reason='{}'"
            .format(pid, reason))
        self._sessions.remove(session)
        self._reactor.schedule(self._stop_if_idle, delay=0.5)

    def _on_message(self, pid, message):
        print("⚡ message: pid={}, payload={}"
            .format(pid, message["payload"]))


app = Application()
app.run()

运行效果如下:

$ python3 example.py
✔ spawn(argv=['/bin/sh', '-c', 'cat /etc/hosts'])
✔ attach(pid=42401)
✔ enable_child_gating()
✔ create_script()
✔ load()
✔ resume(pid=42401)
⚡ message: pid=42401,
↪payload={'type': 'open', 'path': '/dev/tty'}
⚡ detached: pid=42401, reason='process-replaced'
⚡ delivered: Child(pid=42401, parent_pid=42401,
↪path="/bin/cat", argv=['cat', '/etc/hosts'],
↪envp=['SHELL=/bin/bash', 'TERM=xterm-256color', …],
↪origin=exec)
✔ attach(pid=42401)
✔ enable_child_gating()
✔ create_script()
✔ load()
✔ resume(pid=42401)
⚡ message: pid=42401,
↪payload={'type': 'open', 'path': '/etc/hosts'}
⚡ detached: pid=42401, reason='process-terminated'
$

退出前刷新

对于第三个限制,即处理进程突然终止,Frida 现在会拦截最常见的进程终止 API,并代为 刷新所有待处理数据。

不过,有些高级 agent 会缓冲数据并仅定期执行 send() 来优化吞吐量;现在它们可以在 进程终止或脚本卸载时运行自定义代码。只需定义一个名为 dispose 的 RPC 导出,例如:

rpc.exports = {
  dispose() {
    send(bufferedData);
  }
};

结语

基于 Frida 全新的 fork() 处理,我们还彻底重写了 Android 应用启动实现。 frida-loader-{32,64}.so 辅助 agent 已被移除,幕后的 Zygote 插桩现在利用全新的 子进程门控完成所有繁重工作。这意味着你也可以按自己的需要对 Zygote 插桩。只需记得 调用 enable_child_gating(),并对不关心的子进程调用 resume()。

本次发布大致就是这些。尽情享用吧!

Frida 10.7 发布

iOS 用户可以欢呼了:Frida 现在兼容 iOS 11 上最新的 Electra 越狱!本文撰写时对应的版本是 1.0.4;既然 Electra 似乎已经稳定下来,可以有把握地认为我们也会兼容未来更新。只需确保你运行的版本不低于 1.0.4。

其他方面,过去几个版本中我们的 Android 支持得到了显著改善,所以只要你的版本稍有落后:立即获取最新的 10.7.x 吧。

尽情使用吧!

Frida 10.6 发布

是时候对 Frida 的 Gadget 进行一些大更新了。

在处理受限 iOS 和 Android 设备时,这个组件非常有用;现在它也能覆盖许多其他场景。

它的环境变量现已取消,改用可选的配置文件。由于一些应用可能会查找名称中含有“Frida”的 已加载库,作为其“反调试”防御的一部分,现在你可以随意重命名 Gadget 的二进制文件。 与此同时,它现在还支持三种不同的交互类型。

它可以像以前一样监听 TCP 端口,也可以从文件系统加载脚本并完全自主运行。 后一部分过去受到很多限制,现在却非常灵活:你甚至可以让它从一个目录加载脚本, 且每个脚本都可以带有过滤器。这对全系统篡改非常实用,并且应该能支持更多有趣的用例。

言归正传,我强烈建议大家查看这里的全新文档。

尽情享用!

Frida 10.5 发布

在 NowSecure,我们挑灯夜战、喝掉了数不清的咖啡,而这一次确实有重磅消息要告诉大家。

延续上个版本那一系列底层好东西的精神,这次我们要沿技术栈向上一层。我们将介绍一种使用新版 CodeWriter API 的全新方式,让你能够把自己的指令织入所选任意线程执行的机器码。也就是说,可以按线程进行惰性动态重编译,并精确控制编译过程。

不过先介绍一点背景。大多数 Frida 用户可能都在使用 Interceptor API 执行内联 hook,或者通过 ObjC 和 Java API 进行方法调配或替换。通常的思路是修改某个预计会被调用、且值得关注的 API,再把执行流引向自己的代码,从而观察、扩展或完全替换应用行为。

这类方法有一个缺点:代码或数据会被修改,而这些变化很容易被检测到。不过这并无大碍,因为在进程内插桩时,想对宿主进程自己的代码保持隐形,永远都会是一场猫鼠游戏。

然而,在尝试回答“对于给定输入,这个私有 API 背后究竟还会调用哪些 API?”时,这些技术的能力相当有限。又或者,在逆向和模糊测试中,你可能想知道两个已知输入传给某个函数后,执行流会从哪里开始分歧。另一个例子是测量代码覆盖率。你可以利用 Interceptor 对指令级探针的支持:先用静态分析工具找出所有基本块,再用 Frida 在各处放置一次性探针。

这就轮到 Stalker 登场了。它并不是新 API,但过去能做的事情相当有限。可以把它看作按线程工作的代码跟踪器:线程原有的机器码会被动态重编译到新的内存位置,从而在原始指令之间织入插桩逻辑。

这种重编译以惰性方式进行,每次处理一个基本块。考虑到自修改代码非常常见,它会谨慎缓存已编译的代码块,以应对原始代码随后发生变化的情况。

Stalker 还会竭尽所能地重新编译代码,确保副作用完全一致。例如,如果原始指令是 CALL,它会确保压入栈中的是原始下一条指令的地址,而不是重编译后下一条指令的地址。

总之,Stalker 在这个宠物项目里一直像是另一个宠物项目。它非常有趣,但这些年来 Frida 的其他部分占据了我的大部分精力。不过也有一些很棒的例外。许多年前,我和 @karltk 进行过几次有趣的结对编程,当时我们坐下来,决定让 Stalker 在敌对代码上也能可靠工作。再后来,我制作了 CryptoShark,希望让大家对它的潜力感到兴奋。过了一段时间,Stalker 突然收到 Eloi Vanderbeken 贡献的一项关键错误修复。今年年初,Antonio Ken Iannillo 加入并将它移植到了 arm64。就在最近,Erik Smit 又出现了,修复了一个会为带 REP 前缀的 JCC 指令生成无效代码的严重错误。太棒了!

到目前为止,Stalker 的 API 一直非常有限。你可以让它跟踪某个线程,包括当前所在的线程;与内联 hook(即 Interceptor)结合时,这一点很有用。此前只能做两件事:

  1. 告诉它你关心哪些事件,例如 call: true,这样每条 CALL 指令都会产生一个事件。这意味着 Stalker 会在每条此类指令之前加入一些日志代码,记录 CALL 发生的位置、目标以及栈深度。其他事件类型与此非常相似。
  2. 为特定目标添加自己的调用探针,在 CALL 指向特定目标时同步回调 JavaScript。

我非常兴奋地宣布,我们刚刚为这个 API 引入了第三种能力,而它将彻底改变玩法。现在你可以自定义重编译过程,而且非常简单:

const appModule = Process.enumerateModulesSync()[0];
const appStart = appModule.base;
const appEnd = appStart.add(appModule.size);

Process.enumerateThreadsSync().forEach(thread => {
  console.log('Stalking ' + thread.id);

  Stalker.follow(thread.id, {
    transform(iterator) {
      const instruction = iterator.next();

      const startAddress = instruction.address;
      const isAppCode = startAddress.compare(appStart) >= 0 &&
          startAddress.compare(appEnd) === -1;

      do {
        if (isAppCode && instruction.mnemonic === 'ret') {
          iterator.putCmpRegI32('eax', 60);
          iterator.putJccShortLabel('jb', 'nope', 'no-hint');

          iterator.putCmpRegI32('eax', 90);
          iterator.putJccShortLabel('ja', 'nope', 'no-hint');

          iterator.putCallout(onMatch);

          iterator.putLabel('nope');
        }

        iterator.keep();
      } while ((instruction = iterator.next()) !== null);
    }
  });
});

function onMatch (context) {
  console.log('Match! pc=' + context.pc +
      ' rax=' + context.rax.toInt32());
}

每当一个新的基本块即将被编译时,transform 回调都会同步执行。它会提供一个迭代器,你可以用它逐条指令推动重编译过程。Instruction 返回值会告诉你即将重编译的指令所需的全部信息。随后调用 keep(),让 Stalker 按照通常方式重编译该指令。如果想跳过某些指令,比如已经用自己的代码替换了它们,就可以省略此调用。迭代器还允许插入自己的指令,因为它公开了当前架构的完整 CodeWriter API,例如 X86Writer。

上面的示例先确定应用自身代码在内存中的位置,再在属于应用的任意代码中每条 RET 指令之前插入几条额外指令。这段代码会检查 eax 是否包含 60 到 90 之间的值;如果是,就回调 JavaScript,由它实现任意复杂的逻辑。这个回调可以随意读取和修改寄存器。这种方法的优势在于,可以把代码插入热点代码路径,并有选择地调用 JavaScript,从而很容易用机器码执行非常快速的检查,再把更复杂的任务交给高级语言。你也可以调用 Memory.alloc(),让生成的代码直接写入分配的内存,完全无需进入 JavaScript。

这就是 10.5 的重大新功能。特别感谢 @asabil 协助塑造这个新 API。

最后,另一项重大变化是 Instruction API 现在公开了底层 Capstone 指令的更多详细信息。Stalker 在 x86 和 arm64 上的内存占用也大幅降低,并且更加可靠。最后,Process.setExceptionHandler() 现在已成为有正式文档的 API,我们的 SQLite API 也是如此。

尽情使用吧!

Frida 10.4 发布

Frida 提供了许多构件,可以轻松跨多种操作系统和架构进行可移植插桩。但在不可移植的 场景中,一直有所欠缺。虽然我们提供了 Memory.alloc(Process.pageSize) 和 Memory.patchCode() 等原语,可以分配和修改内存中的代码,却没有任何东西帮助你真正 生成代码,或将代码从一个内存位置复制到另一个位置。

Frida 自身需要生成和转换大量机器码,例如实现 Interceptor 和 Stalker,所以我们 早已有 C API 来处理六种不同的指令集也不足为奇。最初这些 API 太过基础,我认为向 JavaScript 公开它们没有太大价值;但经过多年有趣的内部使用场景,它们已经演进到可以 很好覆盖关键功能的程度。

因此,在 10.4 中,我们终于向 JavaScript 公开所有这些 API。值得一提的是,新绑定会 自动生成,所以未来添加内容会非常轻松。

来看一个 x86 示例:

const getLivesLeft = Module.getExportByName('game-engine.so',
    'get_lives_left');
const maxPatchSize = 64; // Do not write out of bounds, may be
                         // a temporary buffer!
Memory.patchCode(getLivesLeft, maxPatchSize, code => {
  const cw = new X86Writer(code, { pc: getLivesLeft });
  cw.putMovRegU32('eax', 9999);
  cw.putRet();
  cw.flush();
});

这意味着,我们将目标函数的开头直接替换为:

mov eax, 9999
ret

也就是说,假设返回类型是 int,我们刚刚将函数体替换为 return 9999;。

顺带一提,也可以使用 Memory.protect() 更改内存页保护属性,然后在各处写入代码;不过 Memory.patchCode() 非常方便,因为它还会:

  • 确保刷新 CPU 缓存;
  • 处理 iOS 上代码签名的边缘情况。

以上是一个简单示例。再来尝试一个更疯狂的:

const multiply = new NativeCallback(function (a, b) {
  return a * b;
}, 'int', ['int', 'int']);

const impl = Memory.alloc(Process.pageSize);

Memory.patchCode(impl, 64, code => {
  const cw = new X86Writer(code, { pc: impl });

  cw.putMovRegU32('eax', 42);

  const stackAlignOffset = Process.pointerSize;
  cw.putSubRegImm('xsp', stackAlignOffset);

  cw.putCallAddressWithArguments(multiply, ['eax', 7]);

  cw.putAddRegImm('xsp', stackAlignOffset);

  cw.putJmpShortLabel('done');

  cw.putMovRegU32('eax', 43);

  cw.putLabel('done');
  cw.putRet();

  cw.flush();
});

const f = new NativeFunction(impl, 'int', []);
console.log(f());

虽然只是将 42 乘以 7 就绕了不少弯路,但这个例子旨在说明:调用函数(甚至回调 JavaScript)以及跳转到标签,其实都非常容易。

最后,看看如何将指令从一个内存位置复制到另一个位置。正确完成此操作通常比直接调用 memcpy() 复杂得多,因为有些指令依赖位置,需要根据新的内存位置进行调整。看看如何使用 Frida 的新重定位器 API 解决这个问题:

const impl = Memory.alloc(Process.pageSize);

Memory.patchCode(impl, Process.pageSize, code => {
  const cw = new X86Writer(code, { pc: impl });

  const libcPuts = Module.getExportByName(null, 'puts');
  const rl = new X86Relocator(libcPuts, cw);

  while (rl.readOne() !== 0) {
    console.log('Relocating: ' + rl.input.toString());
    rl.writeOne();
  }

  cw.flush();
});

const puts = new NativeFunction(impl, 'int', ['pointer']);
puts(Memory.allocUtf8String('Hello!'));

只用几行代码,我们就制作了自己的 puts() 副本。很棒!

请注意,你还可以插入自己的指令,并使用 skipOne() 有选择地跳过指令,从而执行自定义 插桩。(Stalker 正是这样工作的。)

以上就是核心内容。全新的 API 参考文档位于:

还要注意,Process.arch 可以方便地确定应使用哪个 writer/relocator。说到这里,你可能会 疑惑为什么 32 位和 64 位 x86 只有一个实现。原因是这些指令集非常接近,采用统一实现更 合理。这也让编写某种程度上可移植的代码更加容易,因为提供了一些元寄存器名称。例如, xax 会根据所在进程的类型解析为 eax 或 rax。

尽情使用吧!

Frida 10.0 发布

这次我们再上一层楼,为你带来稳定性改进和最先进的 JavaScript 支持。

先说稳定性改进。我们修复了一个影响所有 Linux 用户的堆损坏问题。这个问题尤其难以追查, 但 rr 挽救了局面。另一个问题是 Duktape 运行时在卸载时崩溃,影响所有操作系统。

依赖项也已升级,因此从 Frida 10.0.0 起,你可以使用仅在几天前发布的 V8 6.0.124。 我们还将 Duktape 升级到最新的 2.1.x。Duktape 升级导致字节码语义略有变化, 这意味着我们必须小幅破坏 API。现在不再在加载脚本时指定名称,而是在将其编译为字节码时指定, 因为这项元数据现已包含在字节码中。这合理得多,因此是一项受欢迎的变化。

除 V8 和 Duktape 之外,我们还使用了最新的 GLib、Vala 编译器等。这些升级也包括 JSON-GLib,它最近放弃 autotools,转而使用 Meson。这是个极好的消息, 因为我们也计划未来迁移到 Meson,所以现在已为实现这一点打好了必要基础。

大致就是这些。此次升级应该不需要对现有代码进行任何修改——除非你恰好是少数使用字节码 API 的用户之一。

尽情享用!

Frida 9.0 发布

这次有一些重大变化。现在,我们在所有平台上默认使用基于 Duktape 的 JavaScript 运行时,iOS 应用启动不再借助 Cydia Substrate,同时还带来了一些大幅性能提升。此外,也修复了一些错误。

先来谈谈 Duktape。Frida 的第一个 JS 运行时基于 V8,我很庆幸当初作出了这个选择。不过,很明显,在一些使用场景中它并不合适。

有些系统(例如 iOS)不允许使用 RWX 内存1,而 V8 没有它就无法运行。另一个例子是资源受限的嵌入式系统,它们根本没有足够的内存。此外,正如用户不时反馈的那样,有些进程会将其线程配置为使用很小的栈。然而,V8 对栈的需求相当大,因此,如果你钩住了由这些线程中的任意一个调用的函数,它未必能够进入 V8,于是你的钩子看起来就像被忽略了2。

另一方面,在原生代码 ⇔ JS 的转换方面,V8 的开销远高于 Duktape。因此,如果你的 Frida agent 主要用于 API 钩子,而且钩子都很小,那么使用 Duktape 实际上可能更合适。Duktape 的垃圾回收也更加可预测,这对钩住时间敏感的代码很有帮助。

不过,如果你的 agent 大量使用 JavaScript,V8 会快得多。它还原生支持 ES6,尽管这不算特别重要,因为复杂一些的 agent 应该使用 frida-compile,它会将你的代码编译为 ES5。

所以 V8 运行时不会消失,它仍将是一等公民。唯一的变化是我们会默认选择 Duktape,从而保证你在所有平台上获得相同的运行时,并且它有很大概率能够正常工作。

不过,如果你的使用场景重度依赖 JS,只需在创建第一个脚本之前调用 Session#enable_jit(),便会使用 V8。对于我们的 CLI 工具,可以传入 –enable-jit 来达到同样的效果。

Duktape 就说到这里。那么应用启动和 Substrate 又是怎么回事呢?此前,我们在 iOS 上启动应用一直借助 Substrate。这是一种务实的解决方案,可以避免 Frida 与 Substrate 同时在 launchd 和 xpcproxy 中钩住 posix_spawn(),继而相互干扰的互操作场景。

不过,修复这个问题一直在我的长期 TODO 清单上,因为它给其他部分增加了很多复杂性。例如,我们需要一个带外回调机制,让 Substrate 插件能够在加载时回调 Frida;还需要管理临时文件,等等。除此之外,这也意味着我们依赖一个闭源的第三方组件,尽管它只是启动 iOS 应用时才需要的软依赖。但无论如何,它是 Frida 中唯一间接要求永久修改运行中系统的部分,而我们确实希望避免这种情况。

下面看看新的应用启动方式。假设你的主机通过 USB 连接了一台已越狱的 iOS 设备,并在主机上运行:

$ frida-trace -U -f com.atebits.Tweetie2 -i open

这条命令会启动 Twitter 的 iOS 应用,并跟踪名为 open 的函数。顺便一提,如果你对其中的细节感兴趣,frida-trace 是用 Python 编写的,只有不到 900 行代码,因此它或许是学习如何在 Frida 之上构建自己的工具的一种好方法。又或者,你愿意改进 frida-trace?那就更好了!

它所做的第一件事是取得第一台 USB 设备,并在其上启动 Twitter 应用。归根结底就是:

import frida

device = frida.get_usb_device()
pid = device.spawn(["com.atebits.Tweetie2"])

此时,幕后会发生以下事情:

  1. 我们将 launchd.js agent 注入 launchd(如果此前尚未完成)。
  2. 调用该 agent 通过 RPC 导出的 prepareForLaunch(),向它传入即将启动的应用标识符。
  3. 调用 SBSLaunchApplicationWithIdentifierAndLaunchOptions(),让 SpringBoard 启动应用。
  4. 随后,我们的 launchd.js agent 会拦截 launchd 的 __posix_spawn() 并添加 POSIX_SPAWN_START_SUSPENDED,然后回传信号告知标识符和 PID。这里的进程是 /usr/libexec/xpcproxy 辅助程序,它将执行一次 exec() 风格的转换,成为目标应用。
  5. 接着,我们把 xpcproxy.js agent 注入该进程,使其能够钩住 __posix_spawn(),并像 launchd agent 那样添加 POSIX_SPAWN_START_SUSPENDED。不过,这一次还会带有 POSIX_SPAWN_SETEXEC,这意味着它会用即将启动的应用替换自身。
  6. 我们 resume() xpcproxy 进程,并等待 exec 发生以及进程进入挂起状态。

到这里,我们让 device.spawn() 返回刚启动应用的 PID。应用进程已经创建,其主线程挂起在 dyld 的入口点。随后,frida-trace 会希望附加到该进程,以便加载用于钩住 open 的 agent。于是它会执行类似下面的操作:

session = device.attach(pid)
script = session.create_script("""
Interceptor.attach(Module.getExportByName(null, 'open'), {
  onEnter() {
    console.log('open()');
  }
});
""")
script.load()

应用插桩完成后,它会要求 Frida 恢复该进程,让主线程可以调用 main(),开始愉快地运行:

device.resume(pid)

请注意,这里略过了一些细节,因为考虑到进程此时尚未初始化,attach() 操作实际上要复杂一些;你可以在这里了解更多信息。

最后,我们来谈谈占用空间和性能。首先,看看 Frida 安装在 iOS 设备上并处于完全可运行状态时需要多少磁盘空间:

这是 64 位版本,经过 xz 压缩后只有 1.87 MB。32 位版本显然更小。这里运用了不少优化:

  • 以前,我们会将 frida-helper 二进制文件写入临时文件后再启动。如今,frida-helper 程序的核心已静态链接到 frida-server 中,其 entitlement 也一并得到增强。只有当 Frida 作为插件运行在未知进程中,也就是我们无法对 entitlement 和代码签名作出任何保证时,才需要这个二进制文件。而在 frida-server 场景中,它能够保证满足所有这些约束。
  • 我们注入待插桩进程的库 frida-agent.dylib 也不再写入临时文件。我们使用自己的进程外动态链接器,从 frida-server 的内存中映射它,并直接放入目标进程的地址空间。这些映射采用写时复制,因此其内存效率与旧的 dlopen() 方案相同。
  • iOS 二进制文件中禁用了 V8,因为它实际上只适用于内核已打补丁、允许 RWX 页面的旧版越狱环境。(如果 V8 对你的使用场景很重要,可以这样构建:make server-ios FRIDA_DIET=no)
  • iOS 软件包已拆分成两个:“Frida”面向 64 位设备,“Frida for 32-bit devices”面向旧设备。
  • 去掉启动 iOS 应用时对 Substrate 的依赖,也让我们得以移除 FridaLoader.dylib。不过,这只是一个很小的改进。

好了,磁盘占用就是这样。内存用量如何呢?

不错。性能呢?来看看:

请注意,这些测量结果包含了通过 USB 在 macOS 主机与 iOS 设备之间通信所花费的时间。

用得开心!

1 除非该进程拥有相应 entitlement,不过即便如此也仅限一个内存区域。↩

2: 从技术上说,可以为每个线程设置一个辅助栈,并在调用 V8 前切换过去,从而绕开这个问题。过去我们其实已经实现了一部分。长远来看,或许应该重新推进这项工作。↩

Frida 8.1 发布

又到了发布新版本的时候。这次为构建 Frida 工具的开发者带来了一些重要的新功能,另外还有几项好东西。先从第一部分开始。

毫无疑问,Frida 的 JavaScript API 层级较低,其目的只是提供不局限于某一特定用例的底层构建块。例如,如果你的用例是在 iOS 上截屏,这并不是人们会期待 Frida 本身直接提供的功能。

你可能会问,具有共同功能的不同工具该如何共享 agent 代码。幸运的是,答案不是“复制粘贴”。我们正在形成一个不断壮大的 Frida 专用库生态系统,其中包括 frida-screenshot、frida-uikit、frida-trace 等。

你们有些人可能对为 Java、.NET、Python、Ruby 或 Perl 编写的后端软件插桩所需的 API 感兴趣;也可能想跨不同操作系统和库跟踪密码学 API,或实现其他很酷的想法。我强烈建议把模块发布到 npm,也可以将其命名为 frida-$name,方便他人发现。

现在你可能会问:“但 Frida 不支持 require(),我一开始该如何把 agent 代码拆成多个文件?”问得好!这正是实用的小型命令行工具 frida-compile 登场的地方。

向它提供一个 .js 文件,它会把该文件依赖的其他文件打包为一个文件。与使用 cat 自制的拼接方案不同,最终结果还会嵌入 source map,因此堆栈跟踪中的文件名和行号具有实际意义。各模块也被隔离在独立闭包中,变量不会相互冲突。你还可以使用最新的 JavaScript 语法,例如箭头函数、解构和生成器函数,因为它会将代码编译为 ES5 语法。这意味着代码也能在基于 Duktape 的运行时上执行;在受限 iOS 设备上使用 Frida,或在运行 iOS >= 9 的越狱设备上使用 Frida 时,你必须使用该运行时。

为了缩短开发反馈周期,frida-compile 还通过 -w 提供监视模式,使你在开发 agent 时立即获得增量构建。

理论说得够多了。下面看看如何使用 npm 上现成的 Web 应用框架,并把它注入任意进程。

首先确认已经安装最新版 Node.js。然后创建一个空目录,将以下内容粘贴到名为 “package.json” 的文件中:

{
  "name": "hello-frida",
  "version": "1.0.0",
  "scripts": {
    "prepublish": "npm run build",
    "build": "frida-compile agent -o _agent.js",
    "watch": "frida-compile agent -o _agent.js -w"
  },
  "devDependencies": {
    "express": "^4.14.0",
    "frida-compile": "^2.0.6"
  }
}

然后把以下代码粘贴到 agent.js:

const express = require('express');

const app = express();

app
  .get('/ranges', (req, res) => {
    res.json(Process.enumerateRangesSync({
      protection: '---',
      coalesce: true
    }));
  })
  .get('/modules', (req, res) => {
    res.json(Process.enumerateModulesSync());
  })
  .get('/modules/:name', (req, res) => {
    try {
      res.json(Process.getModuleByName(req.params.name));
    } catch (e) {
      res.status(404).send(e.message);
    }
  })
  .get('/modules/:name/exports', (req, res) => {
    res.json(Module.enumerateExportsSync(req.params.name));
  })
  .get('/modules/:name/imports', (req, res) => {
    res.json(Module.enumerateImportsSync(req.params.name));
  })
  .get('/objc/classes', (req, res) => {
    if (ObjC.available) {
      res.json(Object.keys(ObjC.classes));
    } else {
      res.status(404).send('Objective-C runtime not available in this process');
    }
  })
  .get('/threads', (req, res) => {
    res.json(Process.enumerateThreadsSync());
  });

app.listen(1337);

一步安装 frida-compile 并构建 agent:

$ npm install

然后把生成的 _agent.js 加载到正在运行的进程:

$ frida Spotify -l _agent.js

现在可以向它发送 HTTP 请求:

$ curl http://127.0.0.1:1337/ranges
$ curl http://127.0.0.1:1337/modules
$ curl http://127.0.0.1:1337/modules/libSystem.B.dylib
$ curl http://127.0.0.1:1337/modules/libSystem.B.dylib/exports
$ curl http://127.0.0.1:1337/modules/libSystem.B.dylib/imports
$ curl http://127.0.0.1:1337/objc/classes
$ curl http://127.0.0.1:1337/threads

太棒了。我们用不到 50 行代码就构建了一个包含 7 个不同端点的进程检查 REST API。更酷的是,我们使用了一个为 Node.js 编写的现成 Web 应用框架。实际上,任何依赖 Node.js 内置 net 和 http 模块的现有模块都可以使用,例如 FTP 服务器、IRC 客户端或 NSQ 客户端。

在本版本之前,你可以使用前面提到的 Frida 专用模块,也可以使用 npm 上其他数千个模块,因为它们大多不执行 I/O。现在,本版本还允许使用所有基于 net 和 http 的模块,为 Frida 开启了更多很酷的用例。

如果你好奇它是如何实现的:我向 Frida 添加了 Socket.listen() 和 Socket.connect()。它们是对 GIO 的 SocketListener 和 SocketClient 的轻量封装;这些组件本来就是 Frida 技术栈的一部分,也已供 Frida 自身使用。因此体积保持不变,没有新增依赖。由于 frida-compile 底层使用 browserify,我们只需为 net 和 http 接入自己的内置模块。我直接移植了 Node.js 自身原有的 net 和 http 模块。

本版本还带来了一些其他改进。NativeFunction 长期以来有一个限制:调用要求读取 errno(UNIX)或调用 GetLastError()(Windows)的系统 API 时很难处理。问题在于,从调用 NativeFunction 到尝试读取错误状态之间,Frida 自身的代码可能会破坏当前线程的错误状态。

于是 SystemFunction 登场了。它与 NativeFunction 完全相同,区别在于调用会返回一个对象,其中封装返回值以及紧随其后的错误状态。示例如下:

const open = new SystemFunction(
    Module.getExportByName(null, 'open'),
    'int',
    ['pointer', 'int']);
const O_RDONLY = 0;

const path = Memory.allocUtf8String('/inexistent');
const result = open(path, O_RDONLY);
console.log(JSON.stringify(result, null, 2));
/*
 * Which on Darwin typically results in the following output:
 *
 * {
 *   "value": -1,
 *   "errno": 2
 * }
 *
 * Where 2 is ENOENT.
 */

本版本还允许从传给 Interceptor.replace() 的 NativeCallback 中读取和修改系统错误值,这在替换系统 API 时很有用。请注意,使用 Interceptor.attach() 原本就能这样做,但如果不希望调用原始函数,它就不适用。

另一项值得一提的重要变化是 V8 运行时经过了大幅重构。代码现在更容易理解,添加新功能所需的工作也少得多。不仅如此,参数解析现在还由单一代码路径处理。因此所有 API 对错误或缺失参数都更稳健:忘记参数时会得到 JavaScript 异常,而不是因为某些 API 检查较少而直接让目标进程崩溃。

以上就是亮点。完整变更汇总如下:

8.1.0:

  • core:添加 Socket.listen() 和 Socket.connect()
  • core:添加 setImmediate() 和 clearImmediate()
  • core:改进 set{Timeout,Interval}() 以支持传递参数
  • core:修复 Interceptor 脏状态逻辑中与性能有关的错误

8.1.1:

  • core:添加 Script.nextTick()

8.1.2:

  • core:使 Socket.listen() 和 Socket.connect() 支持 UNIX socket
  • core:修复替换函数中 this.errno / this.lastError 的处理
  • core:添加 SystemFunction API,以在返回时取得 errno / lastError
  • core:修复使用 Stream API 执行 I/O 期间调用 close() 时的崩溃
  • core:修复并统一 V8 运行时的参数处理

8.1.3:

  • core:暂时在 macOS 上禁用 Mapper,以确认它是否为已报告稳定性问题的根本原因
  • core:向 NativeFunction 添加 .call() 和 .apply()
  • objc:修复不透明结构体类型的解析

8.1.4:

  • core:修复 V8 运行时因错误使用 v8::Eternal 导致的崩溃
  • frida-repl:通过 -e 和 -q 添加批处理模式支持

8.1.5:

  • node:只为 6.0(LTS)和 7.0 生成预构建文件

8.1.6:

  • node:除 6.0 和 7.0 外,也为 4.0 和 5.0 生成预构建文件

8.1.7:

  • objc:修复代理某些代理对象时的无限递归
  • objc:支持代理非 NSObject 实例
  • python:修复移除成员函数形式的信号回调

8.1.8:

  • core:实现对单指令 ARM 函数的挂钩
  • core:修复某些体系结构上处理不可挂钩函数时的泄漏
  • core:修复 setImmediate() 回调处理行为
  • core:修复 setTimeout() 中的泄漏
  • core:修复 Duktape 运行时处理 setTimeout(0) 和 setImmediate() 时的竞态条件
  • core:修复 Duktape 运行时处理 tick 回调时的崩溃
  • core:修复 Duktape 运行时中的生命周期问题
  • core:修复 Linux 上报告的模块大小
  • core:修复较新版 Android 上启动应用时的崩溃
  • core:修复尝试启动未安装 Android 应用时的处理
  • core:通过动态检测 Dalvik 和 ART 字段偏移,提高对不同 Android 版本和变体的兼容性
  • core:修复较新版 Android 上的卸载问题;该问题导致只有第一次 attach() 成功,后续尝试全部超时
  • core:将 ObjC 和 Java 移至各自发布到 npm 的模块,并使用 frida-compile 继续将其编入 Frida 内置 JS 运行时
  • java:通过动态检测 ArtMethod 字段偏移提高 ART 兼容性
  • node:更新依赖
  • node:修复未处理的 Promise rejection 问题

8.1.9:

  • core:修复脚本卸载时竞态条件导致的释放后使用

8.1.10:

  • core:使 ApiResolver 和 DebugSymbol API 可抢占,以避免死锁

8.1.11:

  • core:在 macOS 和 iOS 上使用 Mach 异常处理程序,使我们能够可靠捕获已有自身 Mach 异常处理程序的应用中的异常
  • core:修复 Duktape 运行时 InvocationContext 写时复制逻辑中的泄漏;该逻辑用于通过 this 在 onEnter 和 onLeave 之间存储数据

8.1.12:

  • core:修复 V8 运行时中的 Interceptor 参数替换问题;此前参数只会在第一次被替换

祝使用愉快!

Frida 8.0 发布

是时候升级到下一个主版本了。

首先要解决一个长期存在的问题:当多个 Frida 客户端附加到同一进程时,它们不得不相互协调,确保其中一个客户端仍在使用会话时,其他客户端都不会调用 detach()。

对大多数 Frida 用户而言,这可能不算大问题。然而,当多个客户端共享同一个正在运行的 frida-server 时,也会遇到同样的问题。你可能在一个终端中运行 frida-trace,同时在另一个终端中使用 REPL,两者都附加到同一个进程;这时你显然不会希望其中一方调用 detach(),就导致另一方也被踢出。

有些人可能尝试过,并观察到它确实按预期工作,但那是因为 frida-server 中存在一些复杂得惊人的逻辑:它会跟踪有多少客户端对同一进程感兴趣,从而在其他客户端仍订阅同一会话时忽略 detach() 调用。如果某个客户端突然断开,它还有一些逻辑用于清理该客户端的资源,例如脚本。

从 8.0 开始,我们把会话感知移入了 agent,并保持面向客户端的 API 不变,只调整了一个小细节。现在每次调用 attach() 都会获得自己的 Session,而注入的 agent 能够识别该会话。这意味着你可以随时调用 detach(),只有在你的会话中创建的脚本会被销毁。此外,如果你的会话是最后一个存活的会话,Frida 会从目标进程卸载 agent。

这是本次发布的重大变化,但我们并未止步于此。

Frida 脚本的一项重要功能是可以与脚本交换消息。脚本可以调用 send(message[, data]) 发送可序列化为 JSON 的 message,并可选择附带一个二进制 data 数据块。这样一来,你就无需浪费 CPU 周期把二进制数据转换成文本再放进 message。

还可以朝另一个方向通信:脚本调用 recv(callback),当应用向它调用 post_message() 时,通过 callback 获得通知。这样可以向脚本发送可序列化为 JSON 的 message,但无法同时发送二进制 data 数据块。

为弥补这一不足,我们将 post_message() 重命名为 post(),并为其添加了可选的第二个参数,让你可以随消息一起发送二进制 data 数据块。

我们还改进了 C API,把普通 C 数组迁移到了 GBytes,从而尽可能减少数据流经 API 时的复制次数。

最后来总结一下这些变更:

8.0.0:

  • core:添加对多个并行会话的支持
  • core:将 Script 的 post_message() 重命名为 post(),并支持向脚本传递带外二进制数据
  • core:用 GBytes 替换 C 数组以提升性能
  • core:修复 libgee 中释放后使用导致的堆损坏
  • core:修复多处崩溃
  • core:修复 macOS Sierra 上的导出枚举崩溃
  • core:添加在 Valgrind 上运行的基本支持
  • core:将 macOS 最低要求提升至 10.9,以便依赖 libc++
  • node:更新到新的 8.x API
  • python:更新到新的 8.x API
  • swift:更新到新的 8.x API
  • swift:升级到 Swift 3
  • qml:更新到新的 8.x API
  • clr:更新到新的 8.x API
  • clr:修复泄漏

8.0.1:

  • node:修复 Script#post()

8.0.2:

  • core:修复从 JS 线程调用 recv().wait() 时的死锁

8.0.3:

  • core:将 Interceptor 的基础开销最多降低 65%
  • core:在 V8 运行时中尽量减少 Interceptor 引发的 GC 抖动,采用与 Duktape 运行时相同的回收和写时复制技巧
  • core:加快 macOS 和 iOS 上的 gum_process_get_current_thread_id()

尽情使用吧!

Frida 7.3 发布

终于又到发布时间了,这次的重点是提高质量。距离上次升级第三方依赖已经过去一段时间, 而我发现自己正在追查 GLib 中一个上游已经修复的内存泄漏,所以觉得该升级依赖了。 因此我很高兴宣布,此版本现已包含最新的 V8、GLib、Vala 编译器等。 我们也非常注重消除资源泄漏,所以你可以附加到长时间运行的进程,而不必担心内存分配或 OS 句柄不断堆积。

最后,总结一下这些变更:

7.3.0:

  • core:升级到最新 V8、GLib、Vala、Android NDK 等
  • core:堵住资源泄漏
  • core:修复 Linux/x86-32 上的线程枚举
  • core:(arm64) 通过支持重定位目标寄存器为 FP/SIMD 的 LDRPC,改进函数钩挂

7.3.1:

  • core:像过去一样使用 PIE 构建 Android 二进制文件

7.3.2:

  • core:添加 Script.setGlobalAccessHandler(),用于处理访问未声明全局变量的尝试,对构建 REPL 很有用

7.3.3:

  • objc:期望对象时,将 Number 转换为 NSNumber
  • objc:支持自动转换为对象数组,在调用 +[NSArray arrayWithObjects:count:] 等方法时很有用

7.3.4:

  • core:改进不稳定的 accessor API
  • core:修复 Duktape globals accessor 逻辑,使其仅应用于读取

7.3.5:

  • core:改进 hexdump(),以支持任何符合 NativePointer 的对象
  • objc:修复对 L 类型的处理

7.3.6:

  • core:修复 devkit 头文件自动生成逻辑的回归问题

尽情享用!

Frida 7.2 发布

有些读者可能知道,Frida 有两个 JavaScript 运行时:一个基于 V8,另一个基于 Duktape。 我们过去还有一个基于 JavaScriptCore 的运行时,但后来事实证明,在所有不适合 V8 的场景中,例如微型嵌入式系统以及禁止 RWX 内存页的系统上,Duktape 运行时都表现得更好,因此 JavaScriptCore 运行时退役了。

值得一提的是,Duktape 提供了编译为字节码的 API。这样就能缓存已编译的代码,在需要 对新进程进行插桩时节省宝贵的启动时间。从本次发布开始,我们提供了全新的 API,可将 JavaScript 编译为字节码,当然也可以从字节码实例化脚本。V8 运行时尚不支持此 API, 不过下次升级 V8 后,我们应该可以利用最近版本中开始出现的 WebAssembly 基础设施来实现它。

闲话少叙,让我们通过 Session.disable_jit() 强制 Frida 优先使用 Duktape,试用一下 Duktape 运行时中的这项新 API。

在 Node.js 中:

const co = require('co');
const frida = require('frida');

co(function* () {
  const systemSession = yield frida.attach(0);
  yield systemSession.disableJit();
  const bytecode = yield systemSession.compileScript(`
    rpc.exports = {
      listThreads() {
        return Process.enumerateThreadsSync();
      }
    };
  `);

  const session = yield frida.attach('Twitter');
  yield session.disableJit();
  const script = yield session.createScriptFromBytes(bytecode);
  yield script.load();

  const api = yield script.getExports();
  console.log('api.listThreads() =>', yield api.listThreads());

  yield script.unload();
})
.catch(err => {
  console.error(err);
});

在 Python 中:

import frida

system_session = frida.attach(0)
system_session.disable_jit()
bytecode = system_session.compile_script("""
rpc.exports = {
  listThreads() {
    return Process.enumerateThreadsSync();
  }
};
""")

session = frida.attach("Twitter")
session.disable_jit()
script = session.create_script_from_bytes(bytecode)
script.load()

api = script.exports
print("api.list_threads() =>", api.list_threads())

请注意,此处同样存在 Duktape 文档中说明 的限制,因此请确保要加载的代码格式正确,并由同一版本的 Duktape 生成。升级到未来版本的 Frida 时,Duktape 可能也会升级;不过字节码至少与架构无关,也就是说,你可以在 64 位 x86 桌面系统上编译为字节码,再顺利加载到 ARM 上的 32 位 iOS 应用中。

以上是通过 API 编译字节码,不过你可能更希望改用 frida-compile CLI 工具:

$ npm install frida-compile
$ ./node_modules/.bin/frida-compile agent.js -o agent.bin -b

开发期间还可以添加 -w 使用监视模式。该模式会监视输入,并在其中任意文件变化时执行 快速增量构建。

无论是否使用字节码(-b),我们都强烈推荐 frida-compile,因为它还有许多其他优点, 可以让你:

  • 使用 require() 将脚本拆分成多个 .js 文件。
  • 利用 npm 上成千上万个现有模块,其中也包括一些 Frida 专用模块。例如: frida-trace、 frida-uikit、 frida-screenshot 等。
  • 使用 ES6 语法,并将代码编译为 ES5,以兼容 Duktape 运行时。

最后,我们来汇总一下变更:

7.2.0:

  • core:支持编译和加载字节码,以及从字节码加载
  • core:在 RPC 错误响应中包含错误名称和堆栈跟踪
  • node:支持新的字节码 API
  • node:在可用时为 RPC 错误补充 name 和 stack
  • node:将示例迁移到 ES6
  • python:支持新的字节码 API
  • python:适配修订后的 RPC 协议

7.2.1:

  • objc:支持解析精简 Objective-C 代理上的方法

7.2.2:

  • objc:修复返回结构体和浮点值的方法处理

7.2.3:

  • objc:公开 Objective-C 方法的原始句柄

7.2.4:

  • core:修复在 iOS 9 上很容易复现的死锁
  • java:提高 Java.perform() 的稳健性,并改进对非应用进程的处理

7.2.5:

  • objc:修复 x86-64 上通过寄存器返回结构体的方法处理

7.2.6:

  • core:将 Gum 移植到 MIPS
  • core:避免在 Proxy 对象行为异常时吞掉异常
  • objc:支持访问 Objective-C 实例变量

7.2.7:

  • core:将 .so 注入器移植到 MIPS
  • core:为 MIPS 模糊回溯器增加更多分支并链接指令
  • core:修复 UnixInputStream 和 UnixOutputStream 在 TTY 上的可轮询行为, 解决脚本卸载时挂起的问题
  • core:移除 hexdump() 偏移量中的“0x”前缀

7.2.8:

  • objc:修复类型提示解析
  • objc:支持包含类型提示
  • objc:公开 ObjC.Block 的 types 字段
  • objc:支持正确声明 void *
  • core:(MIPS)修复获取/设置栈参数时的栈偏移

7.2.9:

  • core:修复 V8 运行时中无法写入寄存器的错误

7.2.10:

  • core:支持附加到 iOS 模拟器进程
  • core:修复 7.2.4 引入的 Android 类解析回归

7.2.11:

  • core:始终通过 SpringBoard 终止 iOS 应用

7.2.12:

  • objc:在卸载和 GC 时注销 Objective-C 类

7.2.13:

  • core:修复 iOS 9 上的应用终止逻辑

7.2.14:

  • core:让 Duktape 运行时像 V8 运行时一样可被抢占
  • core:修复 V8 运行时中的几个锁错误

7.2.15:

  • core:也在 Duktape 运行时中实现 Kernel API
  • core:移除危险的 Kernel.enumerateThreads() API

7.2.16:

  • core:提高快速重新附加到同一进程时的稳健性
  • core:修复分离时存在待处理调用所导致的死锁
  • core:修复 32 位 ARM 上的挂钩回归
  • core:修复 Linux 上 frida-gadget 中的 dlsym() 死锁
  • core:修复 Windows 构建回归
  • core:修复 iOS 7 回归

7.2.17:

  • core:修复会话拆卸回归

7.2.18:

  • core:修复 iOS 9 上长期存在的稳定性问题:注入的引导代码未进行伪签名,导致进程 最终失去 CS_VALID 状态
  • core:消除不必要的磁盘 I/O,加快 iOS 应用启动速度
  • core:修复 iOS 上的临时目录清理

7.2.19:

  • core:修复 Duktape 运行时中与抢占相关的生命周期问题

7.2.20:

  • core:重构 V8 运行时,以支持完全异步卸载
  • core:重构 Duktape 运行时,以支持完全异步卸载
  • core:让 Duktape 运行时完全可重入
  • core:新增 Script.pin() 和 Script.unpin(),用于在关键时刻延长脚本生命周期, 例如等待来自无法控制的外部 API 的回调时
  • core:修复 V8 和 Duktape 运行时中与定时器相关的泄漏
  • objc:让脚本保持存活,直到 ObjC.schedule() 调度的回调执行完毕
  • objc:向 ObjC 代理 API 添加 dealloc 事件

7.2.21:

  • core:修复 detach() 时挂起的问题

7.2.22:

  • core:修复脚本卸载时挂起的问题
  • core:修复 detach() 期间连接突然中断时挂起的问题

7.2.23:

  • core:修复脚本卸载期间两个低概率崩溃问题

7.2.24:

  • core:修复 Duktape 运行时中的释放后使用问题
  • core:修复 ModuleApiResolver 中的释放后使用错误
  • core:改进设置异常处理程序时的卸载行为

7.2.25:

  • core:修复 iOS 9.3.3 上的应用启动
  • frida-server:修复另一个客户端附加到同一进程时,分离操作“挂起”的问题

尽情使用吧!

Frida 7.1 发布

如果你曾经使用 Frida 启动会用到标准输入输出的程序,可能会因为被启动进程的标准输入输出状态 相当不明确、自己又几乎无法控制而感到沮丧。从这个版本开始,我们着手解决这个问题。现在, 程序启动时的 stdin、stdout 和 stderr 始终会被重定向;你甚至可以向 stdin 输入自己的数据,并取得写入 stdout 和 stderr 的数据。Frida 的命令行工具无需额外改动 即可获得这项能力,因为它已经在 ConsoleApplication 基类中接好。 如果你没有使用 ConsoleApplication,或使用的是另一种语言绑定,只需连接到 Device 对象的 output 信号。每当该信号发出时,你的处理程序都会依次收到三个参数:pid、fd 和 data。调用同一个类的 input() 方法即可写入 stdin。就这么简单。

现在我们已经统一了各个平台上的标准输入输出行为,以后便可以添加用于禁用标准输入输出重定向的 API。

除了这项改进和大量错误修复外,我们还大幅增强了在 Darwin 上启动普通程序的支持, 涵盖 Mac 和 iOS。现在两个平台上的 spawn() 都快如闪电,而且不会再破坏 iOS 上的代码签名状态。

对于需要对 Mac 和 iOS 应用进行高级插桩的用户,现在还有一套全新的 API, 可在运行时动态创建自己的 Objective-C 协议。我们已经支持创建新类和代理对象, 有了这套新 API,你能做的事情更多了。

最后,总结一下各项变更:

7.1.0:

  • core:添加 Device.input() API,用于向已启动进程的 stdin 写入数据
  • core:添加 Device.output 信号,用于传递已启动进程的输出
  • core:在 Windows、Darwin 和 Linux 后端中实现新的 spawn() 标准输入输出行为
  • core:由于 4.x 存在严重回归,目前降级到 Capstone 3.x
  • node:支持新的标准输入输出 API
  • node:补上错误路径中缺失的 return
  • python:支持新的标准输入输出 API

7.1.1:

  • core:修复 spawn() 中偶发的崩溃

7.1.2:

  • core:重做 Darwin 上的 spawn() 实现,现在速度更快、可靠性更高
  • core:支持在 Darwin 上枚举和查找动态符号
  • core:修复 Darwin Mach-O 解析器中的页面大小计算

7.1.3:

  • core:撤销临时 hack

7.1.4:

  • python:修复 ConsoleApplication 在 EOF 时崩溃的问题
  • frida-trace:退出前刷新排队中的事件

7.1.5:

  • frida-repl:改进 REPL 自动补全
  • objc:添加用于动态创建协议的 ObjC.registerProtocol()
  • objc:修复类名冲突的处理
  • objc:允许为代理命名

7.1.6:

  • python:修复 setup.py 的下载回退机制

7.1.7:

  • python:改进 setup.py 的下载回退机制

7.1.8:

  • python:修复 setup.py 的本地回退机制,改为在主目录中查找

7.1.9:

  • core:修复同时发出多个请求以附加到同一 pid 时的处理
  • core:(Darwin) 修复未调用 attach() 时的 spawn()
  • core:(Darwin) 修复关闭请求重叠时的崩溃
  • frida-server:始终重复使用同一个临时目录

7.1.10:

  • core:(Windows) 从 VS2013 升级到 VS2015
  • node:添加 Node.js 6.x 的预构建版本
  • python:修复 Python 2.x 上 Unicode 命令行参数的处理
  • qml:在 Mac 上使用 libc++ 取代 libstdc++

7.1.11:

  • core:远程 Frida 不兼容时提供恰当的错误消息
  • core:忽略从系统会话分离的尝试
  • core:防止 create_script() 与 detach() 重叠执行
  • core:修复 setTimeout(),使延迟参数可以省略,默认值为 0
  • core:(V8 runtime) 修复已关闭的 File 对象被垃圾回收时的崩溃
  • core:(Darwin) 修复清理时偶发的崩溃
  • core:(QNX) 修复 gum_module_find_export_by_name() 的实现
  • core:(QNX) 实现临时 TLS 存储
  • frida-repl:监视已加载的脚本,并在发生变化时自动重新加载
  • node:处理日志消息时考虑 level,使 console.warn() 和 console.error() 输出到 stderr 而不是 stdout
  • node:不再让会话阻止运行时退出

7.1.12:

  • core:修复 size = 0 时 Memory.readByteArray() 的返回值

7.1.13:

  • core:(Linux/Android) 修复具有首选基址的库的导出地址计算
  • core:修复 Android 6.0 上的 Java API not available 错误
  • java:通过考虑操作系统版本和架构改进 ART 支持
  • frida-repl:添加 –no-pause,使已启动进程在启动时不暂停

尽情享用吧!

Frida 7.0 发布

距离上一次大版本升级已经有一段时间了。这一次,我们解决了一个长期存在的 问题:64 位整数此前被表示为 JavaScript Number 值。由于底层表示形式是 双精度浮点数,这意味着超过 53 位的值会出现问题。

Memory、NativeFunction 和 NativeCallback API 中的 64 位类型 现在会由新引入的 Int64 和 UInt64 类型正确表示,它们的 API 与 NativePointer 几乎完全一致。

现在让我们祈祷 int64/uint64 能够进入 ES7。

最后,这里汇总一下各项变更:

7.0.0:

  • core:重新设计 64 位整数的处理方式
  • core:提高构造函数的严格程度
  • core:改进 QNX 支持
  • frida-repl:更新徽标

7.0.1:

  • core:修复 32 位架构上 Int64/UInt64 字段容量的问题

7.0.2:

  • core:允许将 Int64 和 UInt64 原样传给所有相关 API
  • core:修复 ObjC 实例上 $protocols 的处理

7.0.3:

  • core:修复监听器在调用途中被销毁的竞态条件
  • core:修复嵌套原生异常作用域的处理
  • core:改进 QNX 支持
  • frida-repl:微调启动消息

7.0.4:

  • core:大幅提高 32 位 ARM 上函数 Hook 的成功率
  • core:提高 64 位 ARM 上函数 Hook 的成功率
  • core:修复 Interceptor 在 32 位 ARM 上暴露的 sp 值

7.0.5:

  • core:生成 iOS 应用并等待 Device#resume() 时运行主 CFRunLoop, 从而可在主线程应用对线程敏感的早期插桩

7.0.6:

  • core:修复 32 位 ARM 上半字对齐函数的 Hook
  • core:修复 Linux 上的线程枚举
  • core:为 Script 运行时添加简单的 hexdump() API
  • core:使 Duktape 运行时的 CpuContext 可序列化为 JSON

7.0.7:

  • core:允许向 hexdump() 传入 NativePointer

7.0.8:

  • core:修复 retval.replace() 对包装对象的处理
  • core:修复指定大小时 Memory.readUtf8String() 的行为
  • core:支持 iOS 9.1 越狱中的新 task_for_pid(0) 方法
  • core:不再使用某些处理器的 ARM 模式中不可用的 cbnz
  • core:为 QNX 实现 enumerate_threads() 和 modify_thread()

7.0.9:

  • core:修复 FridaGadget.dylib 在 iOS 上配合 ios-deploy 以及其他 先于 CoreFoundation 加载我们的环境运行时发生的早期崩溃
  • core:在 Darwin 上 frida-helper 的主线程中运行 CFRunLoop, 使系统会话脚本能够使用更多 Apple API
  • core:添加用于处理 GIO 流的流式 API,目前仅通过 UnixInputStream 和 UnixOutputStream(UNIX),以及 Win32InputStream 和 Win32OutputStream(Windows)公开

7.0.10:

  • core:修复存在待处理 I/O 操作时卸载脚本导致的死锁

7.0.11:

  • core:FridaGadget.dylib 阻塞等待 Device#resume() 时运行主 CFRunLoop, 从而可在主线程应用对线程敏感的早期插桩
  • java:修复方法类型的健全性检查

祝你使用愉快!

Frida 6.2 发布

又到了发布时刻。本次我们为所有平台带来了大幅性能提升、一个全新的函数查找 API,以及 iOS 9 上的重要稳定性改进。

先谈最后一项。有些用户可能注意到,在 iOS 9 上使用 Frida 时会出现奇怪的错误和死锁。根本原因很简单:内联挂钩会让进程失去其代码签名状态中的 CS_VALID 位。在 iOS 8 及更早版本中,这不是问题,因为越狱工具总能修补内核,放宽代码签名要求。从本次发布开始,我们实现了一些技巧,可以在不破坏代码签名状态的情况下进行内联挂钩。对技术细节感兴趣的读者:我们会动态生成一个临时 .dylib 文件,写入希望修改的内存页的新版本,例如包含 open() 的 libc 内存页;然后对该二进制文件进行伪签名,请求内核对它执行 F_ADDFILESIGS,最后从该文件 mmap() 到原始内存页之上。

这就引出了下一个话题:性能。刚才介绍的技巧仅仅为了挂钩一个函数,就会增加不少额外开销。它与在支持读写执行内存页、代码签名要求宽松的系统上所采用的方法也截然不同,显然需要进行重大的架构调整。我也一直在考虑一次应用整批挂钩,以提高效率,并更精确地控制挂钩何时激活。

从本次发布开始,Interceptor API 支持事务。只需调用 begin_transaction(),挂钩所有函数,再调用 end_transaction() 一次性激活。这会大幅提升性能,而且无需修改现有代码就能自动受益。因为每当进入 JavaScript 运行时,我们会隐式开始一个事务;离开时(以及 send() 消息或从 RPC 方法返回前)结束事务。因此,除非通过定时器或 Memory.scan() 等异步 API 附加挂钩,否则所有挂钩都会合并到单个事务中并获得性能提升。

下面是我们与 CydiaSubstrate 的性能对比:

请注意,如果通过 C 或 C++ 使用插桩引擎,就必须自行调用 begin_transaction() 和 end_transaction() 才能获得这项提升;即使不调用,代码仍可工作,因为每项操作都会隐式包含一个事务,而且 API 允许嵌套这些调用。

以上是函数挂钩性能,但我们并未止步于此。如果你曾用 frida-trace 跟踪 Objective-C API,或在所有已加载库中使用 glob 查找函数,可能会发现解析所有函数要花很长时间。结合早期插桩时,甚至可能耗时过长,超过系统的启动超时。现在这一切都已优化:典型的 Objective-C 场景过去需要数秒,如今只需几毫秒。

最后一项消息。动态发现待挂钩函数是一种非常常见的场景,并非只有 frida-trace 会这样做,因此我们现在为此提供了全新 API:

ApiResolver #1

ApiResolver #2

最后汇总一下变更:

6.2.0:

  • core:改进 Interceptor,避免破坏 iOS 9 上的动态代码签名
  • core:迁移到基于事务的 Interceptor API,以提升性能
  • core:修复延迟释放已调度回调时的崩溃(V8 和 Duktape)
  • frida-trace:移除 setTimeout() 逻辑以提升性能,使多个挂钩可在同一事务中应用
  • frida-trace:以 50 ms 为单位批量处理日志事件,以提升性能

6.2.1:

  • core:添加 ApiResolver API
  • frida-trace:使用新的 ApiResolver API 提升性能

6.2.2:

  • core:修复导致无法注入 Windows Store/Universal 应用的疏忽
  • core:修复 32 位 ARM 上拆卸时的崩溃
  • core:添加 frida-inject,用于将 Agent 注入运行中进程,其语义类似 frida-gadget
  • core:(Linux)阻止 libdl 卸载,以规避 TLS 析构函数错误
  • core:(Linux)修复快速取消注入时的竞态条件

6.2.3:

  • core:修复 eval 代码的源映射处理问题,该问题会导致未处理异常被吞掉,例如运行 frida-trace 时
  • core:修复 Python 3.x 构建系统回归
  • frida-trace:修复路径转义问题
  • frida-trace:改进错误处理程序异常时的错误处理

6.2.4:

  • frida-trace:监视处理程序,不再轮询

6.2.5:

  • core:支持通过向 Interceptor.attach() 传入函数而非回调对象来挂钩任意指令
  • core:支持分离由 Interceptor.attach() 添加的单个监听器,甚至可从其回调中同步分离
  • core:添加 Memory.scanSync()
  • core:改进 Interceptor,保留 ARM 上的 r12(即 IP),修复寄存器破坏
  • core:向 JavaScript 运行时公开 r8 到 r12
  • core:修复不支持未对齐字访问的架构上的崩溃
  • frida-repl:使用 RPC 功能简化逻辑
  • node:升级到 prebuild 3.x

6.2.6:

  • core:修复未越狱 iOS 系统上的回归
  • core:修复 Duktape 运行时中的 Interceptor 回归
  • core:修复解析后导入项的模块名称
  • core:添加用于指定连接主机的 API
  • core:改进 QNX 支持并修复构建回归
  • core:修复 Mac 上的 frida-inject 构建系统
  • core:(Windows)修复获取 USB 设备位置失败时的崩溃
  • frida-server:允许覆盖默认监听地址
  • frida-node:向 DeviceManager 添加 addRemoteDevice() 和 removeRemoteDevice()
  • frida-python:添加 -H 开关,用于指定要连接的主机
  • frida-python:向 DeviceManager 添加 add_remote_device() 和 remove_remote_device()
  • frida-python:修复与 Duktape 运行时的兼容性问题
  • frida-python:规范化请求的 RPC 方法名称

尽情使用吧!

Frida 6.1 发布

一段时间前,@s1341 将 Frida 移植到了 QNX;就在几周前, 他在嵌入式 ARM 设备上使用 Frida 时遇到了内存占用问题。这正值他贡献将 Frida 移植到 linux-arm 的 pull request 之后。我们开始意识到,可能该引入一个新的 JavaScript 运行时了,并一致认为 Duktape 非常符合我们的需求。

该运行时现已落地,所有测试均已通过;在测量带空 onEnter/onLeave 回调的 被钩住函数调用开销时,它甚至击败了 V8 运行时。下面是一个直观对比:

…/interceptor_on_enter_performance: V8 min=2 max=31 avg=2 OK
…/interceptor_on_enter_performance: DUK min=1 max=2 avg=1 OK

(数值单位为微秒,在运行 OS X 10.11.2 的 4 GHz i7 上测得。)

不管怎样,即使这一对比并不完全公平——我们在新运行时里使用了一些巧妙的回收和写时复制技巧, 而 V8 运行时还没有——这个新运行时已经相当令人印象深刻。它还让我们能在非常微型的设备上运行; 对大多数 Frida 用户而言,像 V8 这样由 JIT 驱动的怪兽与纯解释器之间的性能差异,可能并不真的重要。

因此从此版本开始,我们也在所有预构建二进制文件中包含这个全新运行时,让你可以尝试并告诉我们使用效果。 它只增加几百 KB 的体积,与 V8 为每个架构切片增加的 6 MB 相比微不足道。 请通过向 CLI 工具传入 --disable-jit,或在首次调用 session.create_script() 前调用 session.disable_jit() 来试用它。

考虑到这个新运行时还解决了一些需要在 JavaScriptCore 运行时中投入大量工作才能修复的问题, 例如忽略来自后台线程的调用并避免污染应用的堆,我们决定放弃该运行时,并在 V8 目前无法运行的操作系统上, 例如 iOS 9,切换到基于 Duktape 的新运行时。我们会在运行时进行特性检测,所以你仍可在 iOS 8 上像以前一样使用 V8—— 除非你按前面所说显式使用 --disable-jit。

最后,以下是变更摘要:

6.1.0:

  • core:用基于 Duktape 的后继者替换 JavaScriptCore 运行时
  • core:添加 disable_jit(),让用户可以试用新 Duktape 引擎
  • core:修复 Linux 上注入进程时的崩溃,该进程中 pthread_create 从未被调用/绑定
  • core:添加对 linux-armhf(例如 Raspberry Pi)的支持
  • python:向 Session 添加 disable_jit()
  • node:向 Session 添加 disableJit()
  • CLI 工具:添加 –disable-jit 开关
  • frida-repl:升级到最新 prompt-toolkit
  • frida-trace:修复尝试跟踪部分解析的导入时的崩溃
  • frida-trace:生成的处理器使用 ES5,以兼容 Duktape

6.1.1:

  • core:修复 Duktape 运行时中的同步逻辑和错误处理问题

6.1.2:

  • core:修复导致注入时崩溃的 Android 回归
  • core:修复 Python 3.x 构建回归
  • clr:向 Session 添加 DisableJit()

6.1.3:

  • core:为 iOS frida-helper 授予 Preferences 应用拥有的所有 entitlement,使系统会话脚本可读写系统配置
  • core:为支持临时目录/文件上的 AppContainer ACL 而做出变更
  • node:修复 pid 检查,使其允许附加到系统会话

6.1.4:

  • core:为 iOS 上的控制台二进制文件实现 spawn()
  • core:改进对钩挂低层 OS API 的支持
  • core:修复 mapper 问题,该问题阻止我们注入到尚未加载 frida-agent 依赖库的 Mac 进程
  • core:让替换后的函数也可以使用 InvocationContext

6.1.5:

  • core:在 frida-load 生成的脚本中添加对生成器函数的支持
  • frida-repl:修复导致挂起的竞态条件
  • frida-repl:修复退出时的伪错误消息

尽情享用!

Frida 6.0 发布

这是一次重量级发布,带来了全新的 iOS 9 支持和全面改进。更多背景请参阅我的两篇博客文章:这里和这里。

内容很多,概要如下:

6.0.0:

  • core:支持 OS X El Capitan
  • core:支持 iOS 9
  • core:修复 Cydia 软件包中的 launchd plist 权限
  • core:暂时在 iOS 上禁用我们的动态链接器
  • core:添加基于 JavaScriptCore 的新 JavaScript 运行时,因为当前越狱环境无法在 iOS 9 上使用 V8
  • core:附加到 pid=0 时添加全新的系统会话
  • core:改进 arm 挂钩,包括支持开头的 TBZ/TBNZ/IT/B.cond,并避免重定位后续指令会循环跳回的指令
  • core:修复 arm64 上 LDR.W 指令的重定位
  • core:陷入异常循环时中止
  • core:修复与 AutoIgnorer 有关的死锁
  • core:移除 . 前缀,使临时文件更容易发现
  • python:支持在没有 ES6 支持的情况下运行
  • python:调整 setup.py,允许离线安装
  • python:暂时将 prompt-toolkit 版本锁定为 0.38
  • frida-repl:修复 Memory.readByteArray() 返回的原始缓冲区显示
  • frida-repl:修复补全出错时的崩溃
  • node:支持 DeviceManager 的 added 和 removed 信号
  • node:添加监视可用设备的示例
  • node:使用 prebuild 代替 node-pre-gyp
  • node:对 frida.load() 读取的源代码执行 Babel 转换
  • node:移除 frida.load(),因为它现在位于 frida-load 模块中

6.0.1:

  • python:停止提供 3.4 二进制文件,转而提供 3.5
  • node:修复 Linux 链接问题,该问题导致无法使用我们自己的 libffi
  • node:也为 Node.js LTS 生成预构建包

6.0.2:

  • core:提供 FridaGadget.dylib,用于在未越狱情况下对 iOS 应用进行插桩
  • core:支持 iOS 模拟器
  • core:改进 MemoryAccessMonitor,允许监视内存页上 R、W、X 操作的任意组合
  • python:修复 Python 2.x 上 UTF-8 字段被意外公开为 str 的问题

6.0.3:

  • core:修复 OS X 上的 spawn()

6.0.4:

  • core:部分支持独立使用 gadget
  • CLI tools:修复 stdout 编码无法表示所有字符时的崩溃
  • frida-trace:始终将处理程序脚本视为 UTF-8

6.0.5:

  • core:向 NativePointer 添加逻辑左移和右移操作
  • core:改进 Interceptor,支持附加到被替换的函数
  • core:支持挂钩 32 位 ARM 上的微型函数
  • core:在 Windows 上模拟 {Get/Set}LastErrror 和 TLS 键访问,使我们能够挂钩更多底层 API

6.0.6:

  • core:修复 iOS 9 上的 launchd / Jetsam 问题
  • core:修复 iOS 9 代码签名问题
  • core:更新命名管道的安全属性,使我们能够注入更多 Windows 应用

6.0.7:

  • core:支持注入 linux-arm 上的进程
  • core:修复 Mac 和 iOS 上与 DebugSymbol API 有关的崩溃
  • frida-trace:改进 manpage 解析器

6.0.8:

  • core:修复未静态链接 libstdc++ 导致的 Linux 兼容性问题

6.0.9:

  • core:支持独立运行 frida-gadget
  • core:为 Windows 兼容性回归添加临时规避措施
  • core:将 Fruity 后端移植到 Linux,允许直接访问已连接的 iOS 设备
  • core:也在 JavaScriptCore 运行时中以可读写方式公开 InvocationContext context
  • core:修复 InvocationContext 的 CpuContext 被过早 GC 的问题

6.0.10:

重新发布 6.0.9,并修复 Windows 构建回归。

6.0.11:

  • core:发生网络错误时避免遗留过期的 HostSession 对象
  • CLI tools:stdout 编码未知时假定使用 UTF-8
  • node:修复使用错误 Nan API 导致的重复释放

6.0.12:

  • core:更新 Windows 上命名管道的安全属性
  • core:添加 CreateProcessW 标志,防止 Windows 上的 IFEO 循环
  • core:修复 arm 和 arm64 上递归函数的挂钩
  • python:修复 Python 3 换行符回归
  • node:更新 prebuild 依赖

尽情使用吧!

Frida 5.0 发布

哇,又一个主版本发布了!我们决定修改 Device API,为设备提供持久 ID,这样在设备热插拔时就能轻松区分不同设备。

但这只是开始,本次还带来了大量其他改进:

5.0.0:

  • core:修改 Device.id,使其在设备重新连接后仍表示同一个设备
  • core:添加新的 Droidy 后端,用于与已连接的 Android 设备交互
  • core:调整 Darwin 上容易引起困惑的 iPhone 5+ 设备名称
  • core:规范后备 iOS 设备名称,使其与 Android 保持一致
  • core:将 V8 升级至 4.5.103.30
  • objc:在 $methods 和 $ownMethods 中同时包含类方法与实例方法
  • python:添加 -D 开关,用于指定要连接的设备 ID
  • python:添加 frida-ls-devices CLI 工具,用于列出设备
  • python:更新到新的 Device.id API
  • python:添加 get_local_device(),并改善与 frida-node 的 API 一致性
  • node:更新到新的 Device.id API
  • node:改进顶层 facade API
  • qml:更新到新的 Device.id API
  • clr:更新到新的 Device.id API
  • frida-ps:改进输出格式

5.0.1:

  • core:添加 source map 支持
  • node:添加 frida.load(),用于将 CommonJS 模块转换为脚本
  • node:升级 Nan

5.0.2:

  • core:添加 console.warn() 和 console.error()
  • core:添加 Module.enumerateImports(),并在 Darwin、Linux 和 Windows 上实现
  • core:调用 Module.findExportByName() 时允许模块名为 null
  • core:将 Darwin.Module 和 Darwin.Mapper 从 frida-core 移到 frida-gum,以便轻松解析 Mach-O 并执行进程外动态链接
  • core:更妥善地处理临时文件
  • frida-trace:支持便捷跟踪导入函数
  • frida-trace:将 dyld_stub_binder 加入跟踪黑名单
  • python:避免日志被不断变化的状态消息覆盖

5.0.3:

  • core:改进 arm64 hook,包括支持 hook 短函数

5.0.4:

  • core:改进 arm64 hook,同时注意避免重定位其他指令所依赖的指令,包括 BL/BLR/SVC 指令之后的下一条指令
  • core:将 Arm64Writer 和 Arm64Relocator 移植到 Capstone

5.0.5:

  • core:使用 GLib 补丁提供的新 API,修复销毁时的崩溃
  • core:修复 Linux 上的模块名称解析
  • core:改进 ELF 处理,把 ET_EXEC 镜像也视为有效模块
  • core:改进 arm64 hook
  • core:将 {Arm,Thumb}Writer 和 {Arm,Thumb}Relocator 移植到 Capstone
  • python:修复 OS X 10.11 上的测试
  • node:修复 OS X 10.11 上的测试

5.0.6:

  • core:在可能的情况下,把 NativeFunction 调用崩溃转化为 JS 异常
  • core:添加 Process.setExceptionHandler(),用于从 JS 处理原生异常
  • core:安装一个会发出错误消息的默认异常处理程序
  • core:如果我们在进程生命周期早期安装异常处理程序,则阻止应用覆盖它
  • core:无法替换原生函数时进行优雅处理
  • core:允许 RPC 导出返回 ArrayBuffer 值
  • python:支持 RPC 方法返回 ArrayBuffer 对象
  • node:支持 RPC 方法返回 ArrayBuffer 对象

5.0.7:

  • core:暂时不安装默认异常处理程序

5.0.8:

由于构建机器出现问题,重新发布 5.0.7。

5.0.9:

  • python:更新 setup.py,以匹配新的构建服务器配置

5.0.10:

  • core:修复对早期使用 IP 寄存器的 arm64 函数进行插桩的问题

尽情使用吧!

Frida 4.5 发布

又到了内容丰富的新版本发布时间。这一次,我们带来了全新的进程启动门控 API, 让你可以捕获系统启动的进程;此外还有大量 Android 改进以及遍布各处的提升。

闲话少说,下面是变更列表:

4.5.0:

  • core:添加 Process.pageSize 常量
  • core:允许 Memory.alloc() 在 size >= 页面大小时分配原始页面
  • core:修复 NativeFunction 对小型返回类型的处理
  • core:修复重写 BLX 指令时的 PC 对齐
  • core:添加进程启动门控 API
  • core:在 Android 上实现 get_frontmost_application()
  • core:在 Android 上实现 enumerate_applications()
  • core:支持启动 Android 应用
  • core:支持在 Android 上向 arm64 进程注入
  • core:添加对 Android M 的支持
  • core:实时修补内核的 SELinux 策略
  • core:与 SuperSU 集成,以绕过 Samsung 内核上的限制
  • core:规避 Android 上损坏的 sigsetjmp,并包含许多其他 Android 修复
  • core:修复在 Linux 上枚举模块时的崩溃
  • core:优化 Darwin 上远程进程的导出项枚举
  • dalvik:移植到 ART,并弃用 Dalvik 名称,现在称为 Java
  • java:添加 Java.openClassFile(),允许在运行时加载类
  • java:修复数组转换和字段设置器
  • python:支持新的进程启动门控 API
  • python:也允许 Python 2.x 中的脚本源代码和名称使用 Unicode
  • python:修复 Python 3.x 中的错误传播
  • python:修复 Linux 下载 URL 的计算
  • node:支持新的进程启动门控 API
  • node:移植到 Nan 2.x

4.5.1:

  • core:修复 ensure_host_session() 的错误传播

尽情享用吧!

Frida 4.4 发布

随着 4.4 发布,我们带来了全新的 RPC API,让应用与脚本通信以及由脚本向应用公开服务变得非常简单。我们还收到了 Adam Brady 的精彩贡献:他将 frida-node 移植到 Nan,从而可轻松面向多个 Node.js 版本构建。

本次发布总结如下:

  • core:新增 RPC API
  • python:支持调用 RPC 导出
  • node:支持调用 RPC 导出
  • node:允许发送任何可序列化为 JSON 的消息值
  • node:移植到 Nan

尽情体验吧!

Frida 4.3 发布

又到发布时刻了,这次各处都有大量改进。简要如下:

4.3.0:

  • core:支持获取最前端应用的详细信息,最初仅支持 iOS
  • python:新增 Device.get_frontmost_application()
  • node:新增 Device.getFrontmostApplication()

4.3.1:

  • core:支持在 arm64 上重定位相对 PC 的 CBZ
  • frida-repl:修复 Py3k 上的崩溃和脚本加载问题

4.3.2:

  • core:支持通过 URL 启动 iOS 应用
  • dalvik:修复字段缓存错误
  • frida-trace:根据线程 ID 和深度为事件着色并缩进
  • frida-ps:修复 Py3k 上的应用列表

4.3.3:

  • core:重新启用被意外禁用的 Darwin mapper

4.3.4:

  • core:妥善处理替换函数的尝试
  • core:Interceptor 的 attach() 和 replace() 失败时抛出异常
  • core:修复 Agent 会话清理
  • core:修复断言日志,并在 Darwin 上记录到 CFLog
  • dalvik:新增 Dalvik.synchronized()、Dalvik.scheduleOnMainThread() 和 Dalvik.isMainThread()
  • dalvik:将 Dalvik.androidVersion 和 Dalvik.choose() 移植到 Android 4.2.2
  • python:修复 windows-i386 的 PyPI 下载 URL
  • frida-trace:妥善处理 attach() 失败

4.3.5:

  • frida-server:改进资源跟踪

4.3.6:

  • core:修复 arm64 函数 Hook
  • dalvik:修复 Dalvik.enumerateLoadedClasses()

4.3.7:

  • objc:新增 ObjC.Block,用于实现 block 并与之交互

尽情体验吧!

Frida 4.2 发布

Frida 的合作伙伴们最近在多条战线上持续攻坚,进展多到让我觉得值得写下这篇文章,把消息传出去。

在 Dalvik 方面,@marc1006 贡献了一项非常棒的新功能——对象挖掘,也就是扫描堆来查找某种类型的对象。看看这个:

const strings = [];
Dalvik.choose('java.lang.String', {
  onMatch(str) {
    strings.push(str);
  },
  onComplete() {
    console.log('Found ' + strings.length + ' strings!');
  }
});

与此同时,@Tyilo 也为 Objective-C 添加了同样的功能:

const strings = [];
ObjC.choose(ObjC.classes.NSString, {
  onMatch(str) {
    strings.push(str);
  },
  onComplete() {
    console.log('Found ' + strings.length + ' strings!');
  }
});

在移动平台的其他消息中,@pancake 添加了在 Firefox OS 上枚举应用的支持。太棒了!

在这些工作进行的同时,@s1341 一直在努力提升 QNX 移植版的稳定性,据报告,现在已经运行得非常好。

在我这边,我一直在 NowSecure 用 Frida 解决一些有趣的挑战,并在 Objective-C 集成中遇到了不少错误和限制。现在已支持重写处理按值传递结构体类型的方法,例如 -[UIView drawRect:],这意味着 NativeFunction 和 NativeCallback 也支持这些类型。要声明一个结构体,只需用一个数组开头,按顺序指定各字段的类型。你甚至可以嵌套它们。因此,对于 - drawRect: 这种按值传递结构体、而该结构体又由另外两个结构体组成的情况,可以这样声明:

const f = new NativeFunction(ptr('0x1234'), 'void',
    [[['double', 'double'], ['double', 'double']]]);

另一件值得一提的事是,一个尤其容易在对 32 位 iOS 应用进行插桩时显现、但影响所有平台的长期问题,终于得到了修复。

下面快速过一遍所有变更:

4.1.8:

  • core:添加在 Firefox OS 上枚举应用的支持
  • core:添加 NativePointer.toMatchPattern(),供 Memory.scan() 使用
  • core:修复 QNX 注入器竞态条件
  • objc:大幅改进类型处理
  • objc:修复从 JS 字符串到 NSString 的隐式转换
  • objc:修复注册第二个代理或未命名类时的崩溃
  • objc:新增 ObjC.Object 属性:$className 和 $super
  • dalvik:添加用于对象挖掘的 Dalvik.choose()

4.1.9:

  • core:NativeFunction 和 NativeCallback 现在支持按值传递结构体类型的函数
  • core:修复 Process.getModuleByName() 中意外的大小写敏感问题
  • dalvik:新增对象属性:$className

4.2.0:

  • core:向 Interceptor 的 onEnter 和 onLeave 回调添加 this.returnAddress
  • objc:添加用于对象挖掘的 ObjC.choose()

4.2.1:

  • core:修复 QNX 上枚举已剥离符号库的导出项
  • objc:新增 ObjC.Object 属性:$kind,其值为 instance、class 或 meta-class 之一
  • objc:修复 $class 属性,使其对类也能正确处理
  • objc:修复查找不存在的方法时的崩溃
  • python:确保反应器线程能平稳关闭
  • frida-discover:修复回归问题
  • frida-repl:修复评估表达式期间目标崩溃时的卡死

4.2.2:

  • core:修复异常处理中的怪异行为,该问题在 ios-arm 上非常明显
  • core:QNX 稳定性改进
  • objc:添加 ObjC.api,用于直接访问 Objective-C 运行时 API
  • objc:新增 ObjC.Object 属性:equals、$superClass 和 $methods
  • objc:修复 iOS 7 兼容性
  • objc:修复 ObjC.classes 和 ObjC.protocols 的 toJSON()
  • dalvik:修复 java.lang.CharSequence 的处理
  • frida-repl:添加 %time 命令,便于进行性能分析

4.2.3:

  • core:修复处理没有 message 对象的异常时的崩溃
  • core:修复 CpuContext JS 包装器的生命周期
  • core:向 Process.enumerateRanges() 公开文件映射信息
  • core:在枚举时支持合并相邻区间
  • core:添加用于查找模块和区间的便捷 API
  • core:让 QNX mprotect 在循环中读取,而不是只读一次
  • dalvik:类型转换失败时避免使进程崩溃
  • dalvik:允许使用 null 作为调用参数
  • objc:修复简单字段类型结构体的转换
  • objc:通过缓存包装对象加快隐式字符串转换

4.2.4:

  • objc:修复与尚未实现的类交互时的崩溃

4.2.5:

  • core:优化 Interceptor 回调逻辑,在未同时指定 onEnter 和 onLeave 时将速度提高一倍
  • core:修复 arm64 上调用上下文所见的返回地址
  • core:添加 arm64 模糊回溯器

4.2.6:

  • core:修复在 arm64 上访问第 4 至第 7 个参数的问题
  • core:添加 Memory.readFloat()、Memory.writeFloat()、Memory.readDouble() 和 Memory.writeDouble()
  • dalvik:改进类型检查
  • qnx:实现侧栈,以便用栈消耗很大的 V8 引擎调用 onEnter()/onLeave()

4.2.7:

  • core:Darwin 后端错误修复
  • core:优化 send() 数据载荷的处理
  • core:添加通过 task_for_pid(0) 与 iOS 内核交互的 API,仅在 attach(pid=0) 会话中可用
  • core:在 QNX 上为被替换函数添加侧栈支持
  • objc:向 ObjC.classes 添加 getOwnPropertyNames()
  • frida-repl:改进补全

4.2.8:

  • python:修复 Py3k 回归问题

4.2.9:

  • objc:向 ObjC.Object 添加 $ownMethods
  • dalvik:添加原始类型数组和对象数组支持
  • python:改进 Python 2 与 3 之间的兼容性
  • frida-repl:改进魔法命令

4.2.10:

  • core:修复 arm64 上 Interceptor 破坏向量寄存器的问题
  • core:改进 Android 上的临时目录处理

4.2.11:

  • dalvik:添加访问实例字段和静态字段的支持
  • dalvik:改进类型转换
  • python:在 Mac 上延迟解析 Python 运行时,使我们的二进制文件能适用于多种 Python 发行版
  • python:支持 pip

4.2.12:

  • python:修复 Py3k 回归问题

这次就这些。请在网络上分享这篇文章,帮助我们把消息传出去。作为一个开源项目,我们的规模仍然很小,所以口碑传播对我们意义重大。

祝使用愉快!

Frida 4.1 发布

又到了发布时刻。这一次,我们将 iOS 支持提升到新的层次,同时带来了一系列扎实的质量 改进。我也很高兴地宣布,最近我加入了 NowSecure; 这个版本如此出色绝非巧合。

先从一项全新的 iOS 功能说起。现在可以列出已安装的应用,frida-ps 能为你完成这件事:

$ frida-ps -U -a
  PID NAME        IDENTIFIER
10582 Facebook    com.facebook.Facebook
11066 IRCCloud    com.irccloud.IRCCloud
  451 Mail        com.apple.mobilemail
10339 Mailbox     com.orchestra.v2
 6866 Messages    com.apple.MobileSMS
10626 Messenger   com.facebook.Messenger
11043 Settings    com.apple.Preferences
10542 Skype       com.skype.skype
11218 Slack       com.tinyspeck.chatlyio
11052 Snapchat    com.toyopagroup.picaboo
$

加上 -i 选项后,它还会列出所有已安装的应用,而不只是当前正在运行的应用。

你选择的语言绑定也能使用此功能,例如 Python:

>>> import frida
>>> iphone = frida.get_usb_device()
>>> print("\n".join(map(repr, iphone.enumerate_applications())))
Application(identifier="com.google.ios.youtube", name="YouTube")
Application(identifier="com.toyopagroup.picaboo", name="Snapchat")
Application(identifier="com.skype.skype", name="Skype", pid=10542)
…
>>>

这很不错,但你是否还想在这些应用启动早期就进行插桩?现在也可以了,只需让我们启动 一个应用标识符:

$ frida-trace -U -f com.toyopagroup.picaboo -I "libcommonCrypto*"

或者在 API 层完成:

>>> import frida
>>> iphone = frida.get_usb_device()
>>> pid = iphone.spawn(["com.toyopagroup.picaboo"])
>>> snapchat = iphone.attach(pid)
>>> …apply instrumentation…
>>> iphone.resume(pid)

请注意,为了最大限度提高互操作性,启动早期阶段借助了 Cydia Substrate;毕竟多个 框架都向 launchd 注入代码、彼此发生冲突并不是好事。不过这是一个软依赖:如果在 未安装 Substrate 时尝试用应用标识符调用 spawn(),我们会抛出异常。

因此,在 iOS 应用启动早期进行插桩非常酷。但这些应用通常会大量使用 Objective-C API; 想对它们插桩时,我们经常不得不创建新的 Objective-C 类,以便建立插在应用与 API 之间 的 delegate。如果能用纯 JavaScript 创建这样的 Objective-C 类岂不更好?现在可以了:

const MyConnectionDelegateProxy = ObjC.registerClass({
  name: 'MyConnectionDelegateProxy',
  super: ObjC.classes.NSObject,
  protocols: [ObjC.protocols.NSURLConnectionDataDelegate],
  methods: {
    '- init': function () {
      const self = this.super.init();
      if (self !== null) {
        ObjC.bind(self, {
          foo: 1234
        });
      }
      return self;
    },
    '- dealloc': function () {
      ObjC.unbind(this.self);
      this.super.dealloc();
    },
    '- connection:didReceiveResponse:': function (conn, resp) {
      /* this.data.foo === 1234 */
    },
    /*
     * But those previous methods are declared assuming that
     * either the super-class or a protocol we conform to has
     * the same method so we can grab its type information.
     * However, if that's not the case, you would write it
     * like this:
     */
    '- connection:didReceiveResponse:': {
      retType: 'void',
      argTypes: ['object', 'object'],
      implementation(conn, resp) {
      }
    },
    /* Or grab it from an existing class: */
    '- connection:didReceiveResponse:': {
      types: ObjC.classes
          .Foo['- connection:didReceiveResponse:'].types,
      implementation(conn, resp) {
      }
    },
    /* Or from an existing protocol: */
    '- connection:didReceiveResponse:': {
      types: ObjC.protocols.NSURLConnectionDataDelegate
          .methods['- connection:didReceiveResponse:'].types,
      implementation(conn, resp) {
      }
    },
    /* Or write the signature by hand if you really want to: */
    '- connection:didReceiveResponse:': {
      types: 'v32@0:8@16@24',
      implementation(conn, resp) {
      }
    }
  }
});

const proxy = MyConnectionDelegateProxy.alloc().init();
/* use `proxy`, and later: */
proxy.release();

不过,大多数时候你会希望构建一个代理对象,把所有调用继续传递下去,只对真正关心的 少数方法记录日志。看看这个:

const MyConnectionDelegateProxy = ObjC.registerProxy({
  protocols: [ObjC.protocols.NSURLConnectionDataDelegate],
  methods: {
    '- connection:didReceiveResponse:': function (conn, resp) {
      /* fancy logging code here */
      /* this.data.foo === 1234 */
      this.data.target
          .connection_didReceiveResponse_(conn, resp);
    },
    '- connection:didReceiveData:': function (conn, data) {
      /* other logging code here */
      this.data.target
          .connection_didReceiveData_(conn, data);
    }
  },
  events: {
    forward(name) {
      console.log('*** forwarding: ' + name);
    }
  }
});

const method = ObjC.classes.NSURLConnection[
    '- initWithRequest:delegate:startImmediately:'];
Interceptor.attach(method.implementation, {
  onEnter(args) {
    args[3] = new MyConnectionDelegateProxy(args[3], {
      foo: 1234
    });
  }
});

Objective-C 部分就是这些。得益于 @marc1006, Dalvik 集成也获得了用于枚举已加载类的新 API;他还修复了静态方法处理,以及覆盖实现 无法返回布尔值的问题。

@Tyilo 也贡献了许多出色改进:增强 ObjC 集成、打磨 REPL、添加枚举 malloc 范围的 API,并为 NativePointer 添加一些便利 API。

与此同时,@s1341 一直努力将 Frida 移植到 QNX, 成果非常出色,目前已非常接近完美运行。

下面快速浏览其余变更:

4.0.1:

  • objc:支持更多类型
  • frida-trace:修复 ObjC 跟踪回归

4.0.2:

  • frida-node:修复 pixels 属性的编码

4.0.3:

  • frida-repl:修复 Windows 回归

4.0.5:

  • objc:支持更多类型并改进类型检查
  • objc:arm64 现在可正常工作
  • frida-repl:允许创建变量

4.0.6:

  • platform:支持向 send() 传递普通数据数组
  • arm:支持重定位 cbz/cbnz 指令

4.1.0:

  • platform:修复会写入 stdout 的子进程启动问题
  • platform:修复 NativeCallback 对 bool/int8/uint8 返回值的处理(此前这会 阻止 Dalvik 方法覆盖返回 false)
  • platform:允许 Memory.readByteArray() 使用小于 1 的长度
  • arm:支持重定位 ldrpc t2 指令
  • arm:改进重定向解析器
  • arm64:修复 adrp 指令重定位
  • arm64:支持重定位 PC 相对 ldr 指令
  • dalvik:添加 Dalvik.enumerateLoadedClasses()
  • dalvik:修复静态方法处理
  • python:修复 Windows 上的 console.log()
  • frida-repl:错误修复与改进
  • frida-trace:跟踪 ObjC 方法时支持 glob

4.1.1:

  • platform:为 enumerate_applications() 添加缺失的 pid 字段

4.1.2:

  • objc:类与代理创建 API
  • objc:新增用于枚举协议的 ObjC.protocols API

4.1.3:

  • platform:调用 NativeFunction 时释放 V8 锁,以改进并发能力
  • platform:添加 Process.getModuleByName(name)
  • platform:更快速、更稳健的 detach
  • python:提高 CLI 工具稳定性
  • frida-repl:以 prompt-toolkit 替换 readline

4.1.4:

  • platform:更快速、更稳健的 teardown
  • frida-server:收到 SIGINT 和 SIGTERM 时执行清理

4.1.5:

  • frida-ps:添加列出应用的支持

4.1.6:

  • platform:修复 Mac、iOS 和 Linux 上 spawn 时的崩溃
  • platform:添加 NativePointer.compare() 和 NativePointer.equals()
  • platform:添加 Process.enumerateMallocRanges{,Sync}()
  • frida-trace:停止操作从 Enter 改为 Ctrl+C
  • frida-trace:修复 iOS 应用启动
  • frida-repl:在自动补全中加入原型名称

4.1.7:

  • python:提高 CLI 工具稳定性

本次内容就是这些。请在网上分享这篇文章,帮助我们传播消息。作为一个开源项目, 我们的规模仍然很小,因此口耳相传对我们意义重大。

尽情享用吧!

Frida 4.0.0 发布

这是一次疯狂的发布,带来了大量改进。

先说一项面向用户的变化。名为 frida-repl 的 CLI 工具已更名为 frida,而且现在支持 Tab 补全!这项功能以及其他一些出色的 REPL 改进由 @fitblip 贡献。

现在还集成支持直接从 shell 启动脚本:

$ frida Calculator -l calc.js
    _____
   (_____)
    |   |    Frida 4.0.0 - A world-class dynamic
    |   |                  instrumentation framework
    |`-'|
    |   |    Commands:
    |   |        help      -> Displays the help system
    |   |        object?   -> Display information about 'object'
    |   |        exit/quit -> Exit
    |   |
    |   |    More info at https://frida.re/docs/home/
    `._.'

# The code in calc.js has now been loaded and executed
[Local::ProcName::Calculator]->
# Reload it from file at any time
[Local::ProcName::Calculator]-> %reload
[Local::ProcName::Calculator]->

或者,你可能已经厌倦了 console.log(),想在脚本中设置断点,以帮助理解正在发生什么? 现在可以了,因为 Frida 刚刚集成了兼容 Node.js 的调试器。

(此处应出现“Yo Dawg”梗图。)

没错,而且它确实非常实用。所有 CLI 工具都提供 --debug 开关来启用它:

# Connect Frida to a locally-running Calculator.app
# and load calc.js with the debugger enabled
$ frida Calculator -l calc.js --debug
    _____
   (_____)
    |   |    Frida 4.0.0 - A world-class dynamic
    |   |                  instrumentation framework
    |`-'|
    |   |    Commands:
    |   |        help      -> Displays the help system
    |   |        object?   -> Display information about 'object'
    |   |        exit/quit -> Exit
    |   |
    |   |    More info at https://frida.re/docs/home/
    `._.'

Debugger listening on port 5858
# We can now run node-inspector and start debugging calc.js
[Local::ProcName::Calculator]->

效果如下:

Frida 调试器会话

你是否曾想直接从 shell 使用 frida-trace 跟踪 Objective-C API?感谢 @Tyilo,现在可以了:

# Trace ObjC method calls in Safari
$ frida-trace -m '-[NSView drawRect:]' Safari

还有其他好东西,例如全新的回溯生成功能,以及使用调试符号对地址进行符号化:

const f = Module.getExportByName('libcommonCrypto.dylib',
    'CCCryptorCreate');
Interceptor.attach(f, {
    onEnter(args) {
        console.log('CCCryptorCreate called from:\n' +
            Thread.backtrace(this.context, Backtracer.ACCURATE)
            .map(DebugSymbol.fromAddress).join('\n') + '\n');
    }
});

又或者,你正在 Windows 上尝试找出谁访问了某些内存区域?那就看看全新的 MemoryAccessMonitor。严格来说,这段代码 并不是新的,只是直到现在才向 JavaScript API 公开。

另一项不错的功能是,从本次发布开始,在其他设备(例如 Android)上运行 frida-server 时,不再需要转发多个 TCP 端口。

错误反馈也得到了显著改善,现在会从远程进程一路传播到例如 Python 中不同的异常类型。 在上一个版本中,如果在 Mac 上附加到不存在的 pid,会得到:

SystemError: GDBus.Error:org.gtk.GDBus.UnmappedGError.Quark._g_2↩
dio_2derror_2dquark.Code0: task_for_pid() for remote pid failed w↩
hile trying to make pipe endpoints: (os/kern) failure (5)

太疯狂了。现在则简化为:

frida.ProcessNotFoundError: unable to find process with pid 1234

好多了。接下来谈谈性能。你可能使用过 frida-trace,并疑惑它为什么在“Resolving functions…”上花费这么长时间。在典型 iOS 应用中,只解析一个函数通常就要约 8 秒, 现在降到了约 1 秒。虽然还有一些优化空间,但我很快意识到,无论函数导出枚举得多快, 数据仍需要传输,而仅传输时间本身就可能令人难以接受。解决办法是什么?把逻辑移到目标 进程中,传输逻辑而不是数据。很简单。 Dalvik 和 ObjC 接口也经过优化,耗时从数秒降至数毫秒。简而言之,我们进一步推迟了查询 语言运行时的时机。ObjC 接口在这方面走得很远,现在使用 ES6 代理来提供更符合习惯、效率 更高的 API。

这就引出了下一个话题。ObjC 接口有一些变化。主要是:

const NSString = ObjC.use("NSString");

现在改为:

const NSString = ObjC.classes.NSString;

你仍可使用 ObjC.classes 枚举当前已加载的类,但它现在的行为类似一个对象,将类名映射到 JavaScript ObjC 绑定。

此外,不再需要类型转换,因此不再这样写:

const NSSound = ObjC.use('NSSound');
const sound = ObjC.cast(ptr("0x1234"), NSSound);

只需这样写:

const sound = new ObjC.Object(ptr("0x1234"));

没错,不再需要试图模拟 ObjC 类层次结构。现在使用完全动态的包装器,首次访问时才构建 方法包装器;只有尝试枚举对象属性时,才会获取方法列表。

这篇文章已经很长了,下面汇总其他主要变化:

  • Dalvik 接口现在可以处理可变参数方法。感谢 @dmchell 报告并协助追踪此问题。
  • 感谢 @Tyilo,NativePointer 现在还提供 .and()、 .or() 和 .xor()。
  • Interceptor 的 onEnter/onLeave 回调过去通过 this.registers 公开 CPU 寄存器, 现已更名为 this.context,而且现在也允许写入寄存器。
  • 为保持一致,Process.enumerateThreads() 返回的线程对象已将 CPU 上下文字段从 registers 更名为 context。
  • enumerateFoo() API 现在提供同步版本 enumerateFooSync(),直接返回包含所有项目的数组。
  • 现在可使用 Memory.readCString() 读取 ASCII C 字符串。
  • 可以查询 Frida.version 来检查正在运行的版本;frida-core 端也提供该信息,例如 frida-python 通过 frida.__version__ 将其公开。
  • Stalker 现在支持 jecxz 和 jrcxz 指令。这对 CryptoShark 是个好消息,它应该很快就会提供 捆绑最新版 Frida 的更新二进制文件。
  • V8 已更新到 4.3.62,并启用了许多 ES6 功能。
  • 现在使用即将发布的 Capstone 4.0 的开发版本。
  • 所有第三方依赖都已更新到最新版本。
  • 现在支持 Windows XP。这不是玩笑。我意识到我们其实没有使用任何 XP 之后才提供的 API; 既然必须在 Windows 上重新构建依赖,不妨降低操作系统要求,帮助仍在 XP 上对软件进行 插桩的用户。

尽情使用吧!

Frida 3.0.0 发布

你可能曾经疑惑:

为什么 API 是 Python,调试逻辑却是 JavaScript?

现在你可以这样做:

$ npm install frida

我们刚刚为你带来了全新的 Node.js 绑定, 而且它是完全异步的:

请查看这些示例, 了解 API 的大致样貌。它基本上是 Python 绑定所提供 API 的一对一映射,但遵循 Node.js / JavaScript 约定,例如方法名使用驼峰式命名、方法返回 ES6 Promise 对象而不是阻塞,等等。

现在,将它与 NW.js 结合起来,你就可以完全使用 HTML、CSS 和 JavaScript 构建自己的桌面应用。

所以,我们有了全新的 Node.js 绑定;太棒了!不过,我们并没有就此止步。 但首先谈谈未来。我很高兴地宣布,我刚刚创办了一家公司,目标是资助 Frida 的兼职开发。 通过提供逆向工程和软件开发方面的专业服务,希望能产生足够的收入来支付我的生活开销, 并留出一些时间投入 Frida。从长期来看,我也希望市场会有这样的需求:帮助添加功能, 或将 Frida 集成到第三方产品中。不过眼下,如果你知道有人正在寻找逆向工程或软件开发方面的专家, 若能向他们推荐我并请他们与我联系,我将不胜感激。详细信息请参阅我的简历。

先说到这里,让我们回到本次发布。接下来是:支持 32 位 Linux!甚至 Stalker 也已经完成移植。 不止如此,Linux 后端甚至可以像其他平台一样进行跨架构注入。这意味着 64 位 Frida 进程, 例如你的 Python 解释器,可以注入 32 位进程。反过来也同样可行。

另一项很棒的更新是,Tyilo 为 frida-trace 贡献了改进, 使它现在能使用 man 手册页自动生成日志处理程序。很棒,对吧?不过还有更多好东西:

  • frida-server 端口现在会被重复使用。因此,如果你在 Android 上使用 Frida, 除非确实要同时附加到多个进程,否则无需不断转发端口。
  • 改进 Linux 和 Android 的 spawn() 支持,现在也支持 PIE 二进制文件。
  • 改进 Android 的稳定性和兼容性。
  • 全面改造 Mac 和 Linux 构建系统,让你可以轻松地只构建自己关心的部分; 甚至还能构建一些你可能不知道其存在、以前默认不会构建的组件。
  • Python 绑定做了一项小幅简化:不再需要写 frida.attach(pid).session.create_script(), 只需写 frida.attach(pid).create_script()。这与全新的 Node.js 绑定一致, 也是我们必须提升主版本号的原因。

大致就是这些了。请在互联网上分享这篇文章,帮忙让更多人知道 Frida。 作为一个开源项目,我们的规模仍然很小,因此口碑传播对我们意义重大。

尽情享用吧!

Frida 2.0.2 发布

感谢大家提供的出色反馈,我们刚刚解决了一个崩溃问题:在 Windows 上使用 Frida, 并搭配某些 iOS 设备配置时会触发该问题。由于这是一个非常重要的使用场景,我们决定 发布一个热修复版本,不包含其他变更。

请继续提交错误报告!

Frida 2.0.1 发布

这是一次快速的错误修复版本,用于解决 2.0.0 最终测试中漏掉的一个 iOS 问题。祝使用愉快!

Frida 2.0.0 发布

又到了发布激动人心的新版本的时候!主要变化包括:

  • Mac 和 iOS 上不再发生内核崩溃!请在这里阅读完整故事。
  • Mac 和 iOS 注入器会手动映射 Frida 的 dylib。这意味着我们可以附加到受到严格沙箱限制的进程。
  • frida-trace、frida-repl 等 CLI 工具现在全新支持启动进程:
$ frida-trace -i 'open*' -i 'read*' /bin/cat /etc/resolv.conf
    27 ms	open$NOCANCEL()
    28 ms	read$NOCANCEL()
    28 ms	read$NOCANCEL()
    28 ms	read$NOCANCEL()
Target process terminated.
Stopping...
$
  • 改进 frida-repl 和 frida-discover 的易用性。
  • 首次调用 DeviceManager.enumerate_devices() 时表现更好,还会返回当前已连接的 iOS 设备;因此,对于需要设备已经存在的简单应用或脚本,不再需要订阅更新。
  • Python API 现在提供 frida.get_usb_device(timeout = 0) 和 frida.get_remote_device(),便于访问 iOS 设备以及远程/Android 设备。
  • 传给 Interceptor.attach() 的 onEnter 和 onLeave 回调可以访问 this.registers 来检查 CPU 寄存器,这在处理自定义调用约定时非常有用。
  • console.log() 现在会把日志写入应用端的控制台,而不是目标进程。实际上,正是这项变化促使我们提升了本次发布的主版本号。
  • 兼容 Android 5.0,但 ART 支持除外。
  • 全新支持 Android/x86。除了 Dalvik 集成之外,一切功能都可以正常工作;如果你愿意通过 pull request 帮忙修复,请联系我们!

想参与贡献吗?请查看我们的 GSoC 2015 构想页面,了解我们下一步希望前往的方向。

尽情使用吧!

凌晨 2 点更新: 最终测试遗漏了一个 iOS 问题,因此我们刚刚发布 2.0.1 来修复它。

晚上 11 点更新: 感谢大家提供的优秀反馈,我们发现了一个严重错误:在某些 iOS 设备配置下于 Windows 上使用 Frida 时会触发该问题。请升级到 2.0.2;如果遇到任何问题,请告诉我们。

Frida 1.8.0 发布

此版本在 iOS 上引入了严重回归,因此很快从 Cydia 仓库中撤下;不过在等待 2.0.0 取代它期间,Mac、Linux 和 Android 版本仍然可用。

Frida 1.6.8 发布

这只是一个小型错误修复版本,修复了 Mac 上的 spawn(),并解决了一些拆除阶段的问题。尽情享用!

Frida 1.6.7 发布

是否厌倦了等待 Frida 在 64 位 Mac 或 iOS 系统上附加到 32 位进程?或者 frida-trace 解析函数要花很长时间?无论上述情况是否与你有关,这个版本都适合你!

在 Mac/iOS 主机上附加 32 位进程的过程已经优化,从原先的数秒缩短到现在的数毫秒。不过这项改进仅适用于 Darwin 操作系统;本版本还加快了所有操作系统上的模块导出枚举,速度提升 75%。使用 frida-trace 并等待它解析函数时,改善应该非常明显。

额外的好消息是,在同时附加多个进程时执行清理不再导致 Darwin 和 Linux 崩溃。

祝使用愉快!

Frida 1.6.5 发布

又到发布时刻,来修复一些错误:

  • 现在支持 iOS 8.1,ARM64 支持也比以往更好。
  • iOS USB 传输在向设备突发发送数据时不再断开。这通常发生在使用 frida-trace 跟踪大量函数时,因为此时会在线路上突发发送数据。实际上,这是一个影响 Mac 和 iOS 的通用网络问题,但在 Frida 配合有线连接的 iOS 设备使用时极易复现。
  • 消除了 Python 解释器关闭时的崩溃。
  • frida-trace 脚本中的 onEnter 和 onLeave 回调现在会以绑定到正确对象的 this 调用。也就是说,它绑定到该线程和本次调用专属的对象,而不是所有线程和调用共享的对象。

Frida 1.6.4 发布

又到错误修复版本的时间了!

Stalker 改进:

  • 引擎不再为每个被跟踪线程预分配固定的 256 MB 内存块,而是以重入安全的方式动态增长。
  • 消除了缓存查找逻辑中一个会使某些块永远缓存未命中的错误。这些块因此在 每次即将执行时都会重新编译,拖慢执行、让缓存不断堆积条目,最终耗尽内存。
  • 现在能正确处理 RIP 相对 cmpxchg 指令的重定位。

改进 Dalvik 集成(Android):

  • 现在可以加载应用自己的类。
  • 修复了多个编组错误。

脚本运行时:

  • 多个指向同一目标地址的 NativeFunction 不再导致释放后使用。

另外,CryptoShark 0.1.2 也已发布, 它升级了 Frida 引擎并带来大量性能改进,让 GUI 能够跟上 Stalker。趁热赶快下载吧!

Frida 1.6.3 发布

这个最新版本包含大量增强和错误修复。 其中一些亮点如下:

  • Frida 内部的其余部分已从 udis86 迁移到 Capstone,这意味着 Stalker 现在能够跟踪使用很新 x86 指令的二进制文件。这项工作还包括在 Windows 和 Mac 的 32 位与 64 位二进制文件上进行实战检验,目前所有已知问题都已解决。

  • JavaScript API 新增了 Memory.protect(),让你可以轻松更改页面保护。例如:

Memory.protect(ptr("0x1234"), 4096, 'rw-');
  • Process.enumerateThreads() 会省略 Frida 自己的线程,因此你无需担心它们。

  • Python 3 二进制文件现在基于 Python 3.4 构建。

这个版本发布之后,让我们来聊聊 CryptoShark:

可以在这里获取预构建的 Windows 二进制文件, 如果想在 Mac 或 Linux 上试用,也可以从源码构建。

祝你使用愉快!

Frida 1.6.2 发布

又到发布时间,这次带来的可不只是错误修复。请认识 Instruction.parse():

const a = Instruction.parse(ptr('0x1234'));
const b = Instruction.parse(a.next);
console.log(a);
console.log(b);

输出:

push rbp
mov rbp, rsp

你问这是怎么实现的?这正是最酷的部分。Frida 底层已经在使用优秀的 Capstone 反汇编框架,因此将它提供给 JavaScript 运行时非常合理。所有详细信息请查看 JavaScript API 参考。

尽情享用!

Frida 1.6.1 发布

是时候发布一个错误修复版本了。主要改进如下:

  • 兼容 ARM64 上的盘古 iOS 越狱。问题在于,RWX 页面不像使用 evad3rs 越狱时那样可用。
  • 修复分离时目标进程偶发崩溃的问题。
  • 修复首次建立连接失败后,第二次尝试附加到进程时发生的崩溃。该问题主要影响 Android 用户, 但在任何操作系统上使用 frida-server 时都可能发生。
  • 在 Linux/x86-64 和 Android/ARM 上实现更快、更可靠的注入。
  • 修复在 Windows 上无法挂钩 HeapFree 及相关函数的问题。
  • 升级 GLib、libgee、json-glib 和 Vala 依赖项,以提高性能并修复错误。
  • 不再发生资源泄漏。如果你发现任何泄漏,请报告给我们。

此外,正如我的博客文章所介绍的,从 1.6.0 开始新增了一套功能完整的 Qml 绑定。 对于正在构建图形化跨平台工具的用户来说,它应该很有吸引力。

Frida 1.6.0 发布

有些人可能已经注意到,Frida 最近新增了 Android 支持,让你能像在 Windows、Mac、Linux 和 iOS 上一样轻松地对代码插桩。这听起来很酷,但 Android 会运行大量 Java 代码,这意味着你只能观察这些代码产生的原生层副作用。当然,你可以使用 Frida 的 FFI API 自己进入虚拟机,但这些繁琐工作难道不该由 Frida 代劳吗?当然应该!

实际效果如下:

Dalvik.perform(() => {
    const Activity = Dalvik.use('android.app.Activity');
    Activity.onResume.implementation = function () {
        send('onResume() got called! Let's call the original implementation');
        this.onResume();
    };
});

Dalvik.perform() 会负责把线程附加到虚拟机;在来自 Java 的回调中则无需调用它。第一次以某个类名调用 Dalvik.use() 时,Frida 会查询虚拟机并即时构建 JavaScript 包装器。上例取得 Activity 类,用我们自己的版本替换其 onResume 实现,向运行在 Windows、Mac 或 Linux 计算机上的调试器发送消息后,再调用原始实现。你也可以完全不调用原始实现,而是模拟其行为;或者模拟错误场景:

Dalvik.perform(() => {
    const Activity = Dalvik.use('android.app.Activity');
    const Exception = Dalvik.use('java.lang.Exception');
    Activity.onResume.implementation = function () {
        throw Exception.$new('Oh noes!');
    };
});

这样,你就实例化了一个 Java Exception,并直接从 Activity.onResume 的 JavaScript 实现中将其抛出。

此版本还带来了一些运行时增强:

  • Memory.copy(dst, src, n):与 memcpy 相同
  • Memory.dup(mem, size):依次调用 Memory.alloc() 和 Memory.copy() 的简写
  • Memory.writeXXX():补齐与 Memory.read() 对应的方法:S8、S16、U16、S32、U32、S64、U64、ByteArray、Utf16String 和 AnsiString
  • Process.pointerSize:让脚本更具可移植性
  • NativePointer 实例现在提供方便的 isNull() 方法
  • NULL 常量:无需到处写 ptr("0")
  • 面向高级用户的 WeakRef.bind(value, fn) 和 WeakRef.unbind(id):前者监视 value,在 value 被垃圾回收或脚本即将卸载时调用 fn,并返回一个 ID,可将其传给 unbind() 进行显式清理。构建语言绑定时,这个 API 很有用,因为 JS 值不再需要后,必须释放原生资源。

尽情体验吧!

Frida 1.4.2 发布

这是一次快速的错误修复版本,用于消灭这个恼人的错误。该错误可在所有受支持的 x86 操作系统上复现。感谢 Guillaume 追踪并定位此问题。

此外,frida-repl 现在也能在 Windows 上运行了。祝 REPL 愉快!

Frida 1.4.1 发布

想在 Windows 或 Linux 上启动进程,而不只是 Mac?或者你遇到过 Linux 注入器 让进程崩溃,而不是让你成功注入?又或者,某个函数名太长,导致 frida-trace 在 Windows 上超出最大文件名长度?好吧,无论上述情况你遇到了全部、一部分,还是一个都没有, Frida 1.4.1 都是为你准备的!

感谢 Guillaume 和 Pedro 让此版本变得如此出色。欢迎继续提交 pull request 和错误报告!

Frida 1.4.0 发布

有人提到 Android 吗?Frida 1.4.0 已经发布,并带来全新的 Android 支持! 请查看这里的文档开始使用。此版本的另一项新变化是, Frida 现在由出色的 Capstone 反汇编引擎驱动, 这意味着我们的跨平台代码插桩能力更加强大。它也为在未来版本中把仅限 x86 的 隐蔽跟踪 带到新架构铺平了道路。

祝你使用愉快!

Frida 1.2.1 发布

在跟踪 Apple 的密码学 API 时玩得很开心,也因此发现了几个错误。于是 1.2.1 带来了一些关键的 ARM 相关修复:

  • ARM32:修复 ARM32 上 V8 因寄存器被破坏而崩溃的问题;其原因是 Apple ABI 与 AAPCS 对 r9 的规定不同。
  • ARM32:修复 ARM32/Thumb 重定位器对立即数同模式分支的分支重写。
  • ARM64:改进 ARM64 重定位器,使其支持重写 b 和 bl。

Frida 1.2.0 发布

又到发布时间,Frida 1.2.0 终于出炉了!除了错误修复,此版本还带来全新的 ARM64 支持,对在 iPhone 5S 或 iPad Air 上使用 Frida 的读者非常实用。 现在你可以像在 Mac 和 Windows 上一样,同时注入 64 位和 32 位进程。

此版本还改善了 ARM32 上的稳定性:过去附加到短函数会导致未定义行为。

尽情享用!

Frida 1.0.11 发布

有些用户在 Windows 上向进程注入时遇到了问题,iOS 上也出现过崩溃。这个新版本为 Frida 内部实现带来了一些重大改进:

  • V8 已升级到 3.25,以修复 iOS 稳定性问题。这还意味着所有平台都能获得新功能(如 ECMAScript 6)和性能改进。另一个好处是,Frida 现在依赖的 V8 版本可在 64 位 ARM 上运行,为将 Frida 本身移植到 AArch64 铺平了道路。
  • Windows 注入器学会了一些新技巧,能够进入更多进程。Windows 构建系统中还发现了一个配置错误,这解释了为什么有些用户无法向某些进程注入。
  • 对于在 Windows 上构建 Frida 的用户,构建系统现在依赖 VS2013。这意味着不再支持 XP,但如果仍有用户依赖 XP,还是可以使用 v120_xp 工具链进行构建。如果这会让你无法继续使用,请告诉我。
  • 最近添加的 this.lastError(Windows)支持现在已能正确工作。

这次就这些。请告诉我们你的想法;如果你喜欢 Frida,请帮助我们把它传播出去!:)

Frida 1.0.10 发布

此版本带来了几项改进:

  • Interceptor 现在与 iOS/ARM 上更多的函数兼容。
  • 新的 CLI 工具 frida-repl 提供一个基础 REPL,便于你从目标进程内部 试验 JavaScript API。
  • 传给 Interceptor.attach() 的 onLeave 回调现可通过调用 retval.replace() 替换返回值。
  • 传给 Interceptor.attach() 的 onEnter 和 onLeave 回调都可以访问 this.errno(UNIX)或 this.lastError(Windows),以检查或操作当前线程 最后一个系统错误。

下面演示如何组合后三项功能,为 Mac 上运行的特定进程模拟网络状况:

~ $ frida-repl TargetApp

然后粘贴:

callbacks = { \
    onEnter(args) { \
        args[0] = ptr(-1); // Avoid side-effects on socket \
    }, \
    onLeave(retval) { \
        const ECONNREFUSED = 61; \
        this.errno = ECONNREFUSED; \
        retval.replace(-1); \
    } \
}; \
Module.enumerateExports("libsystem_kernel.dylib", { \
    onMatch(exp) { \
        if (exp.name.indexOf("connect") === 0 && exp.name.indexOf("connectx") !== 0) { \
            Interceptor.attach(exp.address, callbacks); \
        } \
    }, \
    onComplete() {} \
});

尽情享用!

Frida 1.0.9 发布

又一个新版本——这次带来了一些新功能:

  • 支持 Mac 和 iOS 上的 Objective-C 集成。先看一个小例子吊吊胃口:
const UIAlertView = ObjC.use('UIAlertView'); /* iOS */
ObjC.schedule(ObjC.mainQueue, () => {
    const view = UIAlertView.alloc().initWithTitle_message_delegate_cancelButtonTitle_otherButtonTitles_(
        "Frida",
        "Hello from Frida",
        ptr("0"),
        "OK",
        ptr("0"));
    view.show();
    view.release();
});
  • Module.enumerateExports() 现在不仅枚举导出函数,也会枚举导出变量。 onMatch 回调会收到一个 exp 对象,其 type 字段为 function 或 variable。
要完整了解 ObjC 集成,请查看 JavaScript API 参考。

Frida 1.0.8 发布

我们刚刚发布了一个错误修复版本:

  • 支持注入 Mac App Store 应用
  • 消除 iOS 守护进程自动启动问题
  • 注入后不久不再发生 iOS 崩溃

Frida 1.0.7 发布

此版本为命令行工具带来了 USB 设备支持,并新增 frida-ps,用于枚举本地和远程进程。

例如,枚举通过数据线连接的 iOS 设备上的进程:

$ frida-ps -U

frida-trace 和 frida-discover 也接受 -U 选项。

网站很快会加入如何在 iOS 设备上进行配置的文档。

不过,这还不是最令人兴奋的部分。从这个版本开始,Frida 收到了自 HN 发布以来的首次社区贡献。Pete Morici 深入项目,为 frida-trace 加入了按模块相对地址指定函数的支持:

$ frida-trace -a 'kernel32.dll+0x1234'

尽情体验吧!

Frida 1.0.6 发布

此版本简化了许可证,并修复了自 HN 发布以来社区报告的错误。

主要包括:

  • 将剩余采用 GPLv3+ 的 Frida 组件重新许可为 LGPLv2.1+(与 frida-gum 相同)。
  • Tracer 现可在 64 位环境中处理高地址区间的函数地址。
  • Linux 构建现会链接 Frida 自带的库,而不是构建机上的对应库。

Frida 1.0.5 发布

此版本改进了 frida-trace,支持根据文件系统中的脚本自动生成、加载和重新加载函数处理程序。请查看我们的快速入门指南,了解完整操作过程。本版本还新增了 Py3k 支持,可从所有平台上的 PyPI 获取。