 oleavr
从 Frida 诞生以来,处理结构体一直是它的薄弱环节之一。假设你在游戏中找到了一个 Player 结构体,并想读取它的 lives 字段,最终往往会写出这样的代码:
const lives = player.add(4).readU32();那个神秘的 4 是你手工算出的偏移量,readU32() 也是你手工确定的类型;除了这一行, 这些信息没有记录在任何地方。把这种情况乘以你关心的每个结构体中的每个字段,最后得到的 脚本既脆弱又难读,结构布局也几乎无法与别人共享。如果结构体在 32 位和 64 位环境中的 布局不同,你还得维护两套偏移量。
这些年来我一直在思考这个问题。我真正想要的是一种类型安全的方法,让 TypeScript 编译器知道有哪些字段以及它们各自的类型,从而在编译时发现拼写错误,并让编辑器自动补全 字段名。这显然需要一个代码生成步骤,而我始终觉得让用户承担这一步的成本太高。
后来 Frida.Compiler 出现了。它并非从一开始就存在,但如今已经为 frida-compile、REPL 以及 Luma 等工具提供支持,代码生成步骤可以完全隐藏起来。这正是本次发布的主题。
模式
我们没有再发明一种结构体描述语言,而是采用了 ImHex 的模式语言。 这是一种用于描述二进制数据的类 C 语言,最初为 ImHex 的十六进制编辑器而创建,支持 结构体、联合体、枚举、位域、指针、条件、动态长度数组以及标准库。ImHex-Patterns 仓库收录了大量常见文件格式的模式,此后这门语言也被其他工具采用:x64dbg 通过 DataExplorer 插件提供支持,radare2 则通过 r2hexpat 提供支持。因此,你很可能 能找到可直接复用的现有模式;为 Frida 编写的模式也同样能用于这些工具。
Frida 17.20.0 使用 Go 在 Frida.Compiler 中实现了这门语言,与 TypeScript 编译器并列。 下面来试试看。这是 game.hexpat:
#pragma abi native

struct Player {
    u32 health;
    u32 lives;
    Role role;
    Vec3 position;
    Player* next;
};

struct Vec3 {
    float x;
    float y;
    float z;
};

enum Role : u8 {
    Warrior,
    Mage,
    Rogue,
};
如果你写过 C 结构体,就已经知道该如何阅读它。唯一显眼的是 #pragma abi native,稍后我们会回到这一点。
随后在 agent.ts 中像导入其他模块一样导入该模式:
import { Player, Role } from "./game.hexpat";

const roster = Memory.alloc(Player.size * 3);

const alice = Player.at(roster);
alice.health = 100;
alice.lives = 3;
alice.role = Role.Mage;
alice.position.x = 1.5;
alice.position.y = -2;
alice.position.z = 3;

const bob = Player.at(roster.add(Player.size));
bob.health = 42;
bob.lives = 1;
bob.role = Role.Warrior;
alice.next = bob;

const carol = Player.at(roster.add(Player.size * 2));
carol.health = 100;
carol.lives = 3;
carol.role = Role.Rogue;
bob.next = carol;

console.log("Player.size:", Player.size);
console.log(JSON.stringify(alice, null, 2));
console.log("alice.next.next.role:", Role[alice.next!.next!.role]);
在真实场景中,这些结构体显然由游戏自身持有,我们会通过 Interceptor、内存扫描或类似 方式找到它们。为了让示例自包含,这里由我们自己分配三个实例。
运行它:
$ frida -q -p 0 -l agent.ts
Compiling agent.ts...
Compiled agent.ts (20 ms)
Player.size: 32
{
  "health": 100,
  "lives": 3,
  "role": 1,
  "position": {
    "x": 1.5,
    "y": -2,
    "z": 3
  },
  "next": "0x140cb5bc0"
}
alice.next.next.role: Rogue
这里有几点值得注意:
- 每个结构体都会变成一个类。Player.at(address) 提供该地址处内存的实时视图, 每个属性都直接读写底层内存。不会复制任何内容,因此你看到的始终是内存中的当前值。
- position 这样的嵌套结构体同样是视图;next 这样的指针字段会提供其所指对象的 视图,或返回 null。给指针字段赋值时,可以传入视图或 NativePointer。
- 枚举会变成带反向映射的对象,因此 Role[alice.role] 会得到 “Mage”。
- Player.size 是结构体的字节大小,JSON.stringify() 也可直接使用。
- 没有任何内容经过预编译。REPL 将 agent.ts 交给 Frida.Compiler;后者发现 .hexpat 导入后,把模式编译为 JavaScript,并与 agent 一起打包。运行 frida-compile agent.ts -o _agent.js 时也会执行同样的流程,生成的包是自包含的, 可由我们的任意语言绑定加载。
原生布局
由于模式语言是为文件格式设计的,ImHex 会以紧凑方式布局结构体,字段之间没有填充, 因为文件格式通常就是这样。另一方面,Frida 还需要处理由 C 编译器布局的内存中结构体, 而这类结构体会按自然对齐方式填充。这就是 #pragma abi native 的用途。它只存在于 Frida 的语言方言中,用来告诉编译器按照目标平台 C 编译器的方式布局结构体。在上面的 示例中,role 占一个字节,随后有三个填充字节,使 position 达到 4 字节对齐; 在 64 位进程中,next 则达到 8 字节对齐。因此 Player.size 是 32 而不是 25。 省略该 pragma 后会得到 ImHex 的紧凑布局,这正是解码恰好映射到内存中的文件格式时 所需要的布局。
生成的 JavaScript 也会考虑目标平台的 ABI。next 等指针字段在 64 位进程中占 8 字节, 在 32 位进程中占 4 字节,这会改变其后所有字段的偏移量;而且 32 位 Windows 与 32 位 Linux 等平台的对齐规则也不同。Frida.Compiler 会在编译时计算所有这些布局, 生成的代码则根据最终运行所在的进程在运行时选择正确布局。因此,一个编译后的 agent 就能支持 Frida 支持的任意目标,无需维护各架构专用的偏移量。
类型安全
这是最令我兴奋的部分。Frida.Compiler 加载 .hexpat 时,还会为它生成 TypeScript 声明,并以 game.hexpat.d.ts 的形式写在模式文件旁边:
export declare class Player {
    constructor(address: NativePointer);
    static at(address: NativePointer): Player;
    static readonly size: number;
    static pattern(fields: Player.Fields): string;
    static parse(address: NativePointer, size?: number): Player.Parsed;
    readonly $address: NativePointer;
    readonly $size: number;
    health: number;
    lives: number;
    role: Role;
    readonly position: Vec3;
    get next(): Player | null;
    set next(value: Player | NativePointer | null);
    toJSON(): Player.Values;
}
这意味着 TypeScript 编译器能准确知道有哪些字段以及它们的类型。拼错字段名会得到编译 错误,编辑器也能自动补全字段名。在结构体中加入 char name[16] 后,它会显示为只读 string;如果尝试给它赋值,编译器会发出提示。(我写这篇文章时就被提示过。)模式本身 的错误也会像 TypeScript 错误一样,连同文件和行号一起报告:
$ frida-compile agent.ts -o _agent.js
game.hexpat:5:5 - error TS-1: unknown type Badge
compilation failed
你可能需要将 *.hexpat.d.ts 加入 .gitignore,因为每次构建都会重新生成这些文件。
扫描
现在来看让这一切如同魔法的部分。假设我们要寻找一个生命值全满且有三条命的 Player, 但完全不知道它位于内存中的什么位置。每个生成的类都有一个静态 pattern() 方法, 它接收字段的一个子集,并为 Memory.scan() 生成匹配模式;省略的字段会变成通配符:
const pattern = Player.pattern({ health: 100, lives: 3 });
console.log("pattern:", pattern);

for (const { address } of Memory.scanSync(roster, Player.size * 3, pattern)) {
  const p = Player.at(address);
  console.log(`${address}: ${Role[p.role]} with ${p.lives} lives`);
}
结果如下:
pattern: 64 00 00 00 03 00 00 00 ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ?? ??
0x140cb5ba0: Mage with 3 lives
0x140cb5be0: Rogue with 3 lives
字节序、字段偏移量和填充都已自动处理。在真实游戏中,你会扫描 Process.enumerateRanges(‘rw-‘) 返回的堆范围,而不是这个小小的 roster;还可以加入 枚举值或嵌套字段来缩小范围,例如 Player.pattern({ role: Role.Rogue, position: { z: 3 } })。
超越视图
实时视图覆盖纯数据结构体,而进程内部遇到的大多数结构体都属于这一类。但模式语言还能 做到更多:由前置字段决定长度的数组、条件、具有自定义基址的指针、局部变量、函数、 [[format]] 和 [[color]] 等属性、std 库等等。对于这些功能,可以使用 parse(), 它以完整的 ImHex 语义解码内存快照。下面用 macOS 和 iOS 上每个进程都有的内容来试验: 主可执行文件的 Mach-O 头。将以下内容写入 macho.hexpat:
#pragma endian little

struct MachO {
    MachHeader header;
    LoadCommand commands[header.ncmds];
};

struct MachHeader {
    u32 magic [[color("FF8800")]];
    CpuType cputype;
    u32 cpusubtype;
    FileType filetype;
    u32 ncmds;
    u32 sizeofcmds;
    u32 flags;
    u32 reserved;
};

struct LoadCommand {
    u32 cmd;
    u32 cmdsize;
    u8 payload[cmdsize - 8] [[sealed]];
};

enum CpuType : u32 {
    X86_64 = 0x01000007,
    ARM64 = 0x0100000C,
};

enum FileType : u32 {
    Object = 1,
    Execute = 2,
    Dylib = 6,
};

MachO macho @ 0x00;
请注意,这里没有 #pragma abi native,因为这是文件格式。还要注意末尾的 placement, ImHex 模式通常用这种方式声明文件开头的内容。在本例中,“文件”是一段内存,而带有 placement 的模式会为我们提供一个用于解码它们的 parse() 导出:
import { parse, MachHeader, CpuType, FileType } from "./macho.hexpat";

const base = Process.mainModule.base;

const header = MachHeader.at(base);
console.log("magic:", header.magic.toString(16), CpuType[header.cputype],
    FileType[header.filetype]);
console.log("ncmds:", header.ncmds);

const image = parse(base, 4096).macho;
console.log("commands:", image.commands.length);
for (const cmd of image.commands.slice(0, 3)) {
  console.log(`  cmd=0x${cmd.cmd.toString(16)} cmdsize=${cmd.cmdsize}`,
      `@ ${cmd.$address}`);
}
$ frida -q -p 0 -l macho.ts
Compiling macho.ts...
Compiled macho.ts (19 ms)
magic: feedfacf ARM64 Execute
ncmds: 20
commands: 20
cmd=0x19 cmdsize=72 @ 0x102a64020
cmd=0x19 cmdsize=312 @ 0x102a64068
cmd=0x19 cmdsize=152 @ 0x102a641a0parse() 的第二个参数限制它最多可以读取多少内存。当模式中数组的长度取决于尚未完全 信任的数据时,这样做很有必要。结果是一棵普通值组成的树,每个结构体都带有 $address 和 $size,因此可以知道每部分来自哪里。由于该结构体是纯数据, MachHeader.at() 仍可同时作为实时视图使用。
模式可以导入其他模式。导入项会先相对于发起导入的文件解析,再从 node_modules 解析,因此模式可以作为 npm 包发布。std 库已内置,所以 import std.mem; 可直接使用。 我们的测试套件会运行 ImHex-Patterns 语料库,其中 312 个模式有 303 个无需修改即可编译; 其余模式要么依赖 ImHex 本身,要么在那里也会失败。可视化器(即 hex::visualize())由接下来介绍的宿主端 API 求值,在 agent 内部则会被忽略。
PatternCompiler
Frida.Compiler 负责处理 agent,但构建在 Frida 之上的工具通常希望在宿主端解码内存, 而不向目标注入任何模式代码。为此,frida-core 新增了 PatternCompiler API,自动生成的 frida-python、frida-node 和 frida-swift 等绑定会自动获得它。你向它提供模式源代码, 它会返回一个 PatternModule:该模块描述模式声明的类型,并能按照其中任意类型解码 一段字节。下面从 Python 使用它,解码前面查看过的同一个 Mach-O 头:
from pathlib import Path

import frida

session = frida.attach(0)
script = session.create_script("""
rpc.exports = {
  mainModule() {
    const { base, name } = Process.mainModule;
    return [name, base.toString()];
  },
  read(address, size) {
    return ptr(address).readByteArray(size);
  },
};
""")
script.load()

name, base = script.exports_sync.main_module()
base = int(base, 16)
data = script.exports_sync.read(base, 4096)

module = frida.PatternCompiler().compile(Path("macho.hexpat").read_text(),
                                         platform="darwin", arch="arm64")
assert len(module.diagnostics) == 0

macho = module.decode("MachO", data, base)
header = macho.fields[0]
print(f"{name} @ {macho.address:#x}")
for field in header.fields:
    print(f"  {field.name:<11} {field.type_name:<10} "
          f"{field.label or field.value!s:<10} {field.color or ''}")
commands = macho.fields[1]
print(f"  {commands.name}: {commands.count} load commands, "
      f"{commands.size} bytes")
$ python3 decode.py
Python @ 0x104ec0000
magic le u32 4277009103 FF8800
cputype CpuType ARM64
cpusubtype le u32 0
filetype FileType Execute
ncmds le u32 20
sizeofcmds le u32 1232
flags le u32 2097285
reserved le u32 0
commands: 20 load commands, 1232 bytes解码后的树包含 UI 所需的一切:每个值的地址、偏移量和大小,枚举标签,[[format]] 输出,[[comment]]、[[color]],以及模式附加的任何可视化器及其求值后的参数。 具体如何渲染由工具决定。模块还会描述已声明的类型及其字段、偏移量和大小,因此无需 解码任何内容即可构建类型浏览器。模式可以声明 in 变量,解码时按名称提供;如果模式 附加了 button 可视化器,call_function() 可用于按下它。编译错误不会抛出异常, 而是连同行号和列号放入 diagnostics,以便显示在编辑器中。
说到编辑器:17.18.0 引入的 Frida.LanguageServer API 现在也支持 .hexpat 和 .pat 文档,提供诊断、补全、悬停信息、文档符号、折叠范围、语义 token、跳转到定义, 以及 [[color]] 属性的色板。补全功能了解 std 库和可视化器名称。编写导入模式的 TypeScript agent 时,生成的声明还会免费带来字段补全。
Luma
在即将发布的版本中,Frida 官方 GUI Luma 已经用上了上述所有功能。Luma 的侧边栏 新增 Patterns 区域,用于存放模式和共享库,并配有语言服务器支持的编辑器:
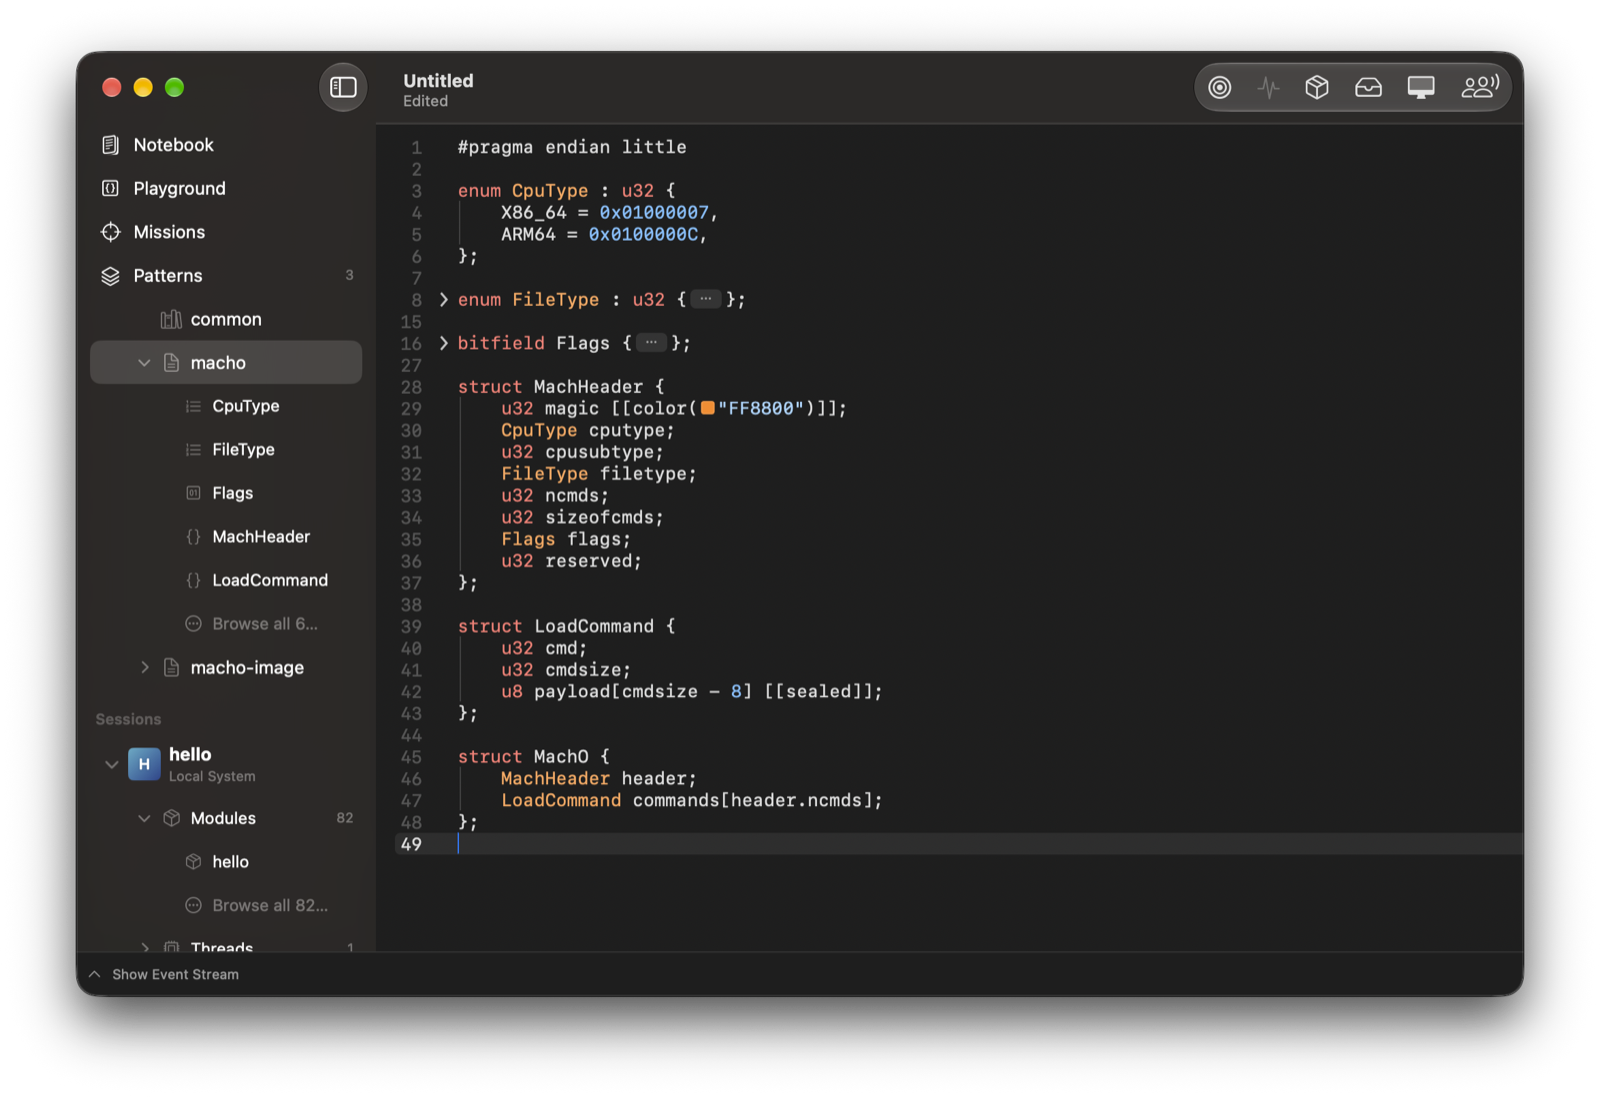
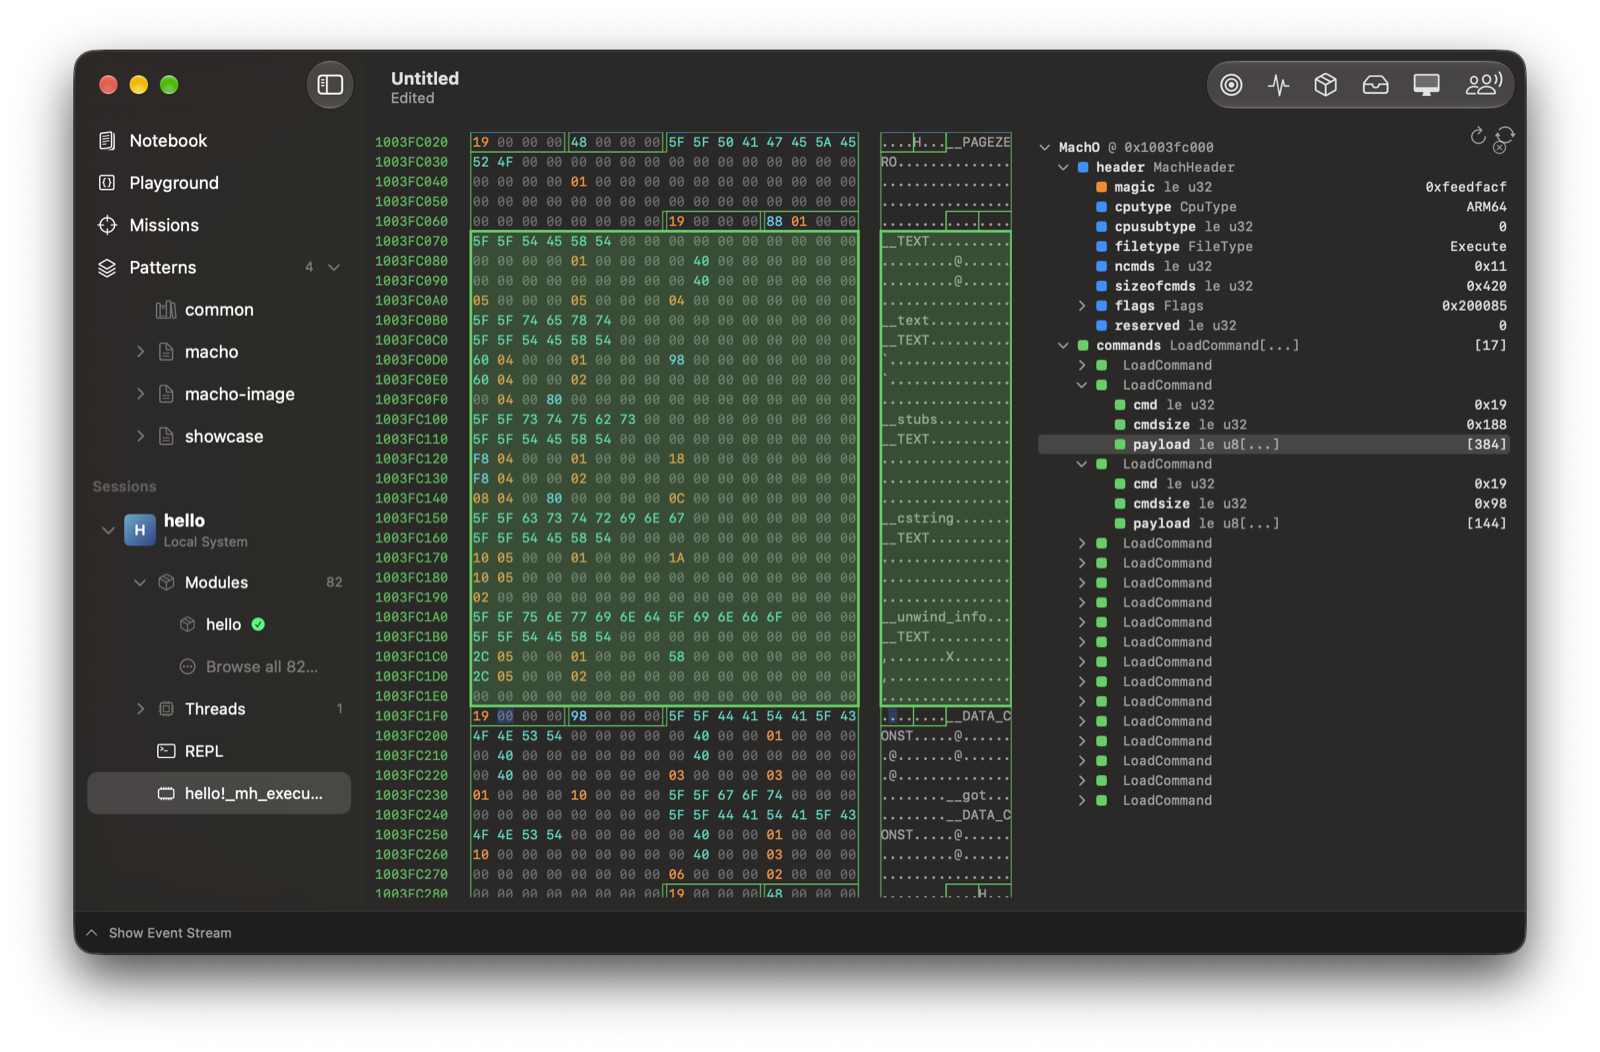
每个文件展开后都会显示它声明的类型,因此可以直接跳转到结构体。无论十六进制视图来自 内存洞察还是 REPL hexdump,都会获得“Decode at … as…”上下文菜单,其中列出模式库中的 类型。选择一种类型后,各字段对应的字节会亮起彩色轮廓,旁边的树则显示名称、类型和值。 单击某个字节会选中它所属的字段,选择字段则会将十六进制视图滚动到对应位置。下面是直接 从运行中进程解码出的 Mach-O 头:
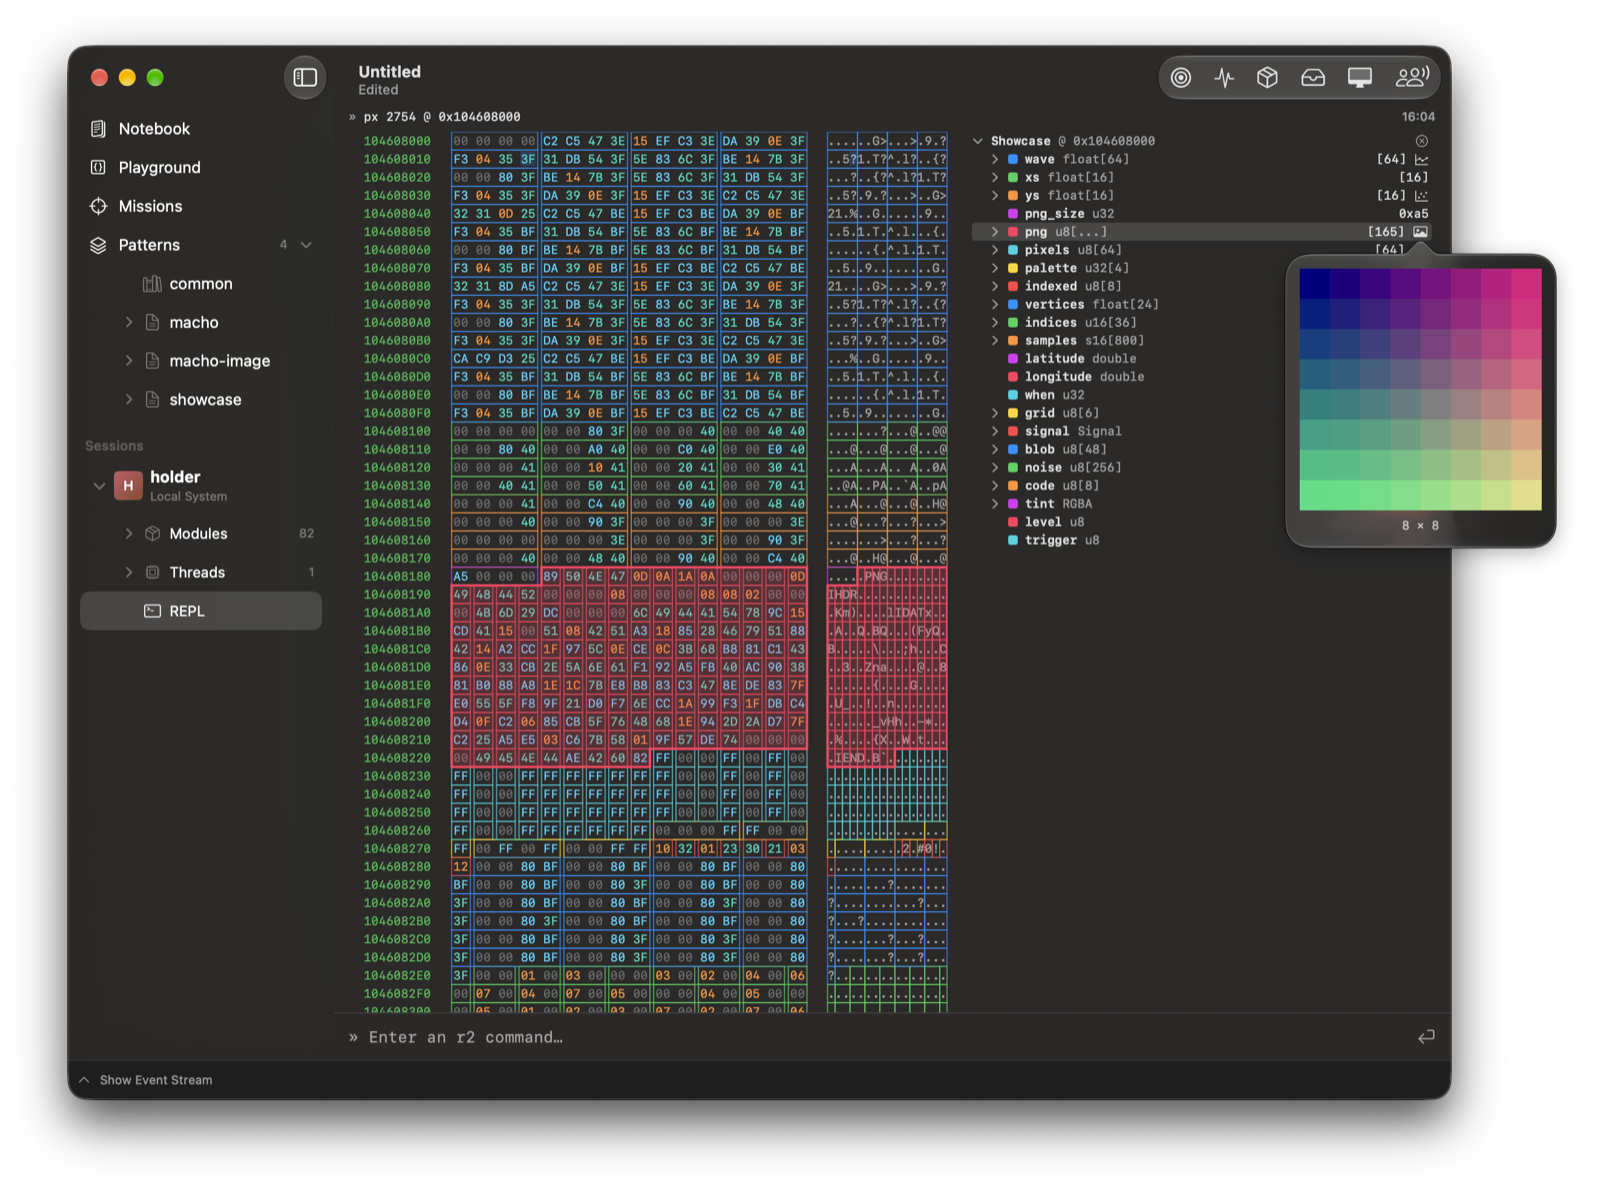
真正有趣的是可视化器。模式语言允许给字段附加可视化器,例如图像、折线图、3D 模型、 地图坐标、音频采样、时间戳、以数字信号显示的位域或反汇编,而 Luma 会将它们渲染出来:
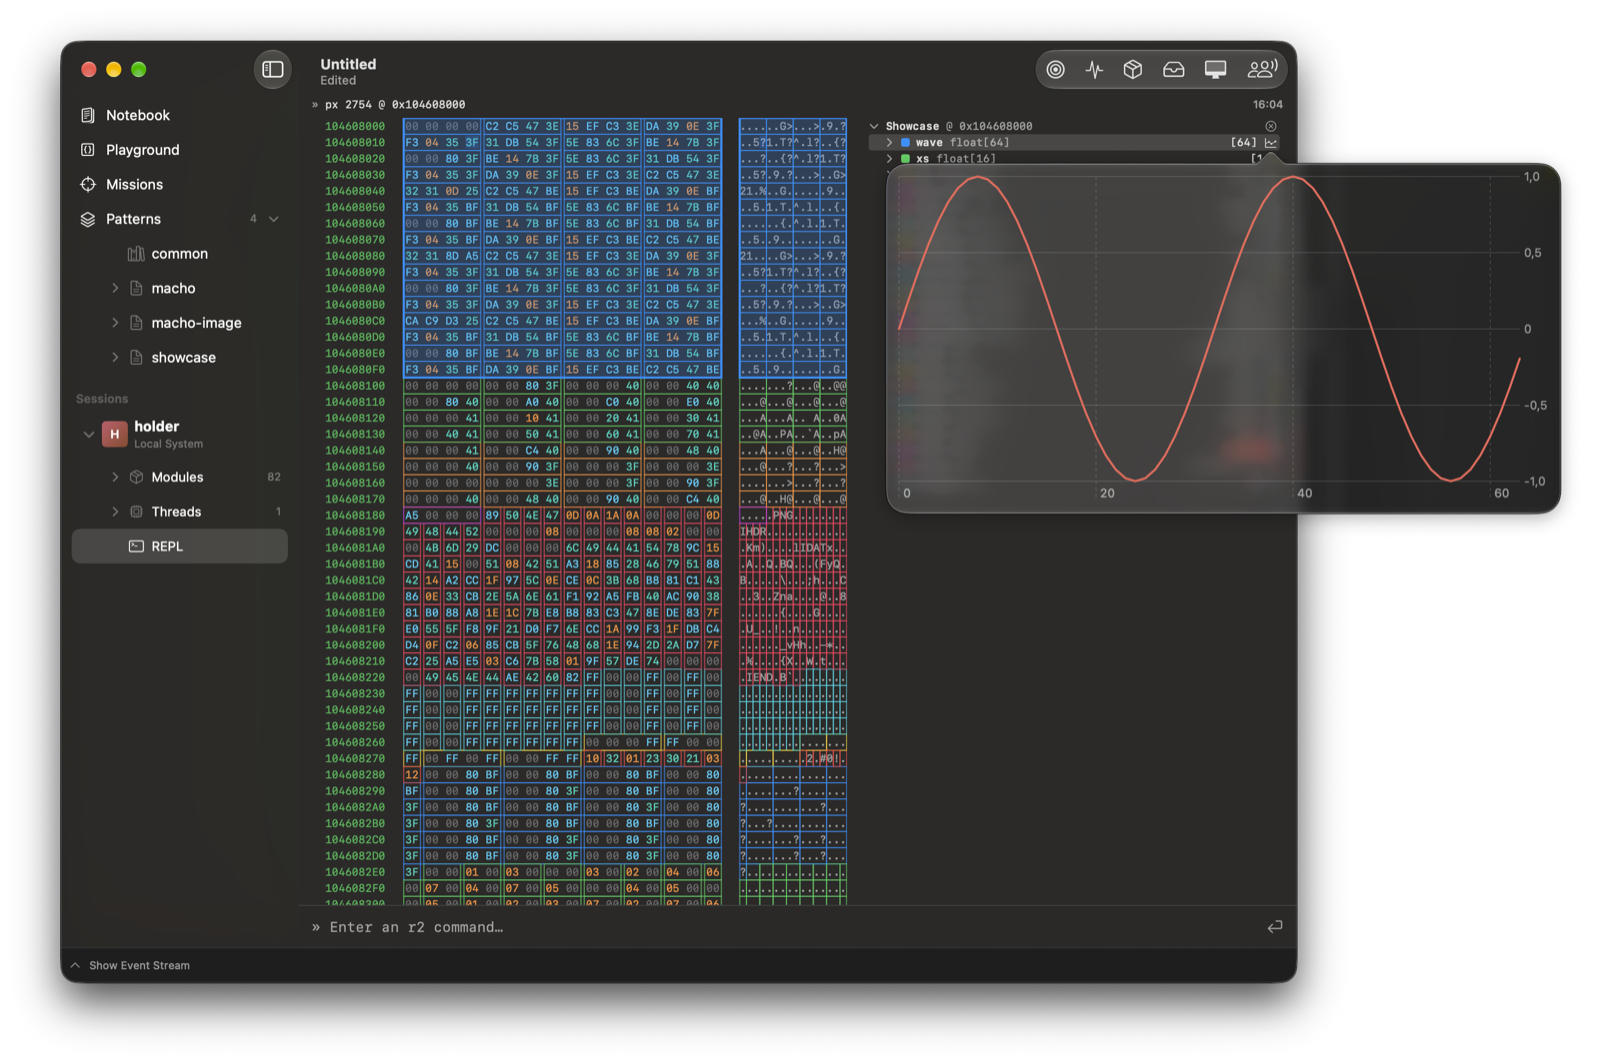
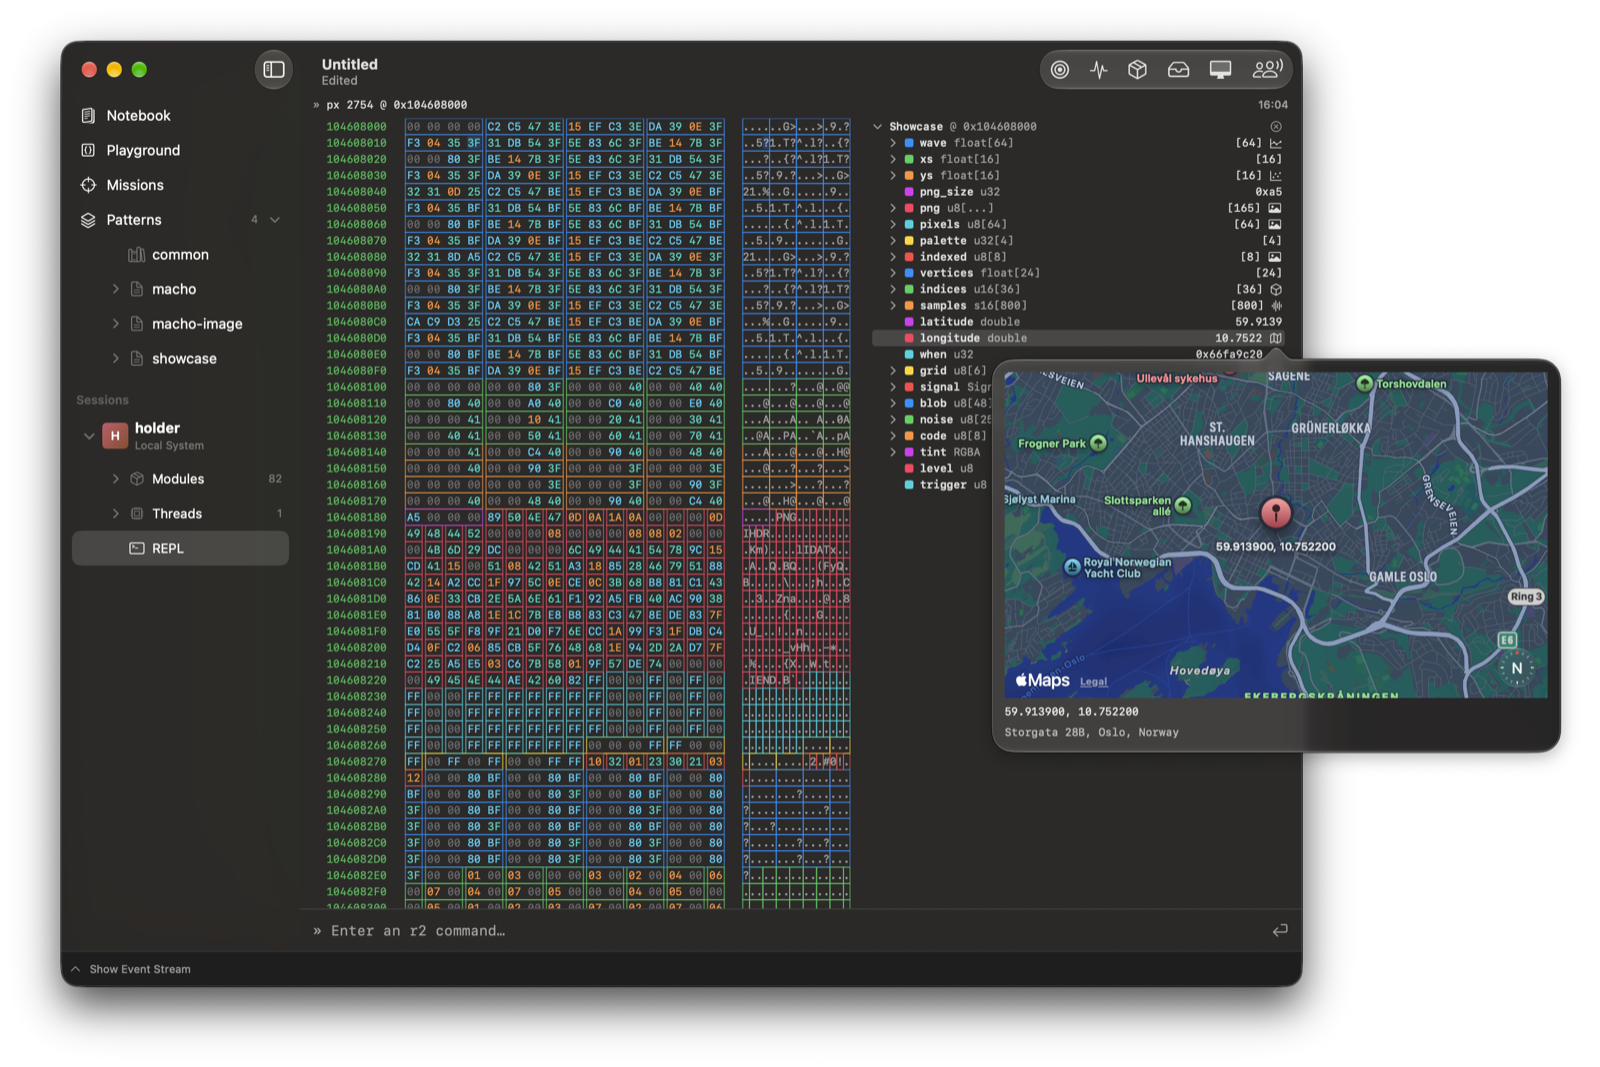
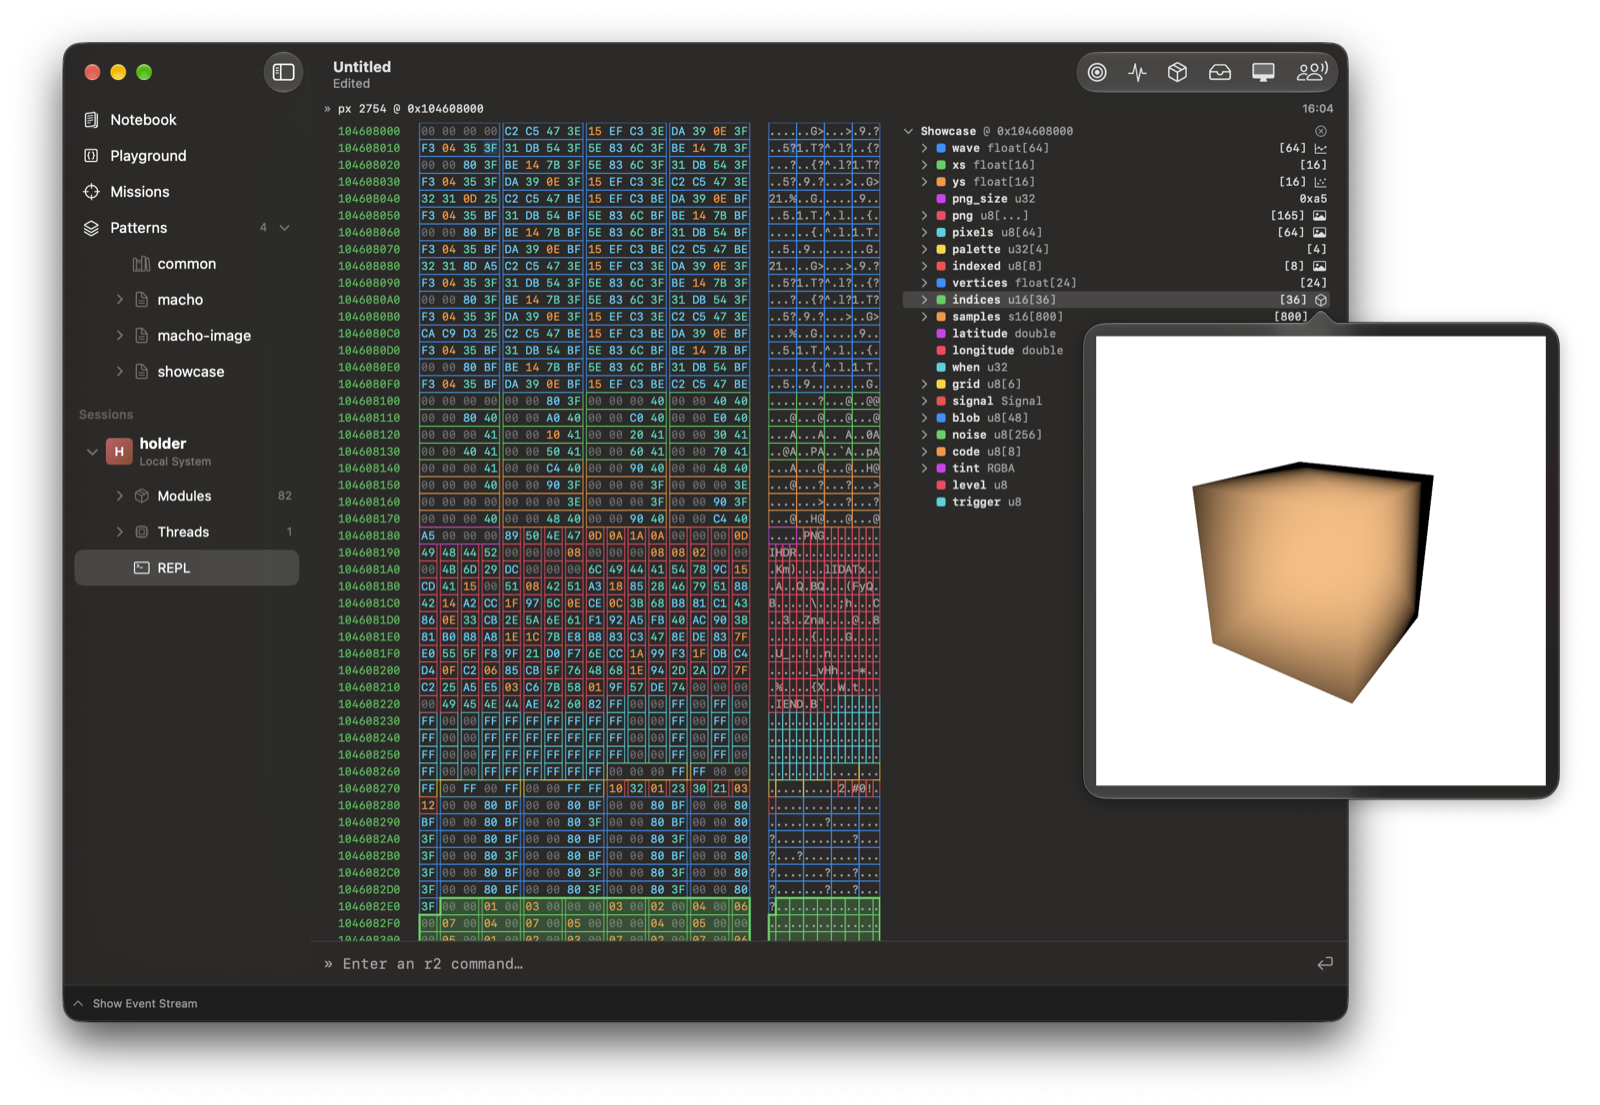
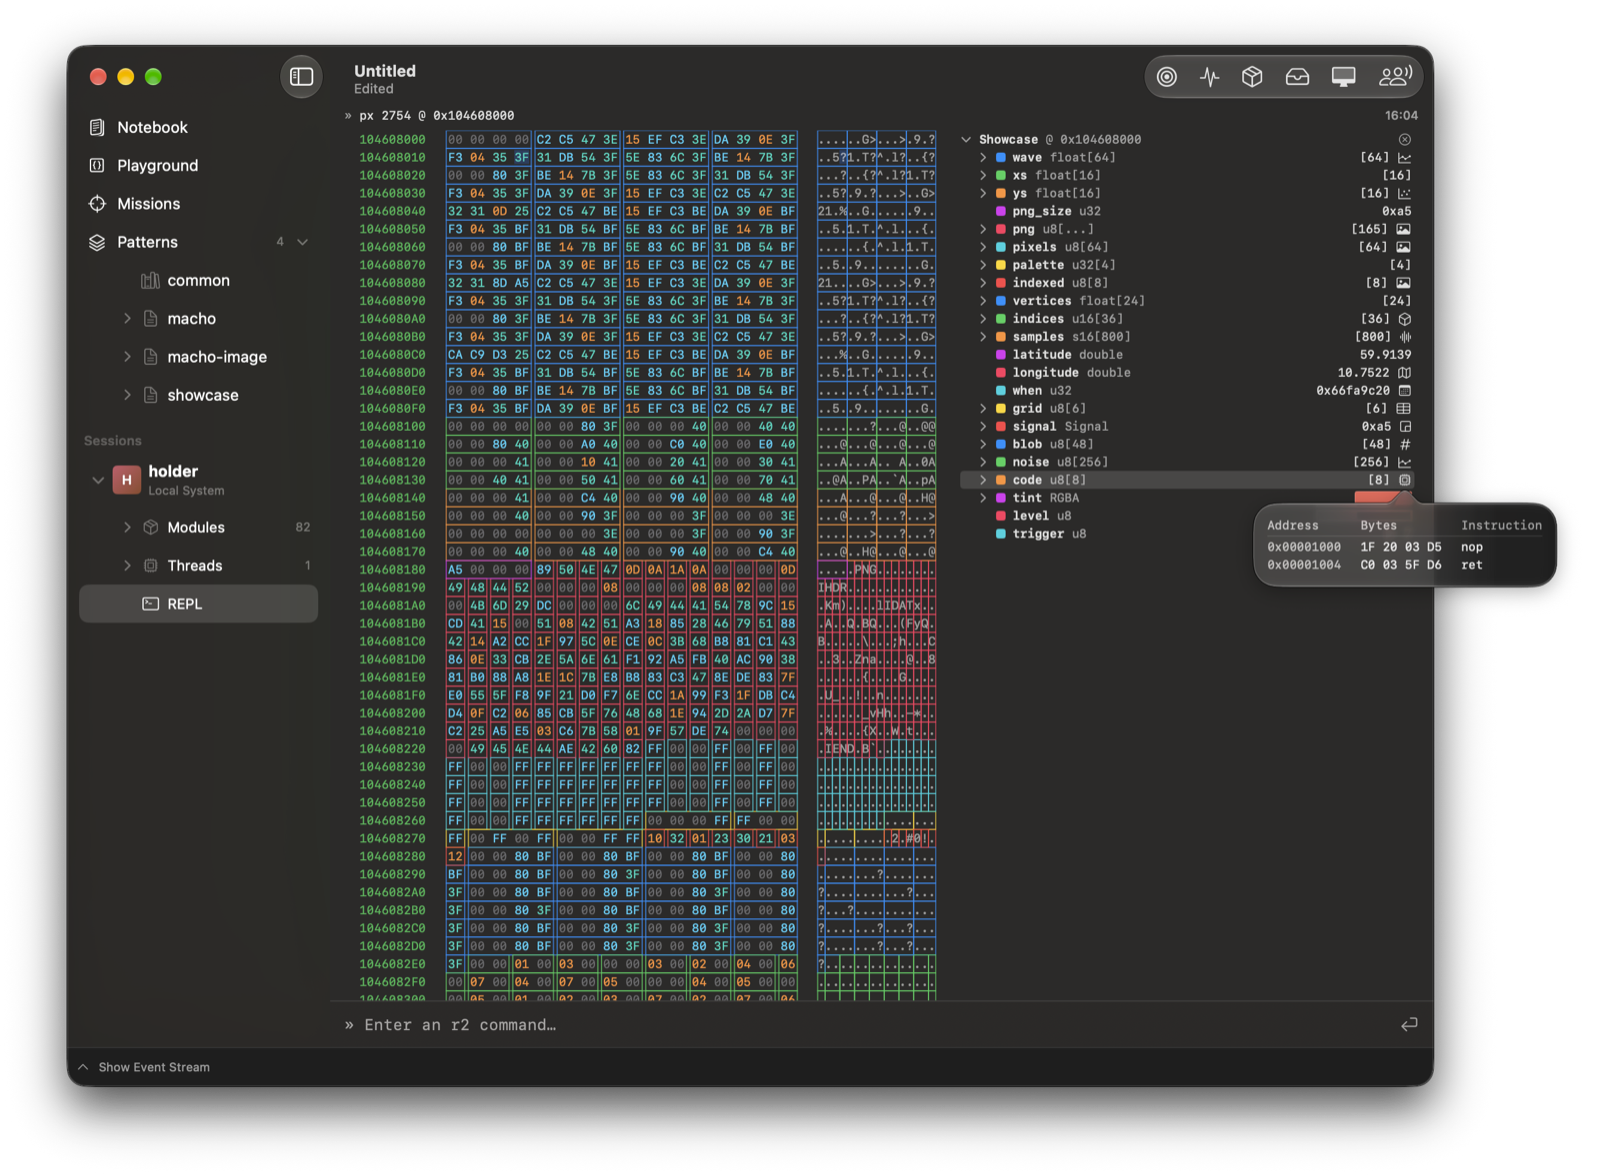
由于 Luma 的 REPL、自定义仪器和 tracer hook 都通过 Frida.Compiler 编译,它们会获得与 上面所写 agent 相同的能力:导入一个模式,即可得到实时视图、用于扫描的 pattern()、 支持完整语言的 parse(),以及输入时的字段补全。
结语
本次发布还有许多其他变更,务必查看下面的变更日志。
尽情享用吧!
变更日志
- compiler:添加 ImHex 模式语言支持。(上文已详细介绍。)
- gumjs:允许 NativePointer 的读写操作接收可选偏移量,例如 p.readU32(4),从而无需 为字段地址分配 NativePointer 即可访问字段。生成的模式视图底层也采用这种方式。
- gumjs:让 writeVolatile() 返回指针,以便与其他写入方法保持一致。
- api-resolver:当导出查询是字面量前缀加末尾通配符(如 exports:*!pthread_*)时,沿 Darwin 导出 trie 向下查找,而不再枚举每个匹配 模块的所有导出。在加载 676 个模块时,243 次此类查询从 35 秒缩短到 65 毫秒。 感谢 @hsorbo!
- swift-api-resolver:使用 Swift 进程中始终存在的 libswiftCore 所提供的 swift_demangle() 进行反修饰,不再使用通常未加载的 libswiftDemangle。解析过程 也改为延迟执行,因此 libswiftCore 加载后解析器便会开始工作。感谢 @hsorbo!
- arm64:限制重定位器的可达性扫描。此前每个块都会重置 1024 字节预算,导致扫描无限 跟随分支目标;在 Android 上,这会让挂钩分支繁多的代码时,每个目标耗费数百毫秒。
- exceptor:不再在每次 try 时保存信号掩码;这一步并非必需,却会让每次尝试产生一次 系统调用。
- payload:修复 Android agent 加载时崩溃的问题。原因是模块注册表在 libc shim 建立 stdio 注册表之前读取了 /proc/self/auxv。
- barebone:将 macOS Android 模拟器提升为一等目标。shim 已重写为 CModule,使热路径 能够无锁运行;现在会恢复所有核心、将寄存器直接推送到 vcpu、处理被捕获的调试寄存器 访问而不再中止虚拟机,并在原生层过滤空闲调度器命中。现在也可以枚举和启动应用。
- barebone:将 agent 注入 SMP arm64 Linux;在 Linux 上报告线程状态和寄存器;根据 cmdline 命名 Linux 进程;并避免将 arm64 副本放在大页上。
- linux-kernel-image:从 32 位内核和 VA_BITS=48 的 arm64 内核中提取 kallsyms, 包括长度超过 80 个字符的 Rust 符号名。
- barebone:修复不带 Droidy 后端时的构建,以及 32 位 Arm 构建。
- base:不在 API 中暴露 Posix 类型,使 frida-base 使用者不再需要 posix.vapi。
- compiler:在 Windows 上使用 cgo 构建时优先选择 UCRT64,并针对每种 flavor 探测 MinGW 编译器。
- node:转义参数名中的保留字,并将从对象构造的 options 中的 GValue 清零。
- python:将 null variant 编组为 None。
- swift:绑定模式编译器类型以及 variant、列表和字典;释放拥有所有权的返回值; 并使用其 C 类型声明 out 参数,使 UInt64 out 参数能在 LP64 Linux 上编译。